2030-க்குள் AI வீடியோக்கள் 75 மடங்கு அதிகமாக உமிழக்கூடும்
ஒரு வாக்கியத்தைத் தட்டச்சு செய்யுங்கள், ஒரு வீடியோத் துண்டு கிடைக்கும்: உரையிலிருந்து வீடியோ உருவாக்கம் (text-to-video) இப்போது வணிக அளவில் இயங்குகிறது. ஒரு துண்டுக்கான அதன் செலவு அதிகம் என்பது ஏற்கெனவே தெரிந்ததுதான். Delavande மற்றும் சக ஆய்வாளர்களின் முந்தைய ஆய்வு ஒன்றின்படி, உரையிலிருந்து ஒரு குறுகிய வீடியோவை உருவாக்க ஏறக்குறைய 90 வாட்-மணி தேவைப்படுகிறது — ஒரு படத்துக்குத் தேவையானதைவிடக் கிட்டத்தட்ட 30 மடங்கு, ஓர் எளிய உரை வகைப்படுத்தல் பணியைவிட 45,000 மடங்கு. மேலும், இந்தத் துண்டுகள் பயனரின் சொந்தச் சாதனத்தில் உருவாக்கப்படுவதில்லை: ஒவ்வொரு கோரிக்கையும் தரவு மையங்களில் உள்ள AI சில்லுகளின் அடுக்குகளில் (racks) இயங்குகிறது.
ஆனால் ஒரு துண்டுக்கான செலவு, மொத்தத்தைப் பற்றிச் சிறிதே சொல்கிறது. எத்தனை துண்டுகள் உருவாக்கப்படுகின்றன, அதற்கு என்ன வன்பொருள் தேவை, குளிர்விப்புக்கு எவ்வளவு நீர் பயன்படுகிறது என்பதை அது சொல்வதில்லை. மேலும், மொத்தத் தடம் வளரும் அதே வேளையில், ஒரு துண்டுக்கான செயல்திறன் மேம்படக்கூடும்.
லீல் பல்கலைக்கழகத்தைச் (University of Lille) சேர்ந்த Tristan Coignion, போர்தோவில் (Bordeaux) உள்ள A. Bugeau, G. Guennebaud, பாரிஸ்-சக்லேவில் (Paris-Saclay) உள்ள A.-L. Ligozat ஆகியோருடன் இணைந்து, உலகளவில் AI வீடியோ உருவாக்கத்தின் முழுத் தடத்தையும் — 2026-க்கும், 2030 வரையும் — மதிப்பிட முனைந்தனர்.
துண்டுகளை எண்ணுதல்
வழங்குநர்கள் தாங்கள் எத்தனை வீடியோக்களை உருவாக்குகிறோம் என்று அரிதாகவே சொல்கின்றனர்; எனவே குழு தன்னால் இயன்றதை அளந்தது. OpenAI-இன் வீடியோ சேவையான Sora-வின் பொது ஊட்டத்தை, 2026 பிப்ரவரி முதல் ஏப்ரல் வரை 54 நாட்கள் அது வலைவலம் (crawl) செய்தது: 3.3 மில்லியன் பொது வீடியோக்கள், அதாவது சுமார் ஆண்டுக்கு 22 மில்லியன். அதன் பிறகு விரைவிலேயே OpenAI, Sora-வின் இணைய மற்றும் செயலிச் சேவைகளை மூடியது. குழு HeyGen-இன் நேரடிக் கணக்கியையும் 90 நாட்கள் பின்தொடர்ந்தது: தனிப்பட்ட வீடியோக்கள் உட்பட, சுமார் ஆண்டுக்கு 111 மில்லியன் வீடியோக்கள்.
வேறு ஆறு வழங்குநர்கள் தங்கள் சொந்த எண்ணிக்கைகளை வெளியிடுகின்றனர். அவற்றில் மற்ற அனைத்தையும்விட மிகப் பெரியது Grok Imagine: ஆண்டுக்குச் சுமார் 3.8 பில்லியன். கூட்டினால், இவை சுமார் ஆண்டுக்கு 6.2 பில்லியன் வீடியோக்கள் என்ற கவனிக்கக்கூடிய மொத்தத்தைத் தருகின்றன. மாதிரி, தனது 2026 அளவை 6.2 முதல் 9.5 பில்லியன் வரையிலான வரம்பிலிருந்து எடுக்கிறது; இடைநிலை மதிப்பு (median) 7.16 பில்லியன்.
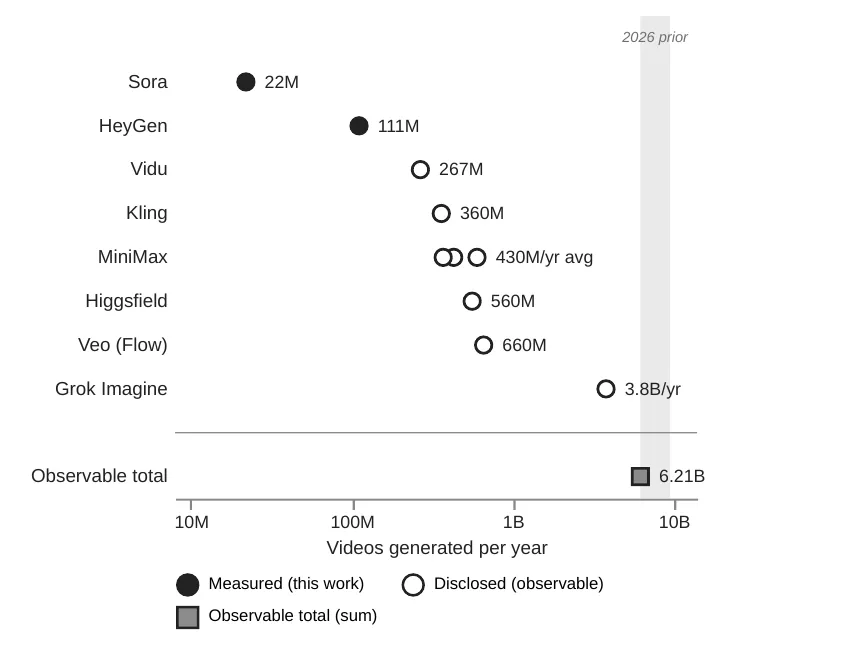
சேவை வாரியாக ஆண்டுதோறும் உருவாகும் AI வீடியோக்கள்: நிரப்பப்பட்ட புள்ளிகள் குழுவால் அளக்கப்பட்டவை, வெற்றுப் புள்ளிகள் வழங்குநர்களால் வெளியிடப்பட்டவை; நிழலிட்ட பட்டை 2026-க்கான மாதிரியின் வரம்பு. — படம் 1, Coignion et al. (2026), arXiv:2611.17938.
2026-இன் கணக்கு
அங்கிருந்து, ஒரு கீழிருந்து மேலான (bottom-up) மாதிரி தேவையான AI சில்லுகளின் தொகுதியை அளவிடுகிறது; பின்னர் மின்சாரம், நீர், பசுமைக்குடில் வாயுக்கள், கனிம வளங்கள் தீர்ந்துபோதல் ஆகியவற்றைக் கணக்கிடுகிறது; நிச்சயமின்மையைப் படம்பிடிக்க 10,000 உருவகப்படுத்தல்களை (simulations) இயக்குகிறது. பயிற்சியும் (training) சேமிப்பும் சேர்க்கப்பட்டுள்ளன; ஒலியும், பார்வையாளர்களுக்கு வீடியோக்களை ஓடை ஒளிபரப்புவதும் (streaming) சேர்க்கப்படவில்லை.
2026-க்கு, இடைநிலை முடிவு: 72,600 வரைகலைச் செயலிகள் (graphics processors) கொண்ட ஒரு தொகுதி, 724 கிகாவாட்-மணி மின்சாரம், CO₂-க்கு இணையான 124,300 டன். கோளின் காலநிலை வரம்பைத் தாண்டாமல் மனிதகுலம் ஒவ்வோர் ஆண்டும் உமிழக்கூடிய பசுமைக்குடில் வாயுக்களை எடுத்து, ஒவ்வொருவருக்கும் சமமாகப் பகிர்ந்தளித்தால்: 124,300 டன் என்பது சுமார் 126,000 பேரின் ஆண்டு ஒதுக்கீடு.
ஒரு வீடியோவுக்கு, எல்லாம் சேர்த்த செலவு சுமார் 100 வாட்-மணி — ஓர் உருவாக்கத்துக்குச் சில்லு மட்டுமே செலவிடும் 24.4 வாட்-மணியின் 4.1 மடங்கு. செயலற்ற நேரம், கட்டட மேல்செலவுகள் (overheads), பயிற்சி, சேமிப்பு ஆகியவை அந்த வேறுபாட்டை உருவாக்குகின்றன. வீடியோக்களை உருவாக்குவது உமிழ்வுகளில் சுமார் 69%, மாதிரிகளுக்குப் பயிற்சி அளிப்பது 31%, சேமிப்பு கிட்டத்தட்ட எதுவுமில்லை. மேலும், எவ்வளவு மின்சாரம் பயன்படுத்தப்படுகிறது என்பதைவிட, அது எங்கிருந்து வருகிறது என்பதே முக்கியம்: உமிழ்வுகளைப் பொறுத்தவரை, மின் கட்டமைப்பின் கார்பன் செறிவு (carbon intensity), வீடியோக்களின் எண்ணிக்கையைவிட 12 மடங்கு அதிக எடை கொண்டது.
மூன்று எதிர்காலங்கள்
பின்னர் மாதிரி, மூன்று சூழ்நிலைகளின் கீழ் 2030 வரை இயங்குகிறது; அனைத்திலும் ஒரே சீரான தொழில்நுட்ப முன்னேற்றம்: புதிய, அதிகச் செயல்திறன் கொண்ட சில்லுகள், ஒவ்வோர் ஆண்டும் சுமார் 10% அதிகச் செயல்திறன் பெறும் மென்பொருள்.
- குறிப்பு நிலை (reference): வீடியோக்களின் எண்ணிக்கை 2027, 2028, 2029-இல் இரட்டிப்பாகிறது, பின்னர் 2030-இல் 60% வளர்கிறது — மொத்தத்தில் 12.8 மடங்கு; வேண்டுமென்றே தேர்ந்தெடுக்கப்பட்ட மிதமான பாதை. உமிழ்வுகள் 74 மடங்கு வளர்ந்து, 2030-இல் சுமார் 9.2 மில்லியன் டன் அளவை எட்டுகின்றன: சுமார் 9.3 மில்லியன் பேரின் ஒதுக்கீடு. தேவையைவிட ஏன் வேகமாக? வீடியோக்கள் நீளமாகவும் கூர்மையாகவும் ஆகின்றன; எனவே ஒரு வீடியோவுக்கான ஆற்றல் 24.4-இலிருந்து 214 வாட்-மணியாக உயர்கிறது.
- பயன்பாட்டுத் தேக்கம்: எண்ணிக்கை, தெளிவுத்திறன் (resolution), கால அளவு ஆகியவை 2026 நிலையிலேயே இருக்கின்றன. உமிழ்வுகள் சுமார் ஐந்தில் இரண்டு பங்கு குறைகின்றன. அவை குறையும் ஒரே சூழ்நிலை இதுதான்.
- பெருந்திரள் பயன்பாடு (mass adoption): எண்ணிக்கை 60 மடங்கு வளர்கிறது. உமிழ்வுகள் 42.9 மில்லியன் டன் அளவை எட்டுகின்றன — சுமார் 44 மில்லியன் பேரின் ஒதுக்கீடு.
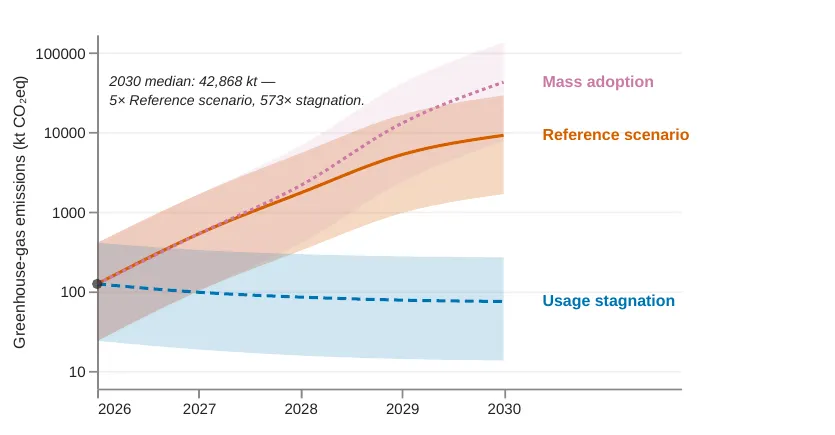
மூன்று சூழ்நிலைகளின் கீழ் உமிழ்வுகள், 2026–2030; கோடுகள் இடைநிலை மதிப்புகள், பட்டைகள் 5–95% வரம்பு. — படம் 6, Coignion et al. (2026), arXiv:2611.17938.
செயல்திறன் ஈடுகொடுக்காது
குழு மாதிரியைப் பின்னோக்கியும் இயக்கியது. குறிப்பு நிலைப் பாதையின் கீழ், ஒவ்வோர் ஆண்டும் 30% செயல்திறன் ஆதாயம் கிடைத்தாலும், 2030 உமிழ்வுகள் 2026-ஐவிட 27.5 மடங்கு அதிகமாகவே இருக்கும். உமிழ்வுகளை மாறாமல் வைத்திருக்க, சுமார் ஆண்டுக்கு 75% தேவைப்படும் — மாதிரி அனுமானிக்கும் 10%-இன் ஏறக்குறைய ஏழு மடங்கு; நடைமுறைப் பயன்பாட்டில் உள்ள (production) எந்த மாதிரியிலும் அளக்கப்பட்ட மிகச் சிறந்த செயல்திறனுக்கும் அப்பாற்பட்டது. பாரிஸ் ஒப்பந்தத்துடன் ஒத்துப்போகும், டிஜிட்டல் துறையின் சொந்த இலக்கு, 2020 முதல் 2030 வரை உமிழ்வுகளில் 45% குறைப்பைக் கோருகிறது.
ஓர் அடித்தளம், உச்சவரம்பு அல்ல
ஆசிரியர்கள் இந்த எண்ணிக்கைகள் அனைத்தையும் கீழ் வரம்புகளாக முன்வைக்கின்றனர். உருவாக்க மாதிரி 2030 வரை மாறாமல் வைக்கப்படுகிறது; உண்மையான மாதிரிகளோ அதிகத் தேவையுடையவையாக வளர வாய்ப்புள்ளது; ஓடை ஒளிபரப்பு, ஒலி, பிற AI பயன்பாடுகள் விடுபட்டுள்ளன; மிகக் குறைவாக ஆவணப்படுத்தப்பட்ட பகுதியான பயிற்சி, சில சிறிய திறந்த மாதிரிகளைக் கொண்டு அளவீடு செய்யப்பட்டுள்ளது. Sora-வின் மூடல் காட்டியதைப் போல், பயன்பாடு வேகமாகச் சுருங்கவும் கூடும். ஆனால் ஆய்வுக் கட்டுரையின் எண்களின்படி, வீடியோக்களின் எண்ணிக்கை அல்லது அவற்றின் தரம் வளர்வது நிற்கும்போது மட்டுமே தடம் வளர்வது நிற்கிறது.