2030 तक AI वीडियो 75 गुना ज़्यादा उत्सर्जन कर सकते हैं
एक वाक्य टाइप कीजिए, एक वीडियो क्लिप पाइए: पाठ से वीडियो बनाना अब व्यावसायिक पैमाने पर चल रहा है। यह पहले से ज्ञात है कि प्रति क्लिप इसकी लागत ऊँची है। Delavande और सहयोगियों के एक पुराने अध्ययन के अनुसार, पाठ से एक छोटा वीडियो बनाने में मोटे तौर पर 90 वाट-घंटे लगते हैं, जो एक छवि से लगभग 30 गुना और पाठ-वर्गीकरण के एक साधारण काम से 45,000 गुना है। और क्लिप उपयोगकर्ता के अपने उपकरण पर नहीं बनतीं: हर अनुरोध डेटा केंद्रों में AI चिप्स के रैकों पर चलता है।
लेकिन प्रति क्लिप लागत कुल के बारे में बहुत कम बताती है। वह यह नहीं बताती कि कितनी क्लिप बनती हैं, उसके लिए कौन-सा हार्डवेयर चाहिए, या ठंडा करने में कितना पानी लगता है। और प्रति क्लिप दक्षता सुधर सकती है, जबकि कुल पदचिह्न बढ़ता रहे।
लील विश्वविद्यालय (University of Lille) में Tristan Coignion ने, बोर्दो में A. Bugeau और G. Guennebaud तथा Paris-Saclay में A.-L. Ligozat के साथ, दुनिया भर में AI वीडियो निर्माण के पूरे पदचिह्न का अनुमान लगाने का बीड़ा उठाया — 2026 के लिए और 2030 तक।
क्लिपों की गिनती
प्रदाता शायद ही कभी बताते हैं कि वे कितने वीडियो बनाते हैं, इसलिए टीम ने वह मापा जो वह माप सकती थी। उसने फ़रवरी और अप्रैल 2026 के बीच 54 दिनों तक OpenAI की वीडियो सेवा Sora की सार्वजनिक फ़ीड को क्रॉल किया: 3.3 मिलियन सार्वजनिक वीडियो, यानी लगभग 22 मिलियन प्रति वर्ष। इसके कुछ ही समय बाद OpenAI ने Sora के वेब और ऐप अनुभव बंद कर दिए। टीम ने 90 दिनों तक HeyGen के लाइव काउंटर पर भी नज़र रखी: लगभग 111 मिलियन वीडियो प्रति वर्ष, निजी वीडियो सहित।
छह अन्य प्रदाता अपनी गिनती ख़ुद प्रकाशित करते हैं। इनमें कहीं सबसे बड़ा Grok Imagine है, लगभग 3.8 अरब प्रति वर्ष के साथ। जोड़ने पर ये लगभग 6.2 अरब वीडियो प्रति वर्ष का प्रेक्षणीय योग देते हैं। मॉडल 2026 के लिए अपनी मात्रा 6.2 और 9.5 अरब के बीच से लेता है, जिसकी माध्यिका 7.16 अरब है।
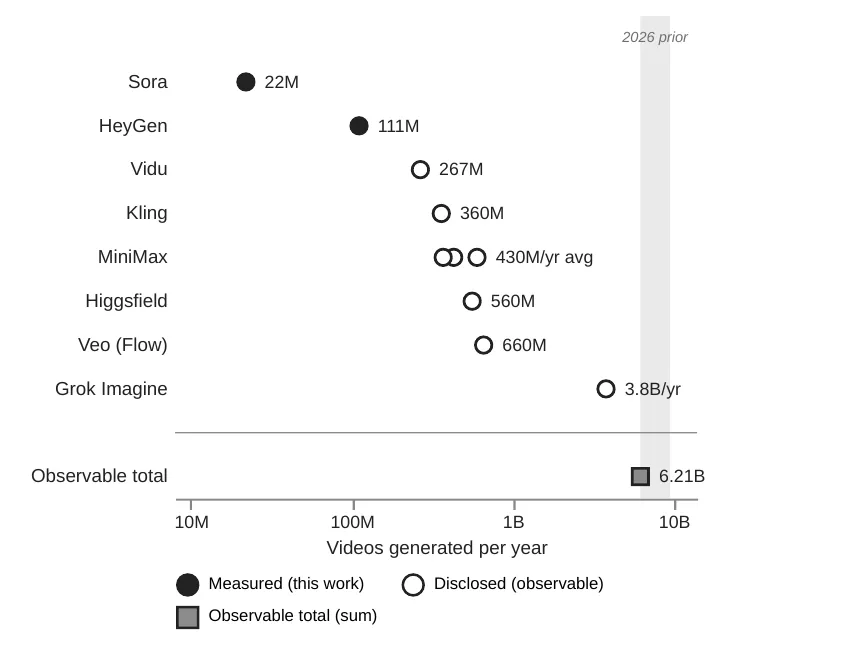
हर सेवा के सालाना AI वीडियो: भरे बिंदु टीम द्वारा मापे गए, खुले बिंदु प्रदाताओं द्वारा बताए गए; छायांकित पट्टी 2026 के लिए मॉडल का दायरा है। — चित्र 1, Coignion et al. (2026), arXiv:2611.17938.
2026 का बिल
वहाँ से, एक नीचे-से-ऊपर (bottom-up) मॉडल ज़रूरी AI चिप्स के बेड़े का आकार तय करता है, फिर उससे बिजली, पानी, ग्रीनहाउस गैसें और खनिज संसाधनों का क्षय निकालता है, और अनिश्चितता को पकड़ने के लिए 10,000 सिमुलेशन चलाता है। प्रशिक्षण और भंडारण शामिल हैं; ध्वनि, और दर्शकों तक वीडियो की स्ट्रीमिंग, शामिल नहीं हैं।
2026 के लिए माध्यिका परिणाम है 72,600 ग्राफ़िक्स प्रोसेसरों का बेड़ा, 724 गीगावाट-घंटे बिजली और 124,300 टन CO₂ समतुल्य। मानवता ग्रह की जलवायु सीमा पार किए बिना हर साल जितनी ग्रीनहाउस गैसें उत्सर्जित कर सकती है, उन्हें लीजिए और प्रति व्यक्ति बराबर बाँटिए: 124,300 टन लगभग 126,000 लोगों का सालाना कोटा है।
प्रति वीडियो, सब कुछ मिलाकर लागत लगभग 100 वाट-घंटे आती है — उन 24.4 वाट-घंटों का 4.1 गुना जो अकेली चिप एक बार वीडियो बनाने में ख़र्च करती है। निष्क्रिय समय, इमारत के अतिरिक्त ख़र्च, प्रशिक्षण और भंडारण यह अंतर पैदा करते हैं। वीडियो बनाना उत्सर्जन का लगभग 69% हिस्सा है, मॉडलों का प्रशिक्षण 31%, भंडारण लगभग कुछ नहीं। और बिजली कहाँ से आती है, यह इससे ज़्यादा मायने रखता है कि कितनी इस्तेमाल होती है: उत्सर्जन के मामले में, बिजली ग्रिड की कार्बन तीव्रता वीडियो की संख्या से 12 गुना ज़्यादा वज़न रखती है।
तीन भविष्य
फिर मॉडल को तीन परिदृश्यों में 2030 तक चलाया जाता है, सभी में एक जैसी स्थिर तकनीकी प्रगति के साथ: नई, ज़्यादा कुशल चिप्स और हर साल लगभग 10% ज़्यादा कुशल सॉफ़्टवेयर।
- संदर्भ: वीडियो की संख्या 2027, 2028 और 2029 में दोगुनी होती है, फिर 2030 में 60% बढ़ती है — कुल मिलाकर 12.8 गुना, जानबूझकर चुनी गई एक संयत राह। उत्सर्जन 74 गुना बढ़ता है और 2030 में लगभग 9.2 मिलियन टन तक पहुँचता है: लगभग 9.3 मिलियन लोगों का बजट। माँग से तेज़ क्यों? वीडियो लंबे और ज़्यादा स्पष्ट हो जाते हैं, इसलिए प्रति वीडियो ऊर्जा 24.4 से 214 वाट-घंटे तक बढ़ जाती है।
- उपयोग में ठहराव: मात्रा, रिज़ॉल्यूशन और अवधि 2026 के स्तर पर बने रहते हैं। उत्सर्जन में लगभग दो-पाँचवें हिस्से की गिरावट आती है। यही एकमात्र परिदृश्य है जिसमें उत्सर्जन घटता है।
- व्यापक अपनाव: मात्रा 60 गुना बढ़ती है। उत्सर्जन 42.9 मिलियन टन तक पहुँचता है — लगभग 44 मिलियन लोगों का बजट।
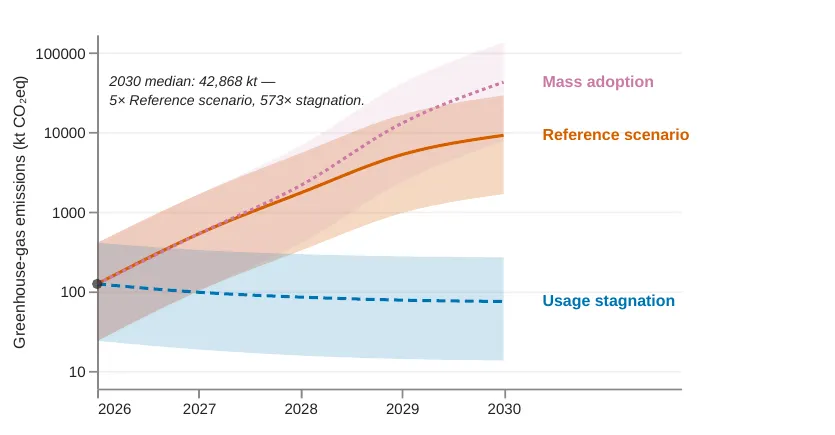
तीनों परिदृश्यों में उत्सर्जन, 2026–2030; रेखाएँ माध्यिकाएँ हैं, पट्टियाँ 5–95% दायरा। — चित्र 6, Coignion et al. (2026), arXiv:2611.17938.
दक्षता बराबरी नहीं कर पाएगी
टीम ने मॉडल को उल्टा भी चलाया। संदर्भ राह में, हर साल 30% दक्षता-लाभ भी 2030 के उत्सर्जन को 2026 से 27.5 गुना ऊपर छोड़ता है। उत्सर्जन को स्थिर रखने के लिए लगभग 75% प्रति वर्ष की ज़रूरत होगी — मॉडल द्वारा मानी गई 10% का लगभग सात गुना, और किसी भी उत्पादन मॉडल पर मापी गई सर्वश्रेष्ठ दक्षता से भी परे। डिजिटल क्षेत्र का अपना लक्ष्य, जो पेरिस समझौते के अनुरूप है, 2020 और 2030 के बीच उत्सर्जन में 45% कटौती की माँग करता है।
फ़र्श, छत नहीं
लेखक इन सभी आँकड़ों को निचली सीमाओं के रूप में पेश करते हैं। वीडियो बनाने वाला मॉडल 2030 तक स्थिर रखा गया है, जबकि असली मॉडल संभवतः और ज़्यादा माँग वाले होते जाएँगे; स्ट्रीमिंग, ध्वनि और AI के अन्य उपयोग छोड़ दिए गए हैं; प्रशिक्षण, जो सबसे कम प्रलेखित हिस्सा है, कुछ छोटे खुले मॉडलों पर अंशांकित है। उपयोग तेज़ी से सिकुड़ भी सकता है, जैसा Sora के बंद होने ने दिखाया। लेकिन शोधपत्र के आँकड़ों के हिसाब से, पदचिह्न का बढ़ना तभी रुकता है जब वीडियो की संख्या, या उनकी गुणवत्ता, भी बढ़ना बंद कर दे।