VIDEO AI CÓ THỂ PHÁT THẢI GẤP 75 LẦN VÀO NĂM 2030
Gõ một câu, nhận về một đoạn video: việc tạo video từ văn bản giờ đây đã vận hành ở quy mô thương mại. Chi phí cho mỗi clip vốn đã được biết là cao. Theo một nghiên cứu trước đó của Delavande và các đồng nghiệp, việc tạo một đoạn video ngắn từ văn bản tiêu tốn khoảng 90 watt giờ, gần 30 lần so với một hình ảnh và 45.000 lần so với một tác vụ phân loại văn bản đơn giản. Và các clip không được tạo ra trên thiết bị của chính người dùng: mỗi yêu cầu chạy trên những dãy tủ chip AI trong các trung tâm dữ liệu.
Nhưng chi phí cho mỗi clip không nói lên được nhiều về tổng thể. Nó không cho biết có bao nhiêu clip được tạo ra, cần phần cứng gì, hay hệ thống làm mát dùng bao nhiêu nước. Và hiệu suất trên mỗi clip có thể cải thiện trong khi tổng dấu chân môi trường lại tăng lên.
Tristan Coignion, tại Đại học Lille, cùng A. Bugeau và G. Guennebaud ở Bordeaux và A.-L. Ligozat ở Paris-Saclay, đã bắt tay ước tính toàn bộ dấu chân môi trường của việc tạo video bằng AI trên toàn thế giới — cho năm 2026 và đến năm 2030.
Đếm các clip
Các nhà cung cấp hiếm khi cho biết họ tạo ra bao nhiêu video, vì vậy nhóm nghiên cứu đo những gì có thể đo. Nhóm đã thu thập tự động luồng công khai của Sora, dịch vụ video của OpenAI, trong 54 ngày từ tháng Hai đến tháng Tư năm 2026: 3,3 triệu video công khai, tức khoảng 22 triệu mỗi năm. Không lâu sau đó, OpenAI đã đóng cửa phiên bản web và ứng dụng của Sora. Nhóm cũng theo dõi bộ đếm trực tiếp của HeyGen trong 90 ngày: khoảng 111 triệu video mỗi năm, tính cả video riêng tư.
Sáu nhà cung cấp khác công bố số liệu của riêng họ. Lớn nhất, bỏ xa các bên còn lại, là Grok Imagine, với khoảng 3,8 tỷ mỗi năm. Cộng lại, các con số này cho tổng số quan sát được vào khoảng 6,2 tỷ video mỗi năm. Mô hình lấy khối lượng năm 2026 trong khoảng từ 6,2 đến 9,5 tỷ, với trung vị là 7,16 tỷ.
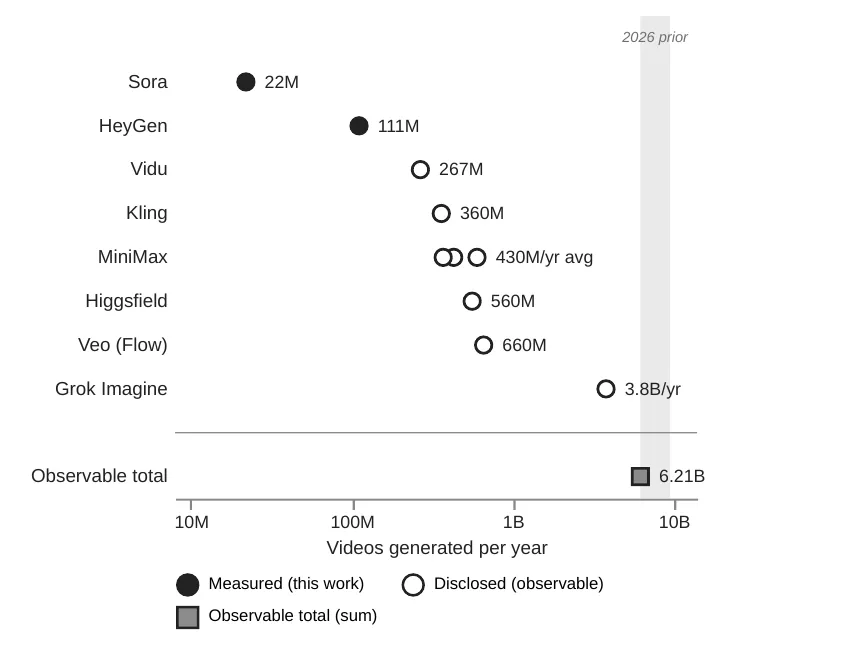
Số video AI mỗi năm theo từng dịch vụ: chấm đặc là số do nhóm đo, chấm rỗng là số do nhà cung cấp công bố; dải tô bóng là khoảng giá trị của mô hình cho năm 2026. — Hình 1, Coignion et al. (2026), arXiv:2611.17938.
Hóa đơn năm 2026
Từ đó, một mô hình từ dưới lên ước tính quy mô đội chip AI cần thiết, rồi suy ra điện năng, nước, khí nhà kính và sự cạn kiệt tài nguyên khoáng sản, với 10.000 lần mô phỏng để nắm bắt độ bất định. Huấn luyện và lưu trữ được tính đến; âm thanh, và việc truyền phát video tới người xem, thì không.
Với năm 2026, kết quả trung vị là một đội 72.600 bộ xử lý đồ họa, 724 gigawatt giờ điện và 124.300 tấn CO₂ tương đương. Lấy lượng khí nhà kính mà nhân loại có thể phát thải mỗi năm mà không vượt quá giới hạn khí hậu của hành tinh rồi chia đều theo đầu người: 124.300 tấn là hạn mức hằng năm của khoảng 126.000 người.
Tính trên mỗi video, chi phí trọn gói vào khoảng 100 watt giờ — gấp 4,1 lần con số 24,4 watt giờ mà riêng con chip tiêu tốn cho một lần tạo. Thời gian chạy không tải, chi phí phụ trội của tòa nhà, huấn luyện và lưu trữ tạo nên phần chênh lệch. Việc tạo video chiếm khoảng 69% lượng phát thải, huấn luyện mô hình 31%, lưu trữ gần như không đáng kể. Và điện đến từ đâu quan trọng hơn lượng điện được dùng: đối với phát thải, cường độ carbon của lưới điện có trọng số gấp 12 lần so với số lượng video.
Ba tương lai
Sau đó mô hình được chạy đến năm 2030 theo ba kịch bản, tất cả đều với cùng một tiến bộ kỹ thuật đều đặn: những con chip mới hơn, hiệu quả hơn, và phần mềm hiệu quả hơn khoảng 10% mỗi năm.
- Tham chiếu: số lượng video tăng gấp đôi vào các năm 2027, 2028 và 2029, rồi tăng 60% vào năm 2030 — tổng cộng 12,8 lần, một lộ trình cố ý chọn ở mức khiêm tốn. Phát thải tăng 74 lần, đạt khoảng 9,2 triệu tấn vào năm 2030: ngân sách của khoảng 9,3 triệu người. Vì sao nhanh hơn nhu cầu? Video ngày càng dài hơn và sắc nét hơn, nên năng lượng cho mỗi video tăng từ 24,4 lên 214 watt giờ.
- Đình trệ sử dụng: khối lượng, độ phân giải và thời lượng giữ nguyên ở mức năm 2026. Phát thải giảm khoảng hai phần năm. Đây là kịch bản duy nhất mà chúng giảm.
- Phổ cập đại trà: khối lượng tăng 60 lần. Phát thải đạt 42,9 triệu tấn — ngân sách của khoảng 44 triệu người.
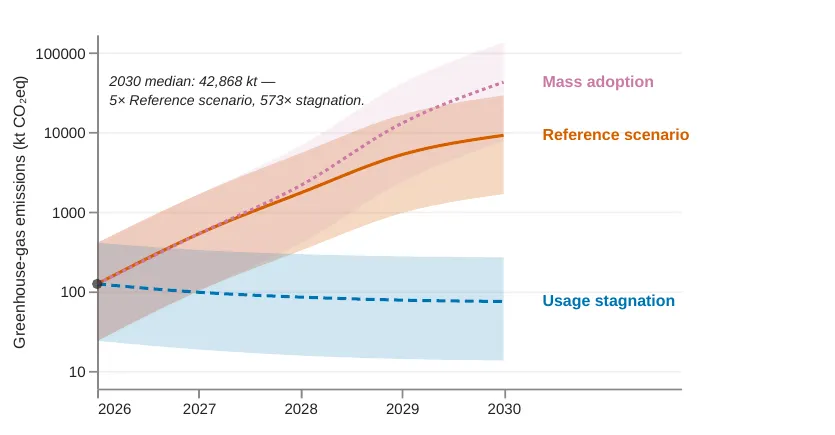
Phát thải theo ba kịch bản, 2026–2030; các đường là trung vị, các dải là khoảng 5–95%. — Hình 6, Coignion et al. (2026), arXiv:2611.17938.
Hiệu suất sẽ không theo kịp
Nhóm nghiên cứu cũng chạy mô hình theo chiều ngược lại. Theo lộ trình tham chiếu, ngay cả mức tăng hiệu suất 30% mỗi năm vẫn khiến phát thải năm 2030 cao gấp 27,5 lần năm 2026. Giữ phát thải không đổi sẽ đòi hỏi khoảng 75% mỗi năm — gấp chừng bảy lần mức 10% mà mô hình giả định, và vượt quá mức hiệu suất tốt nhất từng đo được trên bất kỳ mô hình nào đang vận hành thực tế. Mục tiêu của chính ngành kỹ thuật số, phù hợp với Hiệp định Paris, đòi hỏi cắt giảm 45% phát thải trong giai đoạn 2020 đến 2030.
Một mức sàn, không phải mức trần
Các tác giả trình bày tất cả những con số này như các giới hạn dưới. Mô hình tạo video được giữ cố định đến năm 2030, trong khi các mô hình thực tế nhiều khả năng sẽ ngày càng đòi hỏi nhiều tài nguyên hơn; truyền phát, âm thanh và các ứng dụng AI khác bị loại ra; khâu huấn luyện, phần ít được ghi chép nhất, được hiệu chỉnh dựa trên một vài mô hình mở nhỏ. Mức sử dụng cũng có thể thu hẹp nhanh chóng, như việc đóng cửa Sora đã cho thấy. Nhưng theo các con số của bài báo, dấu chân môi trường chỉ ngừng tăng nếu số lượng video, hoặc chất lượng của chúng, cũng ngừng tăng.