LES VIDÉOS D'IA POURRAIENT ÉMETTRE 75 FOIS PLUS D'ICI 2030
Tapez une phrase, obtenez un clip vidéo : la génération de vidéos à partir de texte fonctionne désormais à l’échelle commerciale. On savait déjà son coût par clip élevé. Selon une étude antérieure de Delavande et ses collègues, générer une courte vidéo à partir d’un texte consomme environ 90 wattheures, près de 30 fois une image et 45 000 fois une simple tâche de classification de texte. Et les clips ne sont pas fabriqués sur l’appareil de l’utilisateur : chaque demande tourne sur des baies de puces d’IA, dans des centres de données.
Mais un coût par clip dit peu de choses du total. Il ne dit pas combien de clips sont produits, quel matériel cela exige, ni combien d’eau consomme le refroidissement. Et l’efficacité par clip peut s’améliorer pendant que l’empreinte totale grandit.
Tristan Coignion, de l’Université de Lille, avec A. Bugeau et G. Guennebaud à Bordeaux et A.-L. Ligozat à Paris-Saclay, a voulu estimer l’empreinte totale de la génération de vidéos par IA dans le monde — pour 2026 et jusqu’en 2030.
Compter les clips
Les fournisseurs disent rarement combien de vidéos ils génèrent ; l’équipe a donc mesuré ce qu’elle pouvait. Elle a aspiré le flux public de Sora, le service vidéo d’OpenAI, pendant 54 jours entre février et avril 2026 : 3,3 millions de vidéos publiques, soit environ 22 millions par an. OpenAI a fermé les versions web et application de Sora peu après. Elle a aussi suivi le compteur en direct de HeyGen pendant 90 jours : environ 111 millions de vidéos par an, vidéos privées comprises.
Six autres fournisseurs publient leurs propres chiffres. Le plus gros, de loin, est Grok Imagine, avec environ 3,8 milliards par an. Additionnés, ils donnent un total observable d’environ 6,2 milliards de vidéos par an. Ces comptes étant partiels, le modèle laisse le vrai volume de 2026 varier entre 6,2 et 9,5 milliards ; son estimation centrale est de 7,16 milliards.
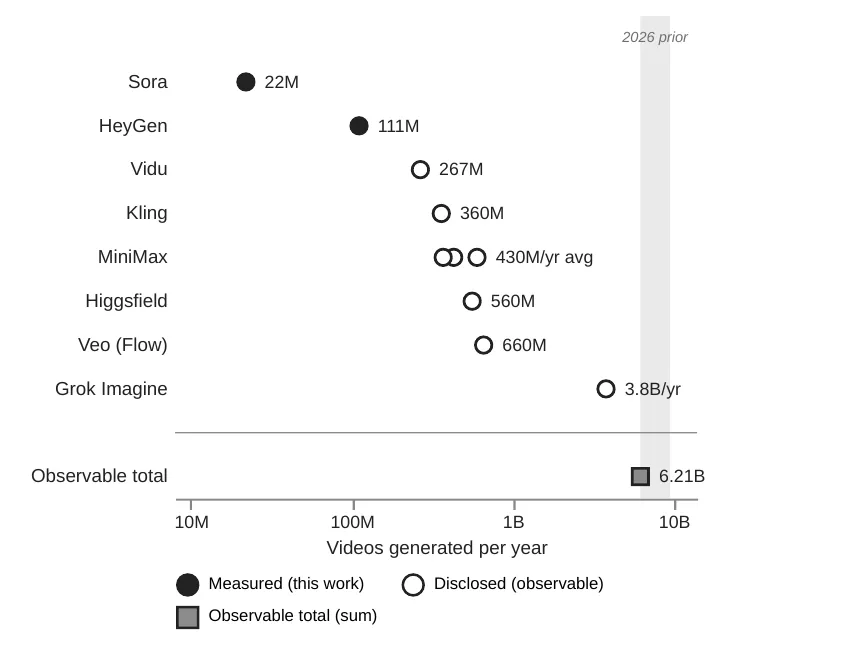
Vidéos d’IA par an et par service : points pleins mesurés par l’équipe, points creux publiés par les fournisseurs ; la bande grisée est la fourchette du modèle pour 2026. — Fig. 1, Coignion et al. (2026), arXiv:2611.17938.
La facture de 2026
À partir de là, un modèle ascendant dimensionne le parc de puces d’IA nécessaire, puis en déduit l’électricité, l’eau, les gaz à effet de serre et l’épuisement des ressources minérales, en lançant 10 000 simulations pour tenir compte des incertitudes. L’entraînement et le stockage sont inclus ; le son, et la diffusion des vidéos aux spectateurs, ne le sont pas.
Pour 2026, le résultat médian est un parc de 72 600 processeurs graphiques, 724 gigawattheures d’électricité et 124 300 tonnes d’équivalent CO₂. Prenez les gaz à effet de serre que l’humanité peut émettre chaque année sans franchir la limite climatique de la planète, et partagez-les à parts égales : 124 300 tonnes, c’est la part annuelle d’environ 126 000 personnes.
Par vidéo, le coût tout compris atteint environ 100 wattheures — 4,1 fois les 24,4 wattheures que dépense la puce seule pour une génération — une moyenne sur les clips de 2026, surtout courts et peu définis, corrigée des optimisations des services commerciaux. Le temps d’inactivité, les surcoûts des bâtiments, l’entraînement et le stockage font la différence. La génération des vidéos compte pour environ 69 % des émissions, l’entraînement des modèles pour 31 %, le stockage pour presque rien. Et la provenance de l’électricité compte plus que sa quantité : pour les émissions, l’intensité carbone du réseau pèse 12 fois plus que le nombre de vidéos.
Trois avenirs
Le modèle tourne ensuite jusqu’en 2030 selon trois scénarios, tous avec le même progrès technique régulier : des puces plus récentes et plus efficaces, et des logiciels environ 10 % plus efficaces chaque année.
- Référence : le nombre de vidéos double en 2027, 2028 et 2029, puis croît de 60 % en 2030 — 12,8 fois au total, une trajectoire volontairement modeste. Les émissions sont multipliées par 74, pour atteindre environ 9,2 millions de tonnes en 2030 : le budget d’environ 9,3 millions de personnes. Pourquoi plus vite que la demande ? Les vidéos deviennent plus longues et plus nettes : l’énergie par vidéo passe de 24,4 à 214 wattheures.
- Usage figé : volume, résolution et durée restent au niveau de 2026. Les émissions baissent d’environ deux cinquièmes. C’est le seul scénario où elles diminuent.
- Adoption massive : le volume est multiplié par 60. Les émissions atteignent 42,9 millions de tonnes — le budget d’environ 44 millions de personnes.
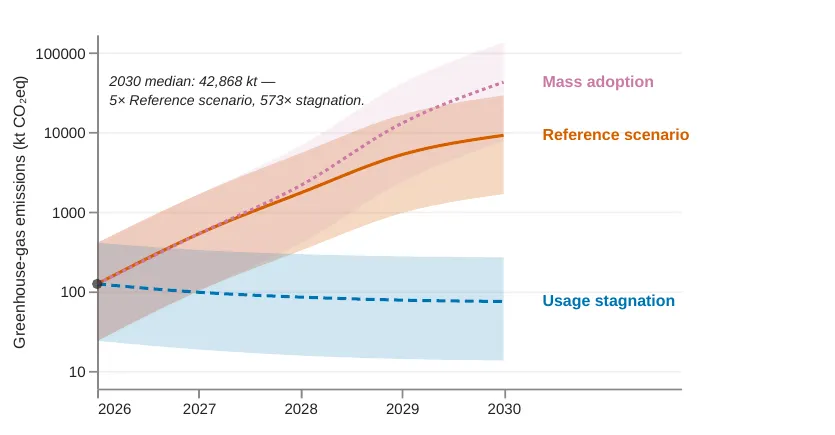
Émissions selon les trois scénarios, 2026-2030 ; les lignes sont des médianes, les bandes la fourchette de 5 à 95 %. — Fig. 6, Coignion et al. (2026), arXiv:2611.17938.
L’efficacité ne rattrapera pas
L’équipe a aussi fait tourner le modèle à l’envers. Sur la trajectoire de référence, même 30 % d’efficacité gagnés chaque année laissent les émissions de 2030 27,5 fois au-dessus de 2026. Les maintenir stables exigerait un gain d’efficacité d’environ 75 % par an — quelque sept fois les 10 % retenus par le modèle, et au-delà de la meilleure efficacité mesurée sur un modèle en production. L’objectif du secteur numérique lui-même, aligné sur l’accord de Paris, demande de réduire de 45 % les émissions entre 2020 et 2030.
Un plancher, pas un plafond
Les auteurs présentent tous ces chiffres comme des bornes basses. Le modèle de génération reste figé jusqu’en 2030, alors que les vrais modèles deviendront sans doute plus gourmands ; la diffusion, le son et les autres usages de l’IA sont laissés de côté ; l’entraînement, la partie la moins documentée, est calé sur quelques petits modèles libres. L’usage peut aussi se contracter vite, comme l’a montré la fermeture de Sora. Mais avec les chiffres de l’article, l’empreinte ne cesse de croître que si le nombre de vidéos, ou leur qualité, cesse lui aussi de croître.