FACHARTIKEL IM KI-ZEITALTER SAGEN SIEBENMAL HÄUFIGER „RATHER THAN“
Große Sprachmodelle helfen inzwischen beim Schreiben eines guten Teils der wissenschaftlichen Artikel, und sie hinterlassen Spuren: Lieblingswörter, einen bestimmten Ton. Eine Gewohnheit hat begonnen, Forschende in der Verarbeitung natürlicher Sprache (NLP) zu irritieren: Sätze nach dem Muster „X rather than Y“ („X statt Y“), die eine Aussage zum Teil über das definieren, was sie nicht ist. Laut der Studie haben sich Gutachter der jüngsten Einreichungsrunde für NLP-Konferenzen darüber beschwert, und Konferenzorganisatoren diskutieren inzwischen über Texte „voller KI-Floskeln“.
Olga Zamaraeva, Adrián Gude, Roi Santos-Ríos und Carlos Gómez-Rodríguez von der Universität A Coruña in Spanien machten sich daran, das zu messen – mit einem Titel, der die Pointe schon selbst setzt.
Siebenmal mehr
Sie verglichen 4.744 Artikel der Tagungen der Association for Computational Linguistics von 2019, bevor KI-Schreibassistenten verbreitet waren, mit 1.821 NLP-Artikeln, die 2026 im selben Konferenzformat auf arXiv veröffentlicht wurden.
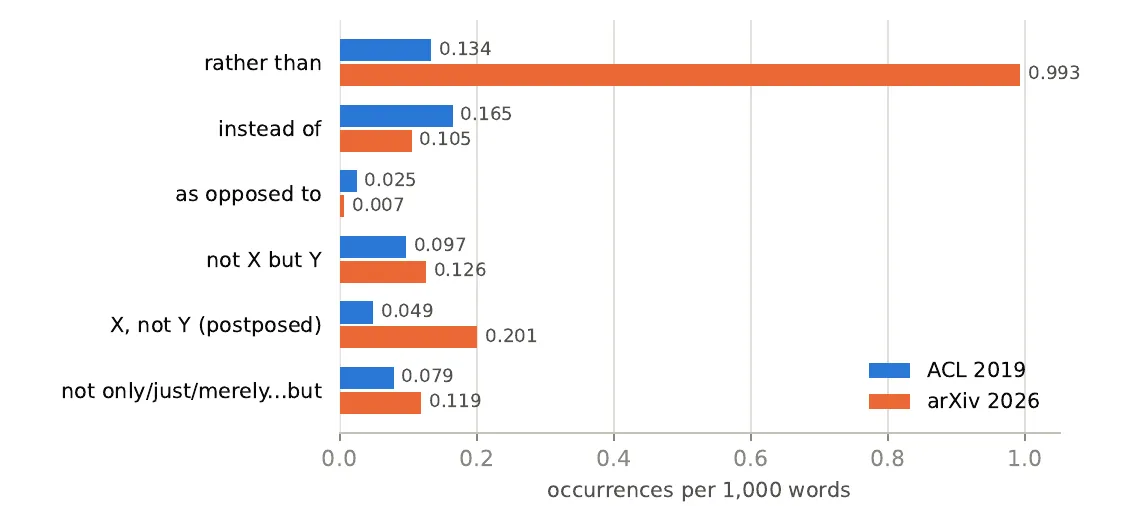
Vorkommen pro 1.000 Wörter in Artikeln von 2019 (blau) und 2026 (orange): „rather than“ und „X, not Y“ schnellen nach oben, während „instead of“ und „as opposed to“ zurückgehen. — Abbildung 1, Zamaraeva et al. (2026), arXiv:2610.10092.
- „Rather than“ stieg von 0,134 auf 0,993 Verwendungen pro 1.000 Wörter, etwa siebenmal mehr.
- Das verwandte „X, not Y“ („X, nicht Y“) vervierfachte sich; „instead of“ und „as opposed to“ wurden dagegen seltener.
- 94 % der Artikel von 2026 enthalten „rather than“, gegenüber 36 % im Jahr 2019, und verwenden es im Schnitt etwa achtmal. Ein Artikel von 2026 verwendet es 69-mal, ungefähr einmal alle 170 Wörter; kein Artikel von 2019 kommt auf mehr als 12.
Das Team ließ außerdem Modelle vollständige Artikel aus Titel und Zusammenfassung echter Arbeiten schreiben. GPT-5.6-sol und GPT-6-sol verwendeten die Wendung in jedem Artikel, häufiger als die Autoren von 2026. Auch Claude Haiku 4.5, Sonnet 5.5 und Opus 5.5 von Anthropic verwendeten sie in fast jedem Artikel, mit etwas geringerer Rate. Ein offenes Modell, Tülu 3 8B, verwendete sie in keiner Phase seines Trainings oft. Überarbeitungen beseitigten die Gewohnheit nicht: Spätere arXiv-Versionen derselben Artikel von 2026 enthalten etwas mehr davon.
Ärgerlich – aber welche?
Die Häufigkeit allein beweist nichts: Die Wendung hat viele legitime Verwendungen. Deshalb kennzeichneten zwei der Autoren, erfahrene Gutachter, 1.000 Verwendungen, die ihnen blind vorgelegt wurden, als „ärgerlich“ oder „legitim“.
- Fast keine Verwendung von 2019 ärgerte sie (1,6 % beim einen, 0 % beim anderen).
- Etwa jede zehnte Verwendung von 2026 tat es (11,5 % und 8,3 %).
- Welche Verwendungen ärgerlich waren, darüber waren sie sich selten einig. Da ein Artikel von 2026 aber so viele enthält, schätzen die Autoren, dass etwa die Hälfte der Artikel von 2026 mindestens eine Verwendung enthält, die jeden von beiden ärgert, und fast zwei Drittel eine, die mindestens einen von ihnen ärgert – gegenüber etwa 1 % im Jahr 2019.
Was die ärgerlichen Verwendungen unterscheidet, ist vor allem, wie sie mit der verworfenen Option umgehen. Sie neigen dazu, eine Alternative zu loben und die andere abzuwerten, und andere Personen hielten die verworfene Option häufiger für einen Strohmann, eine Position, die kein kompetenter Forscher vertreten würde. Leser nahmen die Wendung selbst auch als Zeichen von KI-Texten, obwohl sie von GPT geschriebene Passagen nicht von menschlichen aus dem Jahr 2019 unterscheiden konnten.
Die Ergebnisse zu Claude, bisher nur von einem Annotator gekennzeichnet, sind gemischt. Claudes erste Entwürfe ärgerten nicht mehr als die Artikel von 2019 und weniger als die von GPT-6-sol. Seine Überarbeitungen ärgerten jedoch ebenso oft wie die von GPT-6-sol, etwa doppelt so oft wie seine eigenen ersten Entwürfe. Der Unterschied kam von „Distanzierungen“ (disavowals), bei denen Autoren eine stärkere Behauptung über ihre eigene Arbeit zurückweisen („eine Hypothese rather than ein geprüfter Mechanismus“); sie wurden häufiger, als die Modelle ihre Artikel überarbeiteten.
Von den Bewertern belohnt
Woher kommt die Gewohnheit? Chatbots werden anhand von Antwortpaaren feinabgestimmt, von denen ein Mensch oder ein KI-Richter eine bevorzugt. In drei von vier öffentlichen Datensätzen solcher Präferenzen wurden Antworten mit „rather than“ eher ausgewählt, am deutlichsten, wenn Menschen urteilten. Vier offene „Belohnungsmodelle“ (reward models) bewerteten einen Satz mit seinem „rather than“-Teil höher als ohne ihn, selbst wenn ein neutraler Satzteil gleicher Länge an seine Stelle trat. Und wer ein Modell anwies, „ehrlich“ zu sein, brachte es dazu, die Wendung etwas häufiger zu verwenden.
Die Autoren vermuten, dass die Konstruktion eine Nebenwirkung dieser Art von Training ist: In einer einzelnen Chatbot-Antwort wirkt eine vorsichtige Distanzierung ehrlich; durch einen ganzen Artikel und eine ganze Fachliteratur wiederholt, liest sie sich wie Parteinahme. Die Wendung zu verbieten, würde dieselbe Funktion wahrscheinlich nur verlagern, so wie GPT-6-sol beim Überarbeiten „rather than“ durch „X, not Y“ ersetzt.
Der Stil breitet sich aus
Die Studie hat klare Grenzen: zwei Annotatoren, die zugleich Autoren sind, wobei der Claude-Vergleich bisher nur von einem von ihnen gekennzeichnet wurde; eine Mustersuche, die Verwendungen übersehen kann; und Präferenzdaten, die nur Korrelationen zeigen. Doch ihre Schlussfolgerung reicht über eine einzelne Wendung hinaus. Von Menschen unterzeichnete Artikel haben die Konstruktion übernommen, sodass der Stil der wissenschaftlichen Literatur in Richtung des Stils der Modelle driftet – die wiederum daraus lernen werden.
Interessenkonflikt. Die Autoren geben an, Claude Code (Claude Sonnet 5, Sonnet 5.5 und Opus 5.5) verwendet zu haben, um ihren Code zu schreiben, die Analysen durchzuführen und Text im gesamten Artikel zu entwerfen, einschließlich der Abschnitte Methoden und Ergebnisse, bevor sie ihn von Hand überarbeiteten – wobei sie unter anderem zehn bei der Generierung eingefügte „rather than“ entfernten. Claude-Modelle gehören auch zu den untersuchten Systemen und dienten als automatische Bewerter. Claude hat auch den vorliegenden Artikel geschrieben.