செயற்கை நுண்ணறிவு யுகக் கட்டுரைகள் "RATHER THAN" என்பதை ஏழு மடங்கு அதிகம் பயன்படுத்துகின்றன
பெரிய மொழி மாதிரிகள் இப்போது அறிவியல் கட்டுரைகளில் கணிசமான பங்கை எழுத உதவுகின்றன; அவை தடயங்களை விட்டுச்செல்கின்றன: விருப்பமான சொற்கள், ஒரு குறிப்பிட்ட தொனி. ஒரு பழக்கம் இயல்மொழிச் செயலாக்க (NLP) ஆய்வாளர்களை எரிச்சலூட்டத் தொடங்கியுள்ளது: ஒரு கூற்றை ஓரளவு அது எது அல்ல என்பதைக் கொண்டு வரையறுக்கும், “X rather than Y” (“Yக்குப் பதிலாக X”) மீது கட்டப்பட்ட வாக்கியங்கள். கட்டுரையின்படி, NLP மாநாடுகளுக்கான சமீபத்திய சமர்ப்பிப்புச் சுற்றின் மதிப்பாய்வாளர்கள் இது குறித்துப் புகார் செய்தனர்; மாநாட்டு அமைப்பாளர்கள் இப்போது “செயற்கை நுண்ணறிவுச் சொல்லாட்சிகள் நிறைந்த” எழுத்து குறித்து விவாதிக்கின்றனர்.
ஸ்பெயினின் அ கொருன்யா பல்கலைக்கழகத்தைச் சேர்ந்த ஓல்கா சமரேவா, அட்ரியான் குடே, ரோய் சாண்டோஸ்-ரியோஸ், கார்லோஸ் கோமஸ்-ரோட்ரிகஸ் ஆகியோர் அதை அளக்கப் புறப்பட்டனர் — தானே கருத்தைச் சொல்லும் ஒரு தலைப்புடன்.
ஏழு மடங்கு அதிகம்
செயற்கை நுண்ணறிவு எழுத்து உதவியாளர்கள் பரவலாவதற்கு முன், 2019இல் நடந்த கணினி மொழியியல் சங்கத்தின் (Association for Computational Linguistics) கூட்டங்களின் 4,744 கட்டுரைகளை, 2026இல் அதே மாநாட்டு வடிவத்தில் arXivஇல் வெளியிடப்பட்ட 1,821 NLP கட்டுரைகளுடன் ஒப்பிட்டனர்.
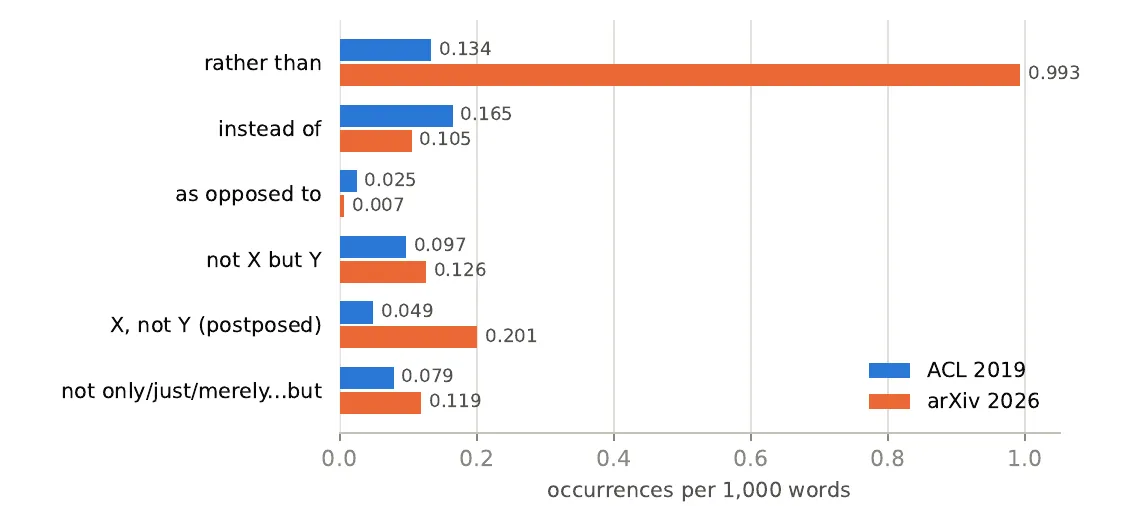
2019 (நீலம்), 2026 (ஆரஞ்சு) கட்டுரைகளில் 1,000 சொற்களுக்கான நிகழ்வுகள்: “rather than”, “X, not Y” ஆகியவை பெருகுகின்றன; “instead of”, “as opposed to” ஆகியவை குறைகின்றன. — Figure 1, Zamaraeva et al. (2026), arXiv:2610.10092.
- “Rather than” 1,000 சொற்களுக்கு 0.134இலிருந்து 0.993 பயன்பாடுகளாக உயர்ந்தது; சுமார் ஏழு மடங்கு அதிகம்.
- தொடர்புடைய “X, not Y” (“X, Y அல்ல”) நான்கு மடங்கானது; அதே வேளையில் “instead of”, “as opposed to” (“பதிலாக”, “மாறாக”) குறைவாகப் பயன்படுத்தப்பட்டன.
- 2026 கட்டுரைகளில் 94% “rather than” கொண்டுள்ளன (2019இல் 36%); சராசரியாகச் சுமார் எட்டு முறை பயன்படுத்துகின்றன. 2026இன் ஒரு கட்டுரை அதை 69 முறை, ஏறக்குறைய ஒவ்வொரு 170 சொற்களுக்கும் ஒருமுறை, பயன்படுத்துகிறது; 2019இன் எந்தக் கட்டுரையும் 12ஐத் தாண்டவில்லை.
உண்மையான கட்டுரைகளின் தலைப்பு, சுருக்கத்திலிருந்து முழுக் கட்டுரைகளை எழுதும்படி குழு மாதிரிகளையும் பணித்தது. GPT-5.6-sol, GPT-6-sol ஆகியவை அந்தச் சொற்றொடரை ஒவ்வொரு கட்டுரையிலும், 2026 ஆசிரியர்களை விட அடிக்கடி பயன்படுத்தின. Anthropic நிறுவனத்தின் Claude Haiku 4.5, Sonnet 5.5, Opus 5.5 ஆகியவையும் அதைக் கிட்டத்தட்ட ஒவ்வொரு கட்டுரையிலும், சற்றுக் குறைந்த வீதங்களில் பயன்படுத்தின. Tülu 3 8B என்ற திறந்த மாதிரி, அதன் பயிற்சியின் எந்தக் கட்டத்திலும் அதை அரிதாகவே பயன்படுத்தியது. கட்டுரைகளைத் திருத்துவது பழக்கத்தை நீக்கவில்லை: அதே 2026 கட்டுரைகளின் பிந்தைய arXiv பதிப்புகள் சற்று அதிகமாகவே கொண்டுள்ளன.
எரிச்சலூட்டுபவை, ஆனால் எவை?
அதிர்வெண் மட்டுமே எதையும் நிரூபிக்காது: இந்தச் சொற்றொடருக்கு ஏராளமான நியாயமான பயன்பாடுகள் உள்ளன. எனவே ஆசிரியர்களில் அனுபவமிக்க மதிப்பாய்வாளர்களான இருவர், யாருடையது எனத் தெரியாமல் காட்டப்பட்ட 1,000 பயன்பாடுகளை “எரிச்சலூட்டுவது” அல்லது “நியாயமானது” என்று குறியிட்டனர்.
- 2019 பயன்பாடுகளில் கிட்டத்தட்ட எதுவும் அவர்களை எரிச்சலூட்டவில்லை (ஒருவருக்கு 1.6%, மற்றவருக்கு 0%).
- 2026 பயன்பாடுகளில் பத்தில் ஒன்று எரிச்சலூட்டியது (11.5%, 8.3%).
- எந்த பயன்பாடுகள் எரிச்சலூட்டுகின்றன என்பதில் அவர்கள் அரிதாகவே உடன்பட்டனர். ஆனால் ஒரு 2026 கட்டுரையில் இவ்வளவு பயன்பாடுகள் இருப்பதால், 2026 கட்டுரைகளில் சுமார் பாதி அவர்கள் ஒவ்வொருவரையும் எரிச்சலூட்டும் குறைந்தது ஒரு பயன்பாட்டையும், கிட்டத்தட்ட மூன்றில் இரண்டு பங்கு அவர்களில் குறைந்தது ஒருவரையாவது எரிச்சலூட்டும் ஒன்றையும் கொண்டுள்ளன என்று ஆசிரியர்கள் மதிப்பிடுகின்றனர் — 2019இல் சுமார் 1%க்கு எதிராக.
எரிச்சலூட்டும் பயன்பாடுகளைத் தனித்துக் காட்டுவது முக்கியமாக அவை நிராகரிக்கப்பட்ட தேர்வை எப்படி நடத்துகின்றன என்பதே. அவை ஒரு மாற்றைப் புகழ்ந்து மற்றதைச் சிறுமைப்படுத்த முனைகின்றன; நிராகரிக்கப்பட்ட தேர்வைப் பிறர் அடிக்கடி ஒரு வைக்கோல் மனிதனாக, அதாவது திறமையான எந்த ஆய்வாளரும் ஆதரிக்காத நிலைப்பாடாக, மதிப்பிட்டனர். வாசகர்கள் சொற்றொடரையே செயற்கை நுண்ணறிவு எழுத்தின் அடையாளமாகக் கருதினர்; ஆனால் GPT எழுதிய பகுதிகளை 2019இல் மனிதர்கள் எழுதியவற்றிலிருந்து வேறுபடுத்த அவர்களால் முடியவில்லை.
இதுவரை ஒரே ஒரு குறியீட்டாளரால் மட்டுமே குறியிடப்பட்ட Claude முடிவுகள் கலவையானவை. Claudeஇன் முதல் வரைவுகள் 2019 கட்டுரைகளை விட அதிகம் எரிச்சலூட்டவில்லை; GPT-6-solஇன் வரைவுகளை விடக் குறைவாகவே எரிச்சலூட்டின. அதன் திருத்தங்கள் GPT-6-solஇன் திருத்தங்கள் அளவுக்கே அடிக்கடி எரிச்சலூட்டின; அதன் சொந்த முதல் வரைவுகளை விடச் சுமார் இரு மடங்கு. இந்த வேறுபாடு “மறுப்புகளிலிருந்து” வந்தது — ஆசிரியர்கள் தங்கள் சொந்த ஆய்வு குறித்த வலுவான கூற்றை மறுப்பவை (“சோதிக்கப்பட்ட செயல்முறைக்குப் பதிலாக ஒரு கருதுகோள்”); மாதிரிகள் தங்கள் கட்டுரைகளைத் திருத்தியபோது இவை அதிகமாயின.
மதிப்பீட்டாளர்களால் வெகுமதி பெறுவது
இந்தப் பழக்கம் எங்கிருந்து வருகிறது? அரட்டை இயந்திரங்கள் (chatbots) பதில் ஜோடிகளின் மீது நுண்சீரமைக்கப்படுகின்றன; அவற்றில் ஒன்றை ஒரு மனிதரோ செயற்கை நுண்ணறிவு நடுவரோ விரும்புகிறார். இத்தகைய விருப்பங்களின் நான்கு பொதுத் தரவுத்தொகுப்புகளில் மூன்றில், “rather than” கொண்ட பதில்கள் தேர்ந்தெடுக்கப்படும் வாய்ப்பு அதிகமாக இருந்தது; நடுவர்கள் மனிதர்களாக இருந்தபோது மிகத் தெளிவாக. நான்கு திறந்த “வெகுமதி மாதிரிகள்” (reward models), ஒரு வாக்கியத்தை அதன் “rather than” உட்பிரிவுடன் இருக்கும்போது அது இல்லாததை விட அதிகமாக மதிப்பிட்டன; அதே நீளமுள்ள நடுநிலை உட்பிரிவு அதற்குப் பதிலாக வைக்கப்பட்டபோதும் கூட. ஒரு மாதிரியிடம் “நேர்மையாக” இருக்கச் சொன்னது அதை அந்தச் சொற்றொடரைச் சற்று அதிகமாகப் பயன்படுத்த வைத்தது.
இந்தக் கட்டமைப்பு இத்தகைய பயிற்சியின் பக்கவிளைவு என்று ஆசிரியர்கள் ஊகிக்கின்றனர்: ஒரே ஒரு அரட்டை இயந்திரப் பதிலில், கவனமான மறுப்பு நேர்மையாகத் தோன்றுகிறது; ஒரு முழுக் கட்டுரையிலும், ஒரு முழு இலக்கியத்திலும் திரும்பத் திரும்ப வரும்போது, அது வாதாடுதல் போல வாசிக்கப்படுகிறது. சொற்றொடரைத் தடை செய்வது அதே செயல்பாட்டை வேறிடத்துக்கு நகர்த்துவதாகவே இருக்கும்; திருத்தத்தின்போது GPT-6-sol “rather than” ஐ “X, not Y” ஆக மாற்றுவது போல.
நடை பரவுகிறது
ஆய்வுக்குத் தெளிவான வரம்புகள் உள்ளன: ஆசிரியர்களாகவும் இருக்கும் இரண்டு குறியீட்டாளர்கள், இதுவரை அவர்களில் ஒருவரால் மட்டுமே குறியிடப்பட்ட Claude ஒப்பீடு; பயன்பாடுகளைத் தவறவிடக்கூடிய வடிவப் பொருத்தம்; தொடர்புகளை மட்டுமே காட்டும் விருப்பத் தரவுகள். ஆனால் அதன் முடிவு ஒரு சொற்றொடருக்கு அப்பால் செல்கிறது. மனிதர்கள் கையொப்பமிட்ட கட்டுரைகள் இந்தக் கட்டமைப்பை ஏற்றுக்கொண்டுள்ளன; எனவே அறிவியல் இலக்கியத்தின் நடை மாதிரிகளின் நடையை நோக்கி நகர்கிறது — அந்த மாதிரிகளும் தம் முறைக்கு அதிலிருந்து கற்றுக்கொள்ளும்.
நலன் முரண். தங்கள் குறியீட்டை எழுதவும், பகுப்பாய்வுகளை இயக்கவும், முறைகள், முடிவுகள் பகுதிகள் உட்படக் கட்டுரை முழுவதும் உரையை வரைவு செய்யவும் Claude Code (Claude Sonnet 5, Sonnet 5.5, Opus 5.5) ஐப் பயன்படுத்தியதாகவும், பின்னர் அதைக் கையால் திருத்தியதாகவும் ஆசிரியர்கள் கூறுகின்றனர் — மற்றவற்றுடன், உருவாக்கத்தின்போது புகுத்தப்பட்ட பத்து “rather than” களை நீக்கி. Claude மாதிரிகள் ஆய்வு செய்யப்பட்ட அமைப்புகளில் அடங்கும்; தானியங்கு மதிப்பீட்டாளர்களாகவும் செயல்பட்டன. இந்தக் கட்டுரையையும் Claude எழுதியது.