MAKALA ZA ENZI YA AI HUSEMA "RATHER THAN" MARA SABA ZAIDI
Modeli kubwa za lugha sasa husaidia kuandika sehemu kubwa ya makala za kisayansi, na huacha alama: maneno yanayopendwa, sauti fulani. Tabia moja imeanza kuwakera watafiti wa uchakataji wa lugha asilia (NLP): sentensi zilizojengwa juu ya “X rather than Y” (X si Y), zinazofafanua dai kwa sehemu kupitia kile ambacho silo. Kwa mujibu wa makala, wahakiki wa awamu ya karibuni ya makala zilizowasilishwa kwenye makongamano ya NLP walilalamikia jambo hili, na waandaaji wa makongamano sasa wanajadili uandishi “uliojaa mazoea ya AI”.
Olga Zamaraeva, Adrián Gude, Roi Santos-Ríos na Carlos Gómez-Rodríguez, wa Chuo Kikuu cha A Coruña nchini Hispania, waliamua kulipima — kwa kichwa cha habari kinachojieleza chenyewe (“Ningependa kuacha NLP kuliko kusoma makala nyingine kama hii”).
Mara saba zaidi
Walilinganisha makala 4,744 za makongamano ya 2019 ya Chama cha Isimu ya Kikokotozi (ACL), kabla wasaidizi wa uandishi wa AI hawajaenea, na makala 1,821 za NLP zilizowekwa kwenye arXiv mwaka 2026 katika muundo uleule wa kongamano.
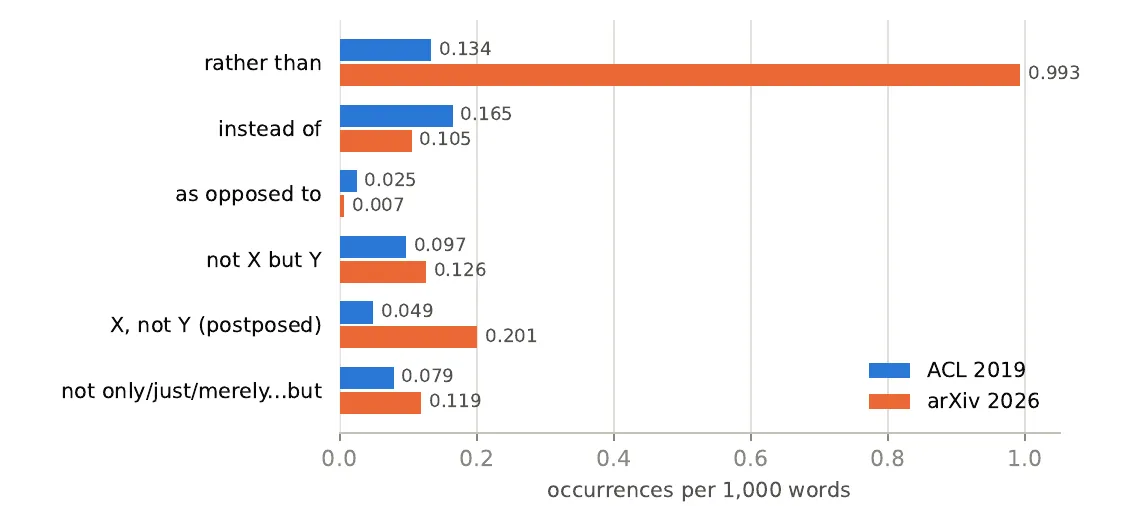
Matukio kwa kila maneno 1,000 katika makala za 2019 (bluu) na 2026 (machungwa): “rather than” na “X, not Y” vinapanda kwa kasi, ilhali “instead of” na “as opposed to” vinashuka. — Figure 1, Zamaraeva et al. (2026), arXiv:2610.10092.
- “Rather than” kilipanda kutoka matumizi 0.134 hadi 0.993 kwa kila maneno 1,000, takriban mara saba zaidi.
- Kirai husika “X, not Y” (X, si Y) kiliongezeka mara nne; wakati huohuo “instead of” na “as opposed to” (badala ya, tofauti na) vilikuwa chache zaidi.
- 94% ya makala za 2026 zina “rather than”, dhidi ya 36% mwaka 2019, na hukitumia takriban mara nane kwa wastani. Makala moja ya 2026 inakitumia mara 69, takriban mara moja kila maneno 170; hakuna makala ya 2019 inayozidi 12.
Timu pia iliziagiza modeli kuandika makala kamili kutoka kwenye kichwa na muhtasari wa makala halisi. GPT-5.6-sol na GPT-6-sol zilitumia kirai hiki katika kila makala, mara nyingi zaidi kuliko waandishi wa 2026. Claude Haiku 4.5, Sonnet 5.5 na Opus 5.5 za Anthropic pia zilikitumia karibu katika kila makala, kwa viwango vya chini kidogo. Modeli huria, Tülu 3 8B, ilikitumia mara chache katika hatua yoyote ya mafunzo yake. Kurekebisha makala hakukuondoa tabia hii: matoleo ya baadaye ya arXiv ya makala zilezile za 2026 yana kidogo zaidi.
Yanakera, lakini yapi?
Marudio peke yake hayathibitishi chochote: kirai hiki kina matumizi mengi halali. Kwa hiyo waandishi wawili, ambao ni wahakiki wazoefu, waliweka lebo kwa matumizi 1,000 yaliyoonyeshwa bila kutaja yalikotoka, kama “yanayokera” au “halali”.
- Karibu hakuna matumizi ya 2019 yaliyowakera (1.6% kwa mmoja, 0% kwa mwingine).
- Takriban matumizi moja kati ya kumi ya 2026 yaliwakera (11.5% na 8.3%).
- Mara chache walikubaliana kuhusu matumizi yapi yanakera. Lakini kwa kuwa makala ya 2026 ina mengi mno, waandishi wanakadiria kuwa takriban nusu ya makala za 2026 zina angalau matumizi moja yanayomkera kila mmoja wao, na karibu theluthi mbili zina moja linalomkera angalau mmoja wao — dhidi ya takriban 1% mwaka 2019.
Kinachoyatofautisha matumizi yanayokera ni hasa jinsi yanavyolishughulikia chaguo lililokataliwa. Huwa yanasifu mbadala mmoja na kudharau mwingine, na watu wengine mara nyingi zaidi walilihukumu chaguo lililokataliwa kuwa kikaragosi cha majani (straw man), msimamo ambao hakuna mtafiti mwenye uwezo angeutetea. Wasomaji pia walikichukulia kirai chenyewe kama ishara ya uandishi wa AI, huku wakishindwa kutofautisha vifungu vilivyoandikwa na GPT na vile vilivyoandikwa na binadamu mwaka 2019.
Matokeo ya Claude, yaliyowekewa lebo hadi sasa na mwekaji lebo mmoja tu, ni mchanganyiko. Rasimu za kwanza za Claude hazikukera zaidi ya makala za 2019 na zilikera kidogo kuliko za GPT-6-sol. Marekebisho yake yalikera mara nyingi kama ya GPT-6-sol, takriban mara mbili ya rasimu zake za kwanza. Tofauti ilitokana na “makanusho”, ambamo waandishi hukataa dai lenye nguvu zaidi kuhusu kazi yao wenyewe (“dhana si utaratibu uliojaribiwa”), ambayo yaliongezeka modeli zilipozirekebisha makala zao.
Hutuzwa na watathmini
Tabia hii inatoka wapi? Chatbot hurekebishwa kwa jozi za majibu, moja likipendelewa na binadamu au jaji wa AI. Katika hifadhidata nne za umma za mapendeleo kama hayo, majibu yenye “rather than” yalikuwa na uwezekano mkubwa zaidi wa kuchaguliwa katika tatu, kwa uwazi zaidi pale majaji walipokuwa binadamu. “Modeli za zawadi” (reward models) nne huria ziliipa sentensi alama ya juu zaidi ikiwa na kishazi chake cha “rather than” kuliko bila kishazi hicho, hata kishazi kisichoegemea upande wowote chenye urefu uleule kilipowekwa mahali pake. Na kuiambia modeli iwe “mwaminifu” kuliifanya itumie kirai hiki kidogo zaidi.
Waandishi wanakisia kwamba muundo huu ni athari ya pembeni ya aina hii ya mafunzo: katika jibu moja la chatbot, kanusho la uangalifu huonekana kuwa la uaminifu; likirudiwa katika makala nzima, na fasihi nzima, husomeka kama utetezi. Kupiga marufuku kirai hiki pengine kungehamisha tu kazi ileile mahali pengine, kama GPT-6-sol inavyofanya inapobadilisha “rather than” kwa “X, not Y” wakati wa marekebisho.
Mtindo unaenea
Utafiti una mipaka ya wazi: waweka lebo wawili ambao pia ni waandishi, na ulinganisho wa Claude hadi sasa umewekewa lebo na mmoja wao tu; ulinganishaji wa mifumo unaoweza kukosa baadhi ya matumizi; na data ya mapendeleo inayoonyesha uhusiano tu. Lakini hitimisho lake linavuka kirai kimoja. Makala zilizotiwa saini na binadamu zimeupokea muundo huu, kwa hiyo mtindo wa fasihi ya kisayansi unaelea kuelekea ule wa modeli — ambazo, nazo, zitajifunza kutoka kwake.
Mgongano wa maslahi. Waandishi wanaeleza kuwa walitumia Claude Code (Claude Sonnet 5, Sonnet 5.5 na Opus 5.5) kuandika msimbo wao, kuendesha uchambuzi na kuandaa rasimu ya maandishi katika makala nzima, ikiwemo sehemu za Methods na Results, kabla ya kuyahariri kwa mkono — wakiondoa, miongoni mwa mambo mengine, “rather than” kumi vilivyoingizwa wakati wa uzalishaji. Modeli za Claude pia ni miongoni mwa mifumo iliyochunguzwa na zilitumika kama watathmini wa kiotomatiki. Claude pia ndiye aliyeandika makala hii.