AI-युगातील शोधनिबंध "RATHER THAN" सातपट जास्त वेळा म्हणतात
मोठी भाषा-मॉडेल्स आता वैज्ञानिक शोधनिबंधांचा बराच मोठा भाग लिहिण्यास मदत करतात, आणि ती आपल्या खुणा मागे ठेवतात: आवडते शब्द, एक विशिष्ट सूर. एका सवयीमुळे नैसर्गिक भाषा प्रक्रिया (NLP) क्षेत्रातील संशोधक वैतागू लागले आहेत: “X rather than Y” (Y ऐवजी X) या रचनेवर आधारित वाक्ये, जी एखादा दावा अंशतः तो काय नाही यावरून ठरवतात. शोधनिबंधानुसार, NLP परिषदांकडे आलेल्या ताज्या फेरीतील लेखांच्या समीक्षकांनी याबद्दल तक्रार केली, आणि परिषदांचे आयोजक आता “AI-लकबींनी भरलेल्या” लेखनावर चर्चा करतात.
स्पेनमधील आ कोरुन्या विद्यापीठातील ओल्गा झामारायेव्हा (Olga Zamaraeva), आद्रियान गुदे (Adrián Gude), रोई सांतोस-रिओस (Roi Santos-Ríos) आणि कार्लोस गोमेझ-रॉद्रिगेझ (Carlos Gómez-Rodríguez) यांनी हे मोजायचे ठरवले — अशा शीर्षकासह जे स्वतःच मुद्दा सांगते (“असा आणखी एक शोधनिबंध वाचण्यापेक्षा मी NLP सोडणे पसंत करेन”).
सातपट जास्त
त्यांनी AI लेखन-सहाय्यक सर्रास वापरात येण्यापूर्वीच्या, असोसिएशन फॉर कॉम्प्युटेशनल लिंग्विस्टिक्सच्या 2019 मधील परिषदांतील 4,744 शोधनिबंधांची तुलना त्याच परिषद-स्वरूपात 2026 मध्ये arXiv वर टाकलेल्या 1,821 NLP शोधनिबंधांशी केली.
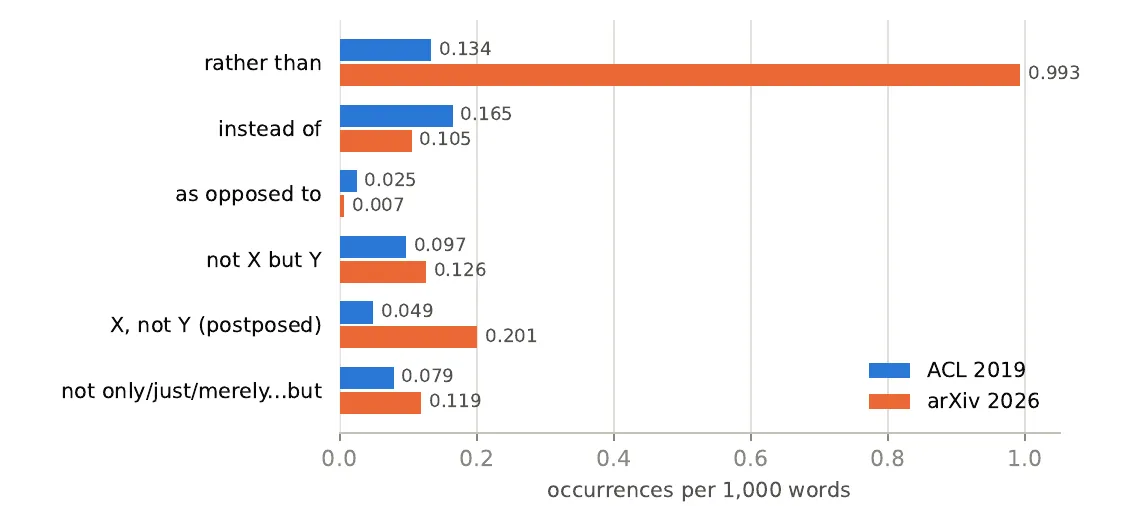
2019 (निळा) आणि 2026 (नारिंगी) शोधनिबंधांमध्ये दर 1,000 शब्दांमागील वापर: “rather than” आणि “X, not Y” झपाट्याने वाढतात, तर “instead of” आणि “as opposed to” घटतात. — Figure 1, Zamaraeva et al. (2026), arXiv:2610.10092.
- “Rather than” दर 1,000 शब्दांमागे 0.134 वरून 0.993 वापरांवर गेले, सुमारे सातपट जास्त.
- त्याच्याशी संबंधित “X, not Y” (X, Y नव्हे) चौपट झाले; दरम्यान “instead of” आणि “as opposed to” (च्या ऐवजी, च्या उलट) कमी सामान्य झाले.
- 2026 मधील 94% शोधनिबंधांत “rather than” आहे, 2019 मध्ये 36%, आणि ते सरासरी सुमारे आठ वेळा वापरतात. 2026 मधील एक शोधनिबंध ते 69 वेळा वापरतो, साधारण दर 170 शब्दांनी एकदा; 2019 मधील कोणताही शोधनिबंध 12 च्या पुढे जात नाही.
पथकाने मॉडेल्सकडून खऱ्या शोधनिबंधांच्या शीर्षक आणि सारांशावरून संपूर्ण शोधनिबंधही लिहून घेतले. GPT-5.6-sol आणि GPT-6-sol यांनी हा वाक्प्रचार प्रत्येक शोधनिबंधात, 2026 च्या लेखकांपेक्षाही जास्त वेळा वापरला. Anthropic च्या Claude Haiku 4.5, Sonnet 5.5 आणि Opus 5.5 यांनीही तो जवळजवळ प्रत्येक शोधनिबंधात वापरला, काहीशा कमी प्रमाणात. Tülu 3 8B या मुक्त मॉडेलने प्रशिक्षणाच्या कोणत्याही टप्प्यावर तो क्वचितच वापरला. शोधनिबंधांच्या सुधारणांनी ही सवय गेली नाही: त्याच 2026 शोधनिबंधांच्या नंतरच्या arXiv आवृत्त्यांमध्ये तो थोडा अधिकच आहे.
वैताग आणणारे, पण कोणते?
केवळ वारंवारतेवरून काहीच सिद्ध होत नाही: या वाक्प्रचाराचे अनेक रास्त उपयोग आहेत. म्हणून लेखकांपैकी दोघांनी, जे अनुभवी समीक्षक आहेत, स्रोत न दाखवता समोर ठेवलेल्या 1,000 वापरांना “वैताग आणणारे” किंवा “रास्त” असे लेबल लावले.
- 2019 मधील जवळजवळ कोणत्याही वापराने त्यांना वैताग आला नाही (एकाला 1.6%, दुसऱ्याला 0%).
- 2026 मधील सुमारे दहापैकी एका वापराने आला (11.5% आणि 8.3%).
- कोणते वापर वैताग आणणारे आहेत यावर ते क्वचितच सहमत झाले. पण 2026 च्या शोधनिबंधात इतके वापर असल्यामुळे, लेखकांच्या अंदाजानुसार 2026 मधील सुमारे निम्म्या शोधनिबंधांत त्या दोघांपैकी प्रत्येकाला वैताग आणणारा किमान एक वापर आहे, आणि जवळजवळ दोन-तृतीयांशांमध्ये किमान एकाला वैताग आणणारा — 2019 मध्ये हे प्रमाण सुमारे 1% होते.
वैताग आणणारे वापर वेगळे ठरतात ते मुख्यतः नाकारलेल्या पर्यायाला ते कसे वागवतात यामुळे. ते एका पर्यायाची स्तुती करून दुसऱ्याला कमी लेखण्याकडे झुकतात, आणि इतर लोकांनी नाकारलेला पर्याय बहुतेकदा पेंढ्याचा माणूस (स्ट्रॉ मॅन) ठरवला — अशी भूमिका जिचे कोणताही सक्षम संशोधक समर्थन करणार नाही. वाचकांनी वाक्प्रचारालाच AI लेखनाचे लक्षण मानले, पण GPT ने लिहिलेले उतारे 2019 मध्ये माणसांनी लिहिलेल्या उताऱ्यांपासून त्यांना वेगळे ओळखता आले नाहीत.
Claude चे निकाल, ज्यांना आतापर्यंत फक्त एकाच परीक्षकाने लेबल लावले आहे, संमिश्र आहेत. Claude च्या पहिल्या मसुद्यांनी 2019 च्या शोधनिबंधांपेक्षा जास्त वैताग आणला नाही, आणि GPT-6-sol च्या मसुद्यांपेक्षा कमी. त्याच्या सुधारित आवृत्त्यांनी GPT-6-sol इतकाच वारंवार वैताग आणला, त्याच्या स्वतःच्या पहिल्या मसुद्यांच्या साधारण दुप्पट. हा फरक “नकारांमुळे” आला, ज्यात लेखक स्वतःच्या कामाबद्दलचा अधिक ठाम दावा टाळतात (“तपासलेली यंत्रणा नव्हे, तर एक परिकल्पना”); मॉडेल्सनी शोधनिबंध सुधारले तेव्हा हे अधिक वारंवार झाले.
परीक्षकांकडून बक्षीस
ही सवय येते कुठून? चॅटबॉट्सना उत्तरांच्या जोड्यांवर सूक्ष्म-प्रशिक्षण (फाइन-ट्यूनिंग) दिले जाते, ज्यातील एक उत्तर माणूस किंवा AI परीक्षक पसंत करतो. अशा पसंतींच्या चार सार्वजनिक माहितीसंचांपैकी तीनमध्ये, “rather than” असलेली उत्तरे निवडली जाण्याची शक्यता जास्त होती, परीक्षक माणसे असताना सर्वांत स्पष्टपणे. चार मुक्त “रिवॉर्ड मॉडेल्सनी” एखाद्या वाक्याला त्याच्या “rather than” उपवाक्यासह, ते उपवाक्य नसतानाच्या तुलनेत जास्त गुण दिले, अगदी त्याच लांबीचे तटस्थ उपवाक्य त्याच्या जागी ठेवले तरीही. आणि मॉडेलला “प्रामाणिक” राहायला सांगितल्यावर ते हा वाक्प्रचार थोडा जास्त वापरू लागले.
लेखक अटकळ बांधतात की ही रचना अशा प्रशिक्षणाचा दुष्परिणाम आहे: चॅटबॉटच्या एकाच उत्तरात काळजीपूर्वक केलेला नकार प्रामाणिक वाटतो; संपूर्ण शोधनिबंधात, आणि संपूर्ण साहित्यात, पुनःपुन्हा आला की तो वकिलीसारखा वाटतो. वाक्प्रचारावर बंदी घातली तर बहुधा तेच कार्य दुसरीकडे सरकेल, जसे GPT-6-sol सुधारणा करताना “rather than” च्या जागी “X, not Y” आणते.
ही शैली पसरत आहे
अभ्यासाच्या स्पष्ट मर्यादा आहेत: दोन परीक्षक जे लेखकही आहेत, आणि Claude ची तुलना आतापर्यंत त्यांच्यापैकी एकानेच लेबल केलेली; नमुना-जुळवणी जी काही वापर चुकवू शकते; आणि पसंतींची माहिती जी फक्त सहसंबंध दाखवते. पण त्याचा निष्कर्ष एका वाक्प्रचाराच्या पलीकडे जातो. माणसांनी स्वाक्षरी केलेल्या शोधनिबंधांनी ही रचना उचलली आहे, त्यामुळे वैज्ञानिक साहित्याची शैली मॉडेल्सच्या शैलीकडे सरकत आहे — आणि मॉडेल्स पुढे त्याच साहित्यातून शिकतील.
हितसंबंधांचा संघर्ष. लेखक नमूद करतात की त्यांनी Claude Code (Claude Sonnet 5, Sonnet 5.5 आणि Opus 5.5) वापरून आपला कोड लिहिला, विश्लेषणे चालवली आणि Methods आणि Results विभागांसह संपूर्ण शोधनिबंधातील मजकुराचा मसुदा तयार केला, आणि मग तो हाताने संपादित केला — इतर गोष्टींबरोबरच निर्मितीदरम्यान आलेले दहा “rather than” काढून टाकले. Claude मॉडेल्स अभ्यासलेल्या प्रणालींपैकीही आहेत आणि त्यांनी स्वयंचलित परीक्षक म्हणूनही काम केले. हा लेखही Claude ने लिहिला आहे.