À L'ÈRE DE L'IA, LES ARTICLES DISENT « RATHER THAN » SEPT FOIS PLUS
Les grands modèles de langage aident désormais à écrire une bonne part des articles scientifiques, et ils laissent des traces : des mots favoris, un certain ton. Une habitude a commencé à agacer les chercheurs en traitement automatique des langues (TAL) : les phrases construites sur « X rather than Y » (« X plutôt que Y »), qui définissent une affirmation en partie par ce qu’elle n’est pas. Selon l’article, des relecteurs de la dernière session de soumissions aux conférences de TAL s’en sont plaints, et les organisateurs de conférences parlent désormais d’une écriture « truffée de tics d’IA ».
Olga Zamaraeva, Adrián Gude, Roi Santos-Ríos et Carlos Gómez-Rodríguez, de l’université de La Corogne en Espagne, ont entrepris de la mesurer — avec un titre qui fait la démonstration à lui seul (« Je préférerais quitter le TAL plutôt que de lire un autre article comme celui-ci »).
Sept fois plus
Ils ont comparé 4 744 articles des conférences de 2019 de l’Association for Computational Linguistics, avant la généralisation des assistants d’écriture par IA, à 1 821 articles de TAL déposés sur arXiv en 2026 au même format de conférence.
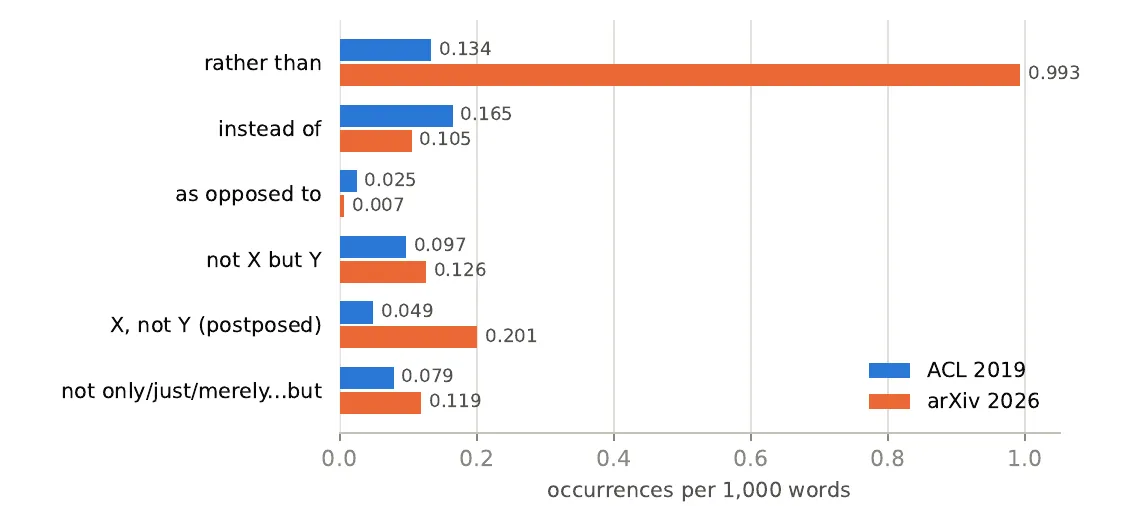
Occurrences pour 1 000 mots dans les articles de 2019 (bleu) et de 2026 (orange) : « rather than » et « X, not Y » s’envolent, tandis que « instead of » et « as opposed to » reculent. — Figure 1, Zamaraeva et al. (2026), arXiv:2610.10092.
- « Rather than » est passé de 0,134 à 0,993 occurrence pour 1 000 mots, environ sept fois plus.
- La tournure voisine « X, not Y » (« X, pas Y ») a quadruplé ; dans le même temps, « instead of » et « as opposed to » sont devenues moins fréquentes.
- 94 % des articles de 2026 contiennent « rather than », contre 36 % en 2019, et l’emploient environ huit fois en moyenne. Un article de 2026 l’utilise 69 fois, à peu près une fois tous les 170 mots ; aucun article de 2019 ne dépasse 12.
L’équipe a aussi fait écrire des articles complets par des modèles, à partir du titre et du résumé d’articles réels. GPT-5.6-sol et GPT-6-sol ont employé la tournure dans chaque article, plus souvent que les auteurs de 2026. Claude Haiku 4.5, Sonnet 5.5 et Opus 5.5, d’Anthropic, l’ont employée eux aussi dans presque chaque article, à des taux un peu plus bas. Un modèle ouvert, Tülu 3 8B, l’utilisait rarement, à tous les stades de son entraînement. Réviser les articles n’a pas fait disparaître l’habitude : les versions arXiv ultérieures des mêmes articles de 2026 en contiennent un peu plus.
Agaçant, mais lesquels ?
La fréquence seule ne prouve rien : la tournure a beaucoup d’usages légitimes. Deux des auteurs, relecteurs expérimentés, ont donc classé 1 000 usages présentés à l’aveugle comme « agaçants » ou « légitimes ».
- Presque aucun usage de 2019 ne les agaçait (1,6 % pour l’un, 0 % pour l’autre).
- Environ un usage de 2026 sur dix, si (11,5 % et 8,3 %).
- Ils s’accordaient rarement sur lesquels étaient agaçants. Mais comme un article de 2026 en contient beaucoup, les auteurs estiment qu’environ la moitié des articles de 2026 contient au moins un usage qui agace chacun d’eux, et près des deux tiers un usage qui agace au moins l’un d’eux — contre environ 1 % en 2019.
Ce qui distingue les usages agaçants tient surtout au traitement de l’option rejetée. Ils tendent à vanter une solution et à rabaisser l’autre, et d’autres personnes jugeaient plus souvent l’option rejetée comme un homme de paille, une position qu’aucun chercheur compétent ne défendrait. Les lecteurs prenaient aussi la tournure elle-même pour un signe d’écriture par IA, tout en étant incapables de distinguer des passages écrits par GPT de passages humains de 2019.
Les résultats sur Claude, étiquetés pour l’instant par un seul annotateur, sont nuancés. Les premiers jets de Claude n’agaçaient pas plus que les articles de 2019, et moins que ceux de GPT-6-sol. Ses révisions agaçaient aussi souvent que celles de GPT-6-sol, environ deux fois plus que ses propres premiers jets. La différence venait des « désaveux », où l’auteur décline une affirmation plus forte sur son propre travail (« une hypothèse plutôt qu’un mécanisme testé »), devenus plus fréquents quand les modèles révisaient leurs articles.
Récompensée par les évaluateurs
D’où vient l’habitude ? Les assistants conversationnels sont affinés sur des paires de réponses, dont l’une est préférée par un humain ou par une IA jugeuse. Dans quatre jeux de données publics de telles préférences, les réponses contenant « rather than » avaient plus de chances d’être choisies dans trois d’entre eux, le plus nettement quand les juges étaient humains. Quatre « modèles de récompense » ouverts notaient une phrase plus haut avec sa clause en « rather than » que sans elle, même quand une clause neutre de même longueur la remplaçait. Et demander à un modèle d’être « honnête » lui faisait employer la tournure un peu plus souvent.
Les auteurs avancent que la construction est un effet secondaire de ce type d’entraînement : dans une réponse isolée d’assistant, un désaveu prudent paraît honnête ; répété dans tout un article, et dans toute une littérature, il se lit comme un plaidoyer. Bannir la tournure ne ferait sans doute que déplacer la même fonction ailleurs, comme le fait GPT-6-sol qui remplace « rather than » par « X, not Y » en révision.
Un style qui se propage
L’étude a des limites claires : deux annotateurs qui sont aussi auteurs, une comparaison avec Claude étiquetée jusqu’ici par un seul d’entre eux, une détection par motifs qui peut manquer des usages, et des données de préférence qui ne montrent que des corrélations. Mais sa conclusion dépasse une simple tournure. Les articles signés par des humains ont adopté la construction ; le style de la littérature scientifique glisse donc vers celui des modèles — qui, à leur tour, apprendront de lui.
Conflit d’intérêts. Les auteurs indiquent avoir utilisé Claude Code (Claude Sonnet 5, Sonnet 5.5 et Opus 5.5) pour écrire leur code, lancer les analyses et rédiger du texte dans tout l’article, y compris les sections Méthodes et Résultats, avant de le retravailler à la main — en retirant notamment dix « rather than » introduits lors de la génération. Les modèles Claude font aussi partie des systèmes étudiés et ont servi d’évaluateurs automatiques. Claude a aussi écrit le présent article.