AI యుగపు పత్రాలు "RATHER THAN" ను ఏడు రెట్లు ఎక్కువగా అంటున్నాయి
పెద్ద భాషా మోడళ్లు ఇప్పుడు శాస్త్రీయ పత్రాల్లో చెప్పుకోదగ్గ భాగాన్ని రాయడంలో సహాయపడుతున్నాయి, అవి గుర్తులను వదిలివెళ్తాయి: ఇష్టమైన పదాలు, ఒక ప్రత్యేక స్వరం. ఒక అలవాటు సహజ భాషా ప్రక్రియ (NLP) పరిశోధకులకు చిరాకు తెప్పించడం మొదలుపెట్టింది: “X rather than Y” (Y కాకుండా X) అనే నిర్మాణంపై ఆధారపడిన వాక్యాలు, ఇవి ఒక వాదనను పాక్షికంగా అది ఏది కాదో దాని ద్వారా నిర్వచిస్తాయి. పత్రం ప్రకారం, NLP సదస్సులకు వచ్చిన తాజా విడత సమర్పణల సమీక్షకులు దీని గురించి ఫిర్యాదు చేశారు, సదస్సుల నిర్వాహకులు ఇప్పుడు “AI పడికట్టు పదాలతో నిండిన” రచన గురించి చర్చిస్తున్నారు.
స్పెయిన్లోని ఎ కొరూన్యా విశ్వవిద్యాలయానికి చెందిన ఓల్గా జమరాయెవా (Olga Zamaraeva), అడ్రియాన్ గుడె (Adrián Gude), రోయ్ సాంటోస్-రియోస్ (Roi Santos-Ríos), కార్లోస్ గోమెజ్-రోడ్రిగెజ్ (Carlos Gómez-Rodríguez) దీన్ని కొలవడానికి పూనుకున్నారు — తనంతట తానే విషయాన్ని చెప్పే శీర్షికతో (“ఇలాంటి మరో పత్రం చదవడం కంటే నేను NLP ని వదిలేయడమే మేలు”).
ఏడు రెట్లు ఎక్కువ
AI రచనా సహాయకాలు సాధారణం కాకముందు, 2019లో అసోసియేషన్ ఫర్ కంప్యుటేషనల్ లింగ్విస్టిక్స్ సదస్సుల నుంచి 4,744 పత్రాలను, అదే సదస్సు ఫార్మాట్లో 2026లో arXiv లో పెట్టిన 1,821 NLP పత్రాలతో వారు పోల్చారు.
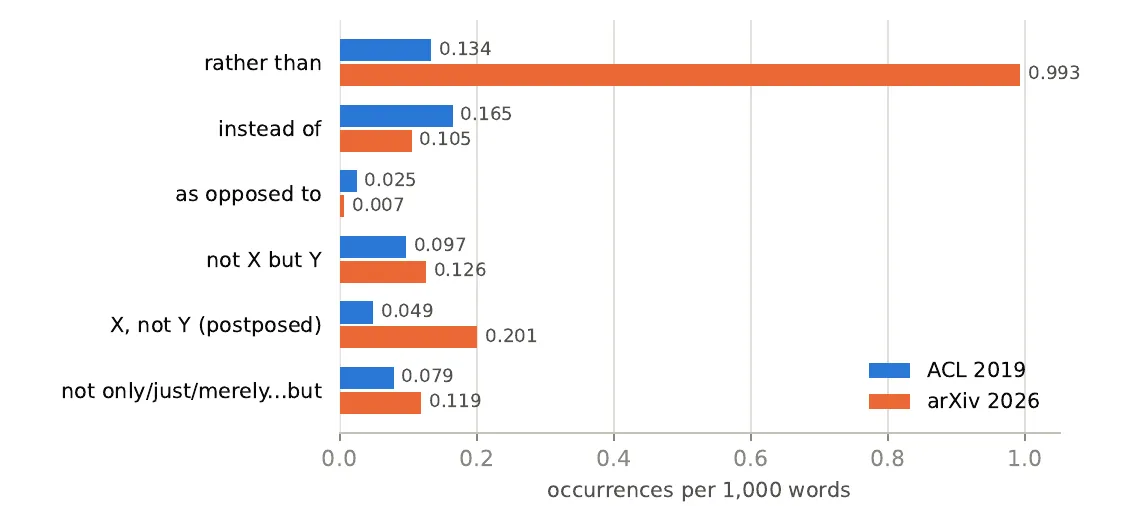
2019 (నీలం), 2026 (నారింజ) పత్రాల్లో ప్రతి 1,000 పదాలకు వాడకాలు: “rather than”, “X, not Y” దూసుకుపోతాయి, “instead of”, “as opposed to” తగ్గుతాయి. — Figure 1, Zamaraeva et al. (2026), arXiv:2610.10092.
- “Rather than” ప్రతి 1,000 పదాలకు 0.134 నుంచి 0.993 వాడకాలకు పెరిగింది, సుమారు ఏడు రెట్లు.
- సంబంధిత “X, not Y” (X, Y కాదు) నాలుగు రెట్లు అయింది; అదే సమయంలో “instead of”, “as opposed to” (బదులుగా, దానికి భిన్నంగా) తక్కువ సాధారణమయ్యాయి.
- 2026 పత్రాల్లో 94% పత్రాల్లో “rather than” ఉంది, 2019లో 36%, అవి సగటున దాన్ని సుమారు ఎనిమిది సార్లు వాడతాయి. 2026 నాటి ఒక పత్రం దాన్ని 69 సార్లు వాడింది, దాదాపు ప్రతి 170 పదాలకు ఒకసారి; 2019 నాటి ఏ పత్రమూ 12 దాటలేదు.
బృందం నిజమైన పత్రాల శీర్షిక, సారాంశం నుంచి మోడళ్లతో పూర్తి పత్రాలను రాయించింది కూడా. GPT-5.6-sol, GPT-6-sol ప్రతి పత్రంలోనూ ఈ పదబంధాన్ని, 2026 రచయితల కంటే ఎక్కువగా వాడాయి. Anthropic కి చెందిన Claude Haiku 4.5, Sonnet 5.5, Opus 5.5 కూడా దాదాపు ప్రతి పత్రంలో దాన్ని వాడాయి, కొంత తక్కువ రేట్లలో. ఒక ఓపెన్ మోడల్, Tülu 3 8B, తన శిక్షణలోని ఏ దశలోనూ దాన్ని అరుదుగా మాత్రమే వాడింది. పత్రాలను సవరించడం ఈ అలవాటును తొలగించలేదు: అవే 2026 పత్రాల తర్వాతి arXiv వెర్షన్లలో కొంచెం ఎక్కువగా ఉంది.
చిరాకు కలిగించేవి, కానీ ఏవి?
కేవలం తరచుదనం ఏమీ నిరూపించదు: ఈ పదబంధానికి న్యాయమైన వాడకాలు చాలా ఉన్నాయి. కాబట్టి రచయితల్లో ఇద్దరు, అనుభవజ్ఞులైన సమీక్షకులు, మూలం తెలియకుండా చూపిన 1,000 వాడకాలకు “చిరాకు కలిగించేది” లేదా “న్యాయమైనది” అని లేబుల్ వేశారు.
- 2019 నాటి దాదాపు ఏ వాడకమూ వారికి చిరాకు తెప్పించలేదు (ఒకరికి 1.6%, మరొకరికి 0%).
- 2026 నాటి సుమారు పదింట ఒక వాడకం తెప్పించింది (11.5%, 8.3%).
- ఏ వాడకాలు చిరాకు కలిగిస్తాయో దానిపై వారు అరుదుగా ఏకీభవించారు. కానీ 2026 పత్రంలో అవి చాలా ఎక్కువ ఉన్నందువల్ల, 2026 పత్రాల్లో సుమారు సగం పత్రాల్లో వారిలో ప్రతి ఒక్కరికీ చిరాకు తెప్పించే వాడకం కనీసం ఒకటి ఉందని, దాదాపు మూడింట రెండు వంతుల పత్రాల్లో కనీసం ఒకరికి చిరాకు తెప్పించేది ఉందని రచయితలు అంచనా వేశారు — 2019లో ఇది సుమారు 1%.
చిరాకు కలిగించే వాడకాలను వేరు చేసేది ప్రధానంగా అవి తిరస్కరించిన ఎంపికను ఎలా చూస్తాయన్నది. అవి ఒక ప్రత్యామ్నాయాన్ని పొగిడి మరొకదాన్ని తక్కువ చేసే ధోరణి చూపుతాయి, ఇతరులు తిరస్కరించిన ఎంపికను గడ్డి బొమ్మ (స్ట్రా మ్యాన్)గా — సమర్థుడైన ఏ పరిశోధకుడూ సమర్థించని వైఖరిగా — తరచుగా అంచనా వేశారు. పాఠకులు పదబంధాన్నే AI రచనకు సంకేతంగా తీసుకున్నారు, అయితే GPT రాసిన భాగాలను 2019లో మనుషులు రాసిన భాగాల నుంచి వేరు చేయలేకపోయారు.
ఇప్పటివరకు ఒక్క లేబులర్ మాత్రమే లేబుల్ వేసిన Claude ఫలితాలు మిశ్రమంగా ఉన్నాయి. Claude మొదటి చిత్తుప్రతులు 2019 పత్రాల కంటే ఎక్కువ చిరాకు తెప్పించలేదు, GPT-6-sol వాటి కంటే తక్కువ. దాని సవరణలు GPT-6-sol అంత తరచుగా చిరాకు తెప్పించాయి, దాని సొంత మొదటి చిత్తుప్రతుల కంటే సుమారు రెట్టింపు. ఈ తేడా “నిరాకరణల” నుంచి వచ్చింది, వీటిలో రచయితలు తమ సొంత పని గురించి బలమైన వాదనను తోసిపుచ్చుతారు (“పరీక్షించిన యంత్రాంగం కాకుండా ఒక పరికల్పన”); మోడళ్లు తమ పత్రాలను సవరించినప్పుడు ఇవి ఎక్కువయ్యాయి.
రేటర్ల నుంచి బహుమతి
ఈ అలవాటు ఎక్కడి నుంచి వస్తుంది? చాట్బాట్లను సమాధానాల జతలపై ఫైన్-ట్యూన్ చేస్తారు, వాటిలో ఒకదాన్ని మనిషి లేదా AI న్యాయనిర్ణేత ఇష్టపడతారు. అలాంటి ప్రాధాన్యతల నాలుగు పబ్లిక్ డేటాసెట్లలో మూడింటిలో, “rather than” ఉన్న సమాధానాలు ఎంపికయ్యే అవకాశం ఎక్కువగా ఉంది, న్యాయనిర్ణేతలు మనుషులైనప్పుడు అత్యంత స్పష్టంగా. నాలుగు ఓపెన్ “రివార్డ్ మోడళ్లు” ఒక వాక్యానికి దాని “rather than” ఉపవాక్యంతో, అది లేనప్పటి కంటే ఎక్కువ స్కోర్ ఇచ్చాయి, అదే పొడవున్న తటస్థ ఉపవాక్యాన్ని దాని స్థానంలో పెట్టినప్పుడు కూడా. ఒక మోడల్ను “నిజాయితీగా” ఉండమని చెబితే అది ఈ పదబంధాన్ని కొంచెం ఎక్కువగా వాడింది.
ఈ నిర్మాణం ఇలాంటి శిక్షణ యొక్క దుష్ప్రభావమని రచయితలు ఊహిస్తున్నారు: ఒక్క చాట్బాట్ సమాధానంలో, జాగ్రత్తైన నిరాకరణ నిజాయితీగా కనిపిస్తుంది; ఒక పత్రం మొత్తం, ఒక సాహిత్యం మొత్తం పునరావృతమైతే, అది వకాల్తాలా చదువుతుంది. పదబంధాన్ని నిషేధిస్తే బహుశా అదే పని మరో చోటికి మారుతుంది, GPT-6-sol సవరణ సమయంలో “rather than” ను “X, not Y” తో మార్చినట్టు.
ఈ శైలి వ్యాపిస్తోంది
అధ్యయనానికి స్పష్టమైన పరిమితులు ఉన్నాయి: రచయితలు కూడా అయిన ఇద్దరు లేబులర్లు, ఇప్పటివరకు వారిలో ఒక్కరే లేబుల్ వేసిన Claude పోలిక; కొన్ని వాడకాలను తప్పిపోగల నమూనా-సరిపోలిక; సహసంబంధాలను మాత్రమే చూపే ప్రాధాన్యత డేటా. కానీ దాని ముగింపు ఒక్క పదబంధాన్ని దాటి వెళ్తుంది. మనుషులు సంతకం చేసిన పత్రాలు ఈ నిర్మాణాన్ని స్వీకరించాయి, కాబట్టి శాస్త్రీయ సాహిత్యపు శైలి మోడళ్ల శైలి వైపు జారుతోంది — మోడళ్లు మళ్లీ దాని నుంచే నేర్చుకుంటాయి.
ప్రయోజన సంఘర్షణ. తాము Claude Code (Claude Sonnet 5, Sonnet 5.5, Opus 5.5) ను వాడి తమ కోడ్ రాశామని, విశ్లేషణలు నడిపామని, Methods, Results విభాగాలతో సహా పత్రం అంతటా వచనానికి చిత్తుప్రతి తయారుచేశామని, తర్వాత దాన్ని చేతితో సవరించామని రచయితలు పేర్కొన్నారు — ఇతర విషయాలతో పాటు, తయారీ సమయంలో వచ్చిన పది “rather than” లను తొలగించారు. Claude మోడళ్లు అధ్యయనం చేసిన వ్యవస్థల్లో కూడా ఉన్నాయి, స్వయంచాలక రేటర్లుగానూ పనిచేశాయి. ఈ వ్యాసాన్ని కూడా Claude రాసింది.