مقالههای عصر هوش مصنوعی هفت برابر بیشتر میگویند «rather than»
مدلهای زبانی بزرگ اکنون در نوشتن بخش قابلتوجهی از مقالههای علمی کمک میکنند و ردپایی برجا میگذارند: واژههای محبوب، لحنی خاص. یک عادت آزردن پژوهشگران پردازش زبان طبیعی (NLP) را آغاز کرده است: جملههایی که بر پایهٔ «X rather than Y» («X به جای Y») ساخته میشوند و ادعایی را تا حدی با آنچه نیست تعریف میکنند. به گفتهٔ مقاله، داوران تازهترین دور مقالههای ارسالی به همایشهای NLP از آن شکایت کردند، و برگزارکنندگان همایشها اکنون دربارهٔ نوشتههای «آکنده از کلیشههای هوش مصنوعی» بحث میکنند.
اولگا زامارایوا، آدریان گوده، روی سانتوسریوس و کارلوس گومسرودریگس، در دانشگاه آکورونیا در اسپانیا، به سنجش آن پرداختند — با عنوانی که خودش حرف را میزند.
هفت برابر بیشتر
آنها ۴٬۷۴۴ مقاله از نشستهای ۲۰۱۹ انجمن زبانشناسی رایانشی (Association for Computational Linguistics)، پیش از رواج دستیارهای نگارش هوش مصنوعی، را با ۱٬۸۲۱ مقالهٔ NLP که در ۲۰۲۶ با همان قالب همایش در arXiv منتشر شده بودند مقایسه کردند.
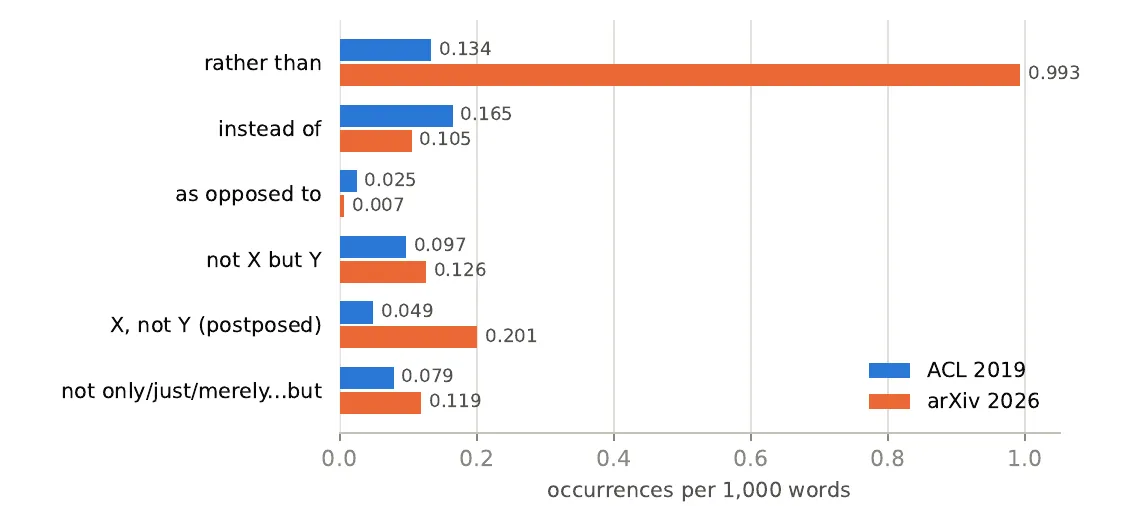
بسامد در هر ۱٬۰۰۰ واژه در مقالههای ۲۰۱۹ (آبی) و ۲۰۲۶ (نارنجی): «rather than» و «X, not Y» اوج میگیرند، در حالی که «instead of» و «as opposed to» کاهش مییابند. — Figure 1, Zamaraeva et al. (2026), arXiv:2610.10092.
- «rather than» از ۰٫۱۳۴ به ۰٫۹۹۳ بار در هر ۱٬۰۰۰ واژه رسید، یعنی حدود هفت برابر.
- عبارت همخانوادهٔ «X, not Y» («X، نه Y») چهار برابر شد؛ در همین حال «instead of» و «as opposed to» («به جای»، «در مقابلِ») کمکاربردتر شدند.
- ۹۴٪ مقالههای ۲۰۲۶ «rather than» دارند، در برابر ۳۶٪ در ۲۰۱۹، و بهطور میانگین حدود هشت بار آن را به کار میبرند. یک مقالهٔ ۲۰۲۶ آن را ۶۹ بار، تقریباً هر ۱۷۰ واژه یک بار، به کار میبرد؛ هیچ مقالهای از ۲۰۱۹ از ۱۲ بار فراتر نمیرود.
گروه همچنین از مدلها خواست بر اساس عنوان و چکیدهٔ مقالههای واقعی، مقالههایی کامل بنویسند. GPT-5.6-sol و GPT-6-sol این عبارت را در همهٔ مقالهها، و بیشتر از نویسندگان ۲۰۲۶، به کار بردند. Claude Haiku 4.5، Sonnet 5.5 و Opus 5.5 از Anthropic نیز آن را تقریباً در همهٔ مقالهها، با نرخهایی اندکی پایینتر، به کار بردند. یک مدل باز به نام Tülu 3 8B در هیچ مرحلهای از آموزشش آن را جز بهندرت به کار نبرد. بازنگری مقالهها این عادت را از میان نبرد: نسخههای بعدی همان مقالههای ۲۰۲۶ در arXiv کمی بیشتر از آن دارند.
آزارنده، اما کدامها؟
بسامد بهتنهایی چیزی را ثابت نمیکند: این عبارت کاربردهای مشروع فراوانی دارد. از این رو دو تن از نویسندگان که داوران باتجربهای هستند، ۱٬۰۰۰ کاربرد را که بهصورت کور به آنها نشان داده شد، «آزارنده» یا «مشروع» برچسب زدند.
- تقریباً هیچ کاربردی از ۲۰۱۹ آنها را نیازرد (۱٫۶٪ برای یکی، ۰٪ برای دیگری).
- حدود یک کاربرد از هر ده کاربرد ۲۰۲۶ آزارشان داد (۱۱٫۵٪ و ۸٫۳٪).
- آنها بهندرت بر سر اینکه کدام کاربردها آزارندهاند توافق داشتند. اما چون یک مقالهٔ ۲۰۲۶ کاربردهای بسیار زیادی دارد، نویسندگان برآورد میکنند که حدود نیمی از مقالههای ۲۰۲۶ دستکم یک کاربرد دارند که هر یک از آن دو را میآزارد، و نزدیک به دو سوم کاربردی دارند که دستکم یکی از آن دو را میآزارد — در برابر حدود ۱٪ در ۲۰۱۹.
آنچه کاربردهای آزارنده را متمایز میکند عمدتاً شیوهٔ برخوردشان با گزینهٔ ردشده است. آنها گرایش دارند یک گزینه را بستایند و دیگری را کوچک بشمارند، و افراد دیگر نیز گزینهٔ ردشده را بیشتر یک پهلوانپنبه، یعنی موضعی که هیچ پژوهشگر کاردانی از آن دفاع نمیکند، ارزیابی کردند. خوانندگان خود این عبارت را نیز نشانهٔ نگارش هوش مصنوعی دانستند، در حالی که نمیتوانستند بخشهای نوشتهشده با GPT را از بخشهای نوشتهشده توسط انسان در ۲۰۱۹ تشخیص دهند.
نتایج Claude، که تا کنون تنها یک برچسبزن آنها را برچسب زده، دوگانه است. پیشنویسهای نخست Claude بیش از مقالههای ۲۰۱۹ آزارنده نبودند و کمتر از پیشنویسهای GPT-6-sol آزار میدادند. بازنگریهایش به همان اندازهٔ بازنگریهای GPT-6-sol آزارنده بودند، حدود دو برابر پیشنویسهای نخست خودش. تفاوت از «انکارها» میآمد، که در آنها نویسندگان از ادعایی قویتر دربارهٔ کار خودشان کناره میگیرند («یک فرضیه به جای سازوکاری آزمودهشده»)، و هنگامی که مدلها مقالههایشان را بازنگری کردند بیشتر شدند.
پاداش از سوی ارزیابان
این عادت از کجا میآید؟ چتباتها روی جفتپاسخهایی تنظیم دقیق میشوند که یک انسان یا یک داور هوش مصنوعی یکی از آنها را ترجیح میدهد. در چهار مجموعهدادهٔ عمومی از چنین ترجیحهایی، پاسخهای دارای «rather than» در سه مجموعه احتمال بیشتری برای انتخاب شدن داشتند، بهروشنترین شکل وقتی داوران انسان بودند. چهار «مدل پاداش» (reward model) باز، جملهای را با بند «rather than»اش امتیاز بالاتری دادند تا بدون آن، حتی وقتی بندی خنثی با همان طول جایگزینش شد. و گفتن به یک مدل که «صادق» باشد باعث شد کمی بیشتر از این عبارت استفاده کند.
نویسندگان حدس میزنند که این ساختار پیامد جانبی این نوع آموزش است: در یک پاسخ منفرد چتبات، یک انکار محتاطانه صادقانه به نظر میرسد؛ اما وقتی در سراسر یک مقاله، و سراسر یک ادبیات علمی، تکرار شود، همچون جانبداری خوانده میشود. ممنوع کردن این عبارت احتمالاً فقط همان کارکرد را به جای دیگری منتقل میکند، همانطور که GPT-6-sol هنگام بازنگری «rather than» را با «X, not Y» عوض میکند.
این سبک در حال گسترش است
این پژوهش محدودیتهای روشنی دارد: دو برچسبزن که خود از نویسندگاناند، و مقایسهٔ Claude که تا کنون تنها یکی از آنها برچسبش زده است؛ تطبیق الگویی که ممکن است برخی کاربردها را از قلم بیندازد؛ و دادههای ترجیحی که تنها همبستگی نشان میدهند. اما نتیجهگیری آن از یک عبارت فراتر میرود. مقالههایی که انسانها امضا کردهاند این ساختار را برگرفتهاند، پس سبک ادبیات علمی به سوی سبک مدلها میلغزد — مدلهایی که به نوبهٔ خود از آن خواهند آموخت.
تعارض منافع. نویسندگان بیان میکنند که از Claude Code (Claude Sonnet 5، Sonnet 5.5 و Opus 5.5) برای نوشتن کدهایشان، اجرای تحلیلها و پیشنویس کردن متن در سراسر مقاله، از جمله بخشهای روشها و نتایج، استفاده کردهاند و سپس آن را دستی ویرایش کردهاند — از جمله با حذف ده «rather than» که هنگام تولید وارد شده بود. مدلهای Claude همچنین در شمار سامانههای بررسیشدهاند و در نقش ارزیاب خودکار به کار رفتند. Claude همچنین نویسندهٔ همین مقاله است.