YAPAY ZEKÂ ÇAĞININ MAKALELERİ "RATHER THAN" İFADESİNİ YEDİ KAT DAHA SIK KULLANIYOR
Büyük dil modelleri artık bilimsel makalelerin önemli bir kısmının yazılmasına yardım ediyor ve iz bırakıyor: gözde kelimeler, belirli bir ton. Bir alışkanlık doğal dil işleme (NLP) araştırmacılarını rahatsız etmeye başladı: bir iddiayı kısmen ne olmadığıyla tanımlayan, “X rather than Y” (“Y yerine X”) üzerine kurulu cümleler. Makaleye göre NLP konferanslarına yapılan son başvuru turunun hakemleri bundan şikâyet etti ve konferans düzenleyicileri artık “yapay zekâ klişeleriyle dolu” yazımı tartışıyor.
İspanya’daki A Coruña Üniversitesi’nden Olga Zamaraeva, Adrián Gude, Roi Santos-Ríos ve Carlos Gómez-Rodríguez bunu ölçmeye koyuldu — meseleyi kendi başına anlatan bir başlıkla.
Yedi kat daha fazla
Yapay zekâ yazım asistanları yaygınlaşmadan önceki 2019 Hesaplamalı Dilbilim Derneği (Association for Computational Linguistics) toplantılarından 4.744 makaleyi, 2026’da aynı konferans biçiminde arXiv’e yüklenmiş 1.821 NLP makalesiyle karşılaştırdılar.
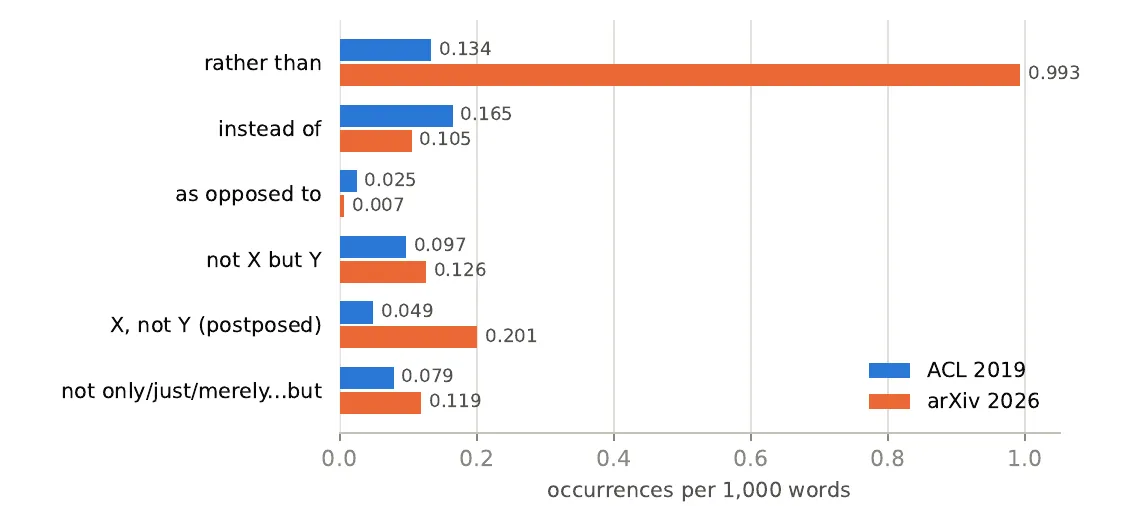
2019 (mavi) ve 2026 (turuncu) makalelerinde 1.000 kelime başına görülme sıklığı: “rather than” ve “X, not Y” fırlarken, “instead of” ve “as opposed to” geriliyor. — Figure 1, Zamaraeva et al. (2026), arXiv:2610.10092.
- “Rather than”, 1.000 kelimede 0,134’ten 0,993 kullanıma yükseldi; yaklaşık yedi kat artış.
- İlişkili “X, not Y” (“Y değil, X”) dört katına çıktı; bu arada “instead of” ve “as opposed to” (“yerine”, “aksine”) daha az yaygın hâle geldi.
- 2026 makalelerinin %94’ü “rather than” içeriyor (2019’da %36) ve onu ortalamada yaklaşık sekiz kez kullanıyor. 2026’dan bir makale onu 69 kez, kabaca her 170 kelimede bir kullanıyor; 2019 makalelerinin hiçbiri 12’yi aşmıyor.
Ekip ayrıca modellere, gerçek makalelerin başlık ve özetinden yola çıkarak eksiksiz makaleler yazdırdı. GPT-5.6-sol ve GPT-6-sol ifadeyi her makalede, 2026 yazarlarından daha sık kullandı. Anthropic’in Claude Haiku 4.5, Sonnet 5.5 ve Opus 5.5 modelleri de onu neredeyse her makalede, biraz daha düşük oranlarda kullandı. Açık bir model olan Tülu 3 8B ise eğitiminin hiçbir aşamasında onu nadiren kullandı. Makaleleri gözden geçirmek alışkanlığı ortadan kaldırmadı: aynı 2026 makalelerinin sonraki arXiv sürümleri biraz daha fazlasını içeriyor.
Rahatsız edici, ama hangileri?
Sıklık tek başına hiçbir şey kanıtlamaz: ifadenin pek çok meşru kullanımı var. Bu yüzden yazarlardan deneyimli hakem olan ikisi, kör olarak gösterilen 1.000 kullanımı “rahatsız edici” ya da “meşru” olarak etiketledi.
- 2019 kullanımlarının neredeyse hiçbiri onları rahatsız etmedi (biri için %1,6, diğeri için %0).
- 2026 kullanımlarının yaklaşık onda biri etti (%11,5 ve %8,3).
- Hangi kullanımların rahatsız edici olduğunda nadiren anlaştılar. Ama bir 2026 makalesi bu kadar çok kullanım içerdiğinden yazarlar, 2026 makalelerinin yaklaşık yarısının her birini rahatsız eden en az bir kullanım, neredeyse üçte ikisinin de en az birini rahatsız eden bir kullanım içerdiğini tahmin ediyor — 2019’da yaklaşık %1’e karşı.
Rahatsız edici kullanımları ayıran şey, esas olarak reddedilen seçeneği nasıl ele aldıkları. Bir alternatifi övüp diğerini küçümseme eğilimindeler; başka kişiler de reddedilen seçeneği daha sık bir saman adam, yani hiçbir yetkin araştırmacının savunmayacağı bir konum olarak değerlendirdi. Okurlar ifadenin kendisini de yapay zekâ yazımının bir işareti olarak algıladı; oysa GPT’nin yazdığı pasajları 2019’da insanların yazdıklarından ayırt edemiyorlardı.
Şimdiye kadar yalnızca bir etiketleyici tarafından işaretlenen Claude sonuçları karışık. Claude’un ilk taslakları 2019 makalelerinden daha fazla rahatsız etmedi ve GPT-6-sol’unkilerden daha az rahatsız etti. Gözden geçirmeleri ise GPT-6-sol’unkiler kadar sık rahatsız etti; kendi ilk taslaklarının yaklaşık iki katı. Fark, yazarların kendi çalışmaları hakkında daha güçlü bir iddiayı reddettiği “feragatlerden” (“test edilmiş bir mekanizma yerine bir hipotez”) geliyordu; bunlar modeller makalelerini gözden geçirdiğinde daha sık hâle geldi.
Değerlendiriciler tarafından ödüllendirilen
Alışkanlık nereden geliyor? Sohbet robotları, bir insanın ya da bir yapay zekâ hakeminin birini tercih ettiği yanıt çiftleri üzerinde ince ayardan geçirilir. Bu tür tercihlerden oluşan dört kamuya açık veri kümesinin üçünde, “rather than” içeren yanıtların seçilme olasılığı daha yüksekti; en belirgin şekilde de değerlendiriciler insan olduğunda. Dört açık “ödül modeli” (reward model), bir cümleyi “rather than” yan cümlesiyle, onsuz hâline göre daha yüksek puanladı; yerine aynı uzunlukta nötr bir yan cümle konduğunda bile. Bir modele “dürüst” olmasını söylemek de ifadeyi biraz daha fazla kullanmasına yol açtı.
Yazarlar bu yapının bu tür eğitimin bir yan etkisi olduğunu öne sürüyor: tek bir sohbet robotu yanıtında dikkatli bir feragat dürüst görünür; bütün bir makale ve bütün bir literatür boyunca tekrarlandığında ise savunuculuk gibi okunur. İfadeyi yasaklamak muhtemelen aynı işlevi başka bir yere taşımaktan öteye geçmezdi; GPT-6-sol’un gözden geçirme sırasında “rather than” yerine “X, not Y” kullandığında yaptığı gibi.
Üslup yayılıyor
Çalışmanın açık sınırları var: aynı zamanda yazar olan iki etiketleyici ve şimdiye kadar yalnızca biri tarafından etiketlenen Claude karşılaştırması; kullanımları kaçırabilecek örüntü eşleştirme; ve yalnızca korelasyon gösteren tercih verileri. Ama vardığı sonuç tek bir ifadenin ötesine geçiyor. İnsanların imzaladığı makaleler bu yapıyı benimsedi; böylece bilimsel literatürün üslubu modellerinkine doğru kayıyor — modeller de sırası geldiğinde ondan öğrenecek.
Çıkar çatışması. Yazarlar, kodlarını yazmak, analizleri yürütmek ve Yöntemler ile Sonuçlar bölümleri dahil makalenin tamamında metin taslakları hazırlamak için Claude Code’u (Claude Sonnet 5, Sonnet 5.5 ve Opus 5.5) kullandıklarını, ardından metni elle düzenlediklerini belirtiyor — diğer şeylerin yanı sıra üretim sırasında eklenen on “rather than” ifadesini çıkararak. Claude modelleri ayrıca incelenen sistemler arasında yer alıyor ve otomatik değerlendirici olarak kullanıldı. Bu makaleyi de Claude yazdı.