AI時代の論文は「rather than」を7倍も多く使う
大規模言語モデルは、いまや科学論文のかなりの部分の執筆を手伝っており、痕跡を残している。お気に入りの単語や、ある種の口調だ。そのうちの一つの癖が、自然言語処理(NLP)の研究者たちをいらだたせはじめた。**「X rather than Y」(YではなくX)**という形の文で、ある主張を、それが何でないかによって部分的に定義するものだ。論文によれば、最近のNLP国際会議への投稿の査読者たちがこれに不満を述べ、会議の主催者たちは「AIの決まり文句だらけ」の文章について議論している。
スペインのア・コルーニャ大学のオルガ・ザマラエヴァ(Olga Zamaraeva)、アドリアン・グデ(Adrián Gude)、ロイ・サントス=リオス(Roi Santos-Ríos)、カルロス・ゴメス=ロドリゲス(Carlos Gómez-Rodríguez)は、これを測定することにした。論文のタイトルそのものが主張を物語っている(「こんな論文をもう一本読むくらいなら、NLPをやめたほうがましだ」)。
7倍に
彼らは、AIの執筆支援がまだ一般的でなかった2019年の計算言語学会(ACL)の会議の論文4,744本と、同じ会議の書式で2026年にarXivに投稿されたNLP論文1,821本を比較した。
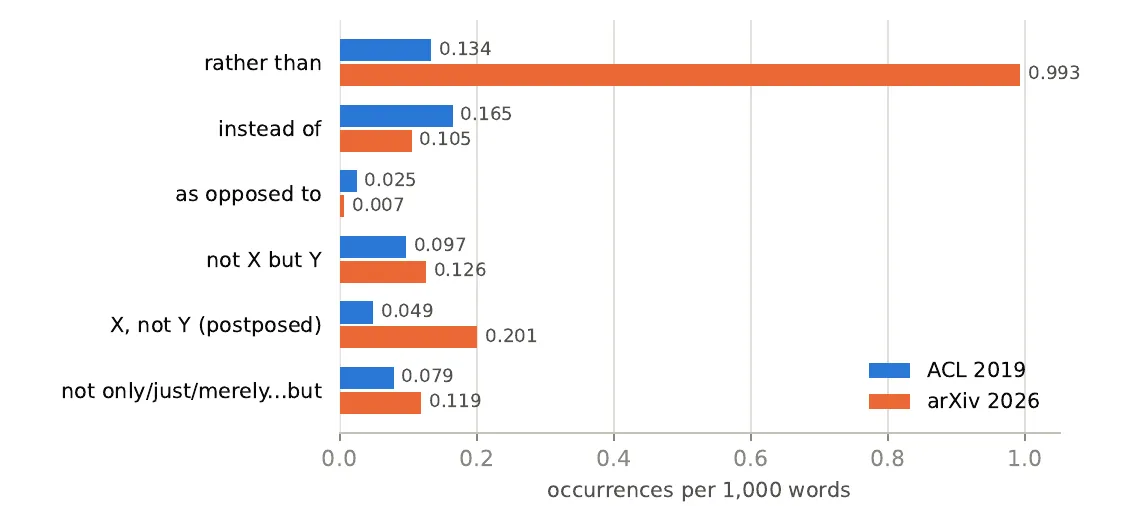
2019年(青)と2026年(オレンジ)の論文における1,000語あたりの出現回数。「rather than」と「X, not Y」は急増し、「instead of」と「as opposed to」は減っている。— Figure 1, Zamaraeva et al. (2026), arXiv:2610.10092.
- 「rather than」は1,000語あたり0.134回から0.993回に増えた。およそ7倍だ。
- 関連する「X, not Y」(Yではない、Xだ)は4倍になった。一方、「instead of」と「as opposed to」(いずれも「〜の代わりに」「〜とは対照的に」)は減った。
- 2026年の論文の94%が「rather than」を含み(2019年は36%)、平均で約8回使っている。2026年のある論文は69回、およそ170語に1回使っている。2019年の論文で12回を超えるものはない。
チームはさらに、実在の論文のタイトルと要旨から、モデルに論文をまるごと書かせた。GPT-5.6-solとGPT-6-solは、すべての論文でこの言い回しを、2026年の著者たちよりも頻繁に使った。AnthropicのClaude Haiku 4.5、Sonnet 5.5、Opus 5.5も、頻度はやや低いものの、ほぼすべての論文で使った。オープンなモデルであるTülu 3 8Bは、訓練のどの段階でもめったに使わなかった。論文を改訂してもこの癖は消えなかった。同じ2026年の論文のarXivの後の版のほうが、わずかに多く含んでいる。
いらだたしい、でもどれが?
頻度だけでは何も証明できない。この言い回しには正当な使い方もたくさんあるからだ。そこで著者のうち経験豊かな査読者2人が、出どころを伏せて示された1,000件の用例に「いらだたしい」か「正当」かのラベルをつけた。
- 2019年の用例でいらだたしいものは、ほとんどなかった(1人は1.6%、もう1人は0%)。
- 2026年の用例では約10件に1件がいらだたしかった(11.5%と8.3%)。
- どの用例がいらだたしいかについて、2人の意見はめったに一致しなかった。だが2026年の論文にはこの言い回しがとても多く含まれているので、著者らの推定では、2026年の論文の約半数に2人それぞれをいらだたせる用例が少なくとも一つあり、3分の2近くには少なくとも一方をいらだたせる用例がある。2019年では約1%だった。
いらだたしい用例を際立たせているのは、主に退けられた選択肢の扱い方だ。それらは一方の選択肢をほめ、もう一方をけなす傾向がある。また、他の人々は、退けられた選択肢をわら人形(まともな研究者ならだれも擁護しないような立場)だと判断することが多かった。読み手はこの言い回しそのものをAIによる執筆の印とみなしたが、GPTが書いた文章と、2019年に人間が書いた文章を見分けることはできなかった。
Claudeについての結果は、いまのところ1人の評価者だけがラベルをつけたもので、まちまちだ。Claudeの初稿は2019年の論文以上にはいらだたせず、GPT-6-solの初稿よりもいらだたしさが少なかった。ところが改訂版はGPT-6-solと同じくらいの頻度でいらだたせ、自分の初稿のおよそ2倍だった。違いを生んだのは「否認」だ。著者が自分の研究についてより強い主張を控えるもので(「検証済みの仕組みではなく、仮説」)、モデルが論文を改訂するとこれが増えた。
評価者が報いる
この癖はどこから来るのだろうか。チャットボットは、二つの回答の組のうち人間またはAIの審査員が好んだほうを使って微調整される。そうした好みを集めた四つの公開データセットのうち三つで、「rather than」を含む回答のほうが選ばれやすかった。審査員が人間の場合にそれがいちばんはっきりしていた。四つのオープンな「報酬モデル」は、「rather than」の節がある文に、それがない文よりも高い点をつけた。同じ長さの中立的な節に置き換えた場合と比べても同じだった。さらに、モデルに「正直であれ」と指示すると、この言い回しをわずかに多く使うようになった。
著者らは、この構文はこの種の訓練の副作用ではないかと推測している。チャットボットの一つの回答の中なら、慎重な否認は誠実に見える。だが論文全体、さらには文献全体でくり返されると、それは何かを売り込む主張のように読める。この言い回しを禁止しても、同じ働きがおそらく別のところへ移るだけだろう。GPT-6-solが改訂中に「rather than」を「X, not Y」に入れ替えるように。
広がる文体
この研究には明らかな限界がある。評価者2人は著者でもあり、Claudeとの比較はいまのところそのうち1人しかラベルをつけていない。パターン照合では見落とす用例があるかもしれない。好みのデータは相関を示すだけだ。それでも結論は一つの言い回しにとどまらない。人間が署名した論文がこの構文を取り入れており、科学文献の文体はモデルの文体へと流れている。そしてモデルは、今度はその文献から学ぶことになる。
利益相反。 著者らは、Claude Code(Claude Sonnet 5、Sonnet 5.5、Opus 5.5)を使ってコードを書き、分析を実行し、「方法」と「結果」の節を含む論文全体の文章の下書きをつくったうえで、手作業で編集したと述べている。その過程で、生成中に入りこんだ「rather than」を10か所取り除いたという。Claudeのモデルは研究対象のシステムの一つでもあり、自動評価者としても使われた。この記事を書いたのもClaudeである。