AI युग के शोधपत्र “rather than” सात गुना ज़्यादा बार कहते हैं
बड़े भाषा मॉडल अब वैज्ञानिक शोधपत्रों के अच्छे-ख़ासे हिस्से को लिखने में मदद करते हैं, और वे निशान छोड़ जाते हैं: पसंदीदा शब्द, एक ख़ास लहजा। एक आदत ने प्राकृतिक भाषा संसाधन (NLP) के शोधकर्ताओं को चिढ़ाना शुरू कर दिया है: “X rather than Y” (Y के बजाय X) पर बने वाक्य, जो किसी दावे को आंशिक रूप से इस बात से परिभाषित करते हैं कि वह क्या नहीं है। शोधपत्र के अनुसार, NLP सम्मेलनों में भेजे गए शोधपत्रों के ताज़ा दौर के समीक्षकों ने इसकी शिकायत की, और सम्मेलन आयोजक अब “AI के घिसे-पिटे ढर्रों से भरे” (AI-trope-ridden) लेखन पर चर्चा करते हैं।
स्पेन के आ कोरुन्या विश्वविद्यालय की ओल्गा ज़मारायेवा (Olga Zamaraeva), आद्रियान गुदे (Adrián Gude), रोई सांतोस-रिओस (Roi Santos-Ríos) और कार्लोस गोमेज़-रोड्रिगेज़ (Carlos Gómez-Rodríguez) ने इसे मापने का बीड़ा उठाया — एक ऐसे शीर्षक के साथ जो अपने आप में बात कह देता है।
सात गुना ज़्यादा
उन्होंने एसोसिएशन फ़ॉर कम्प्यूटेशनल लिंग्विस्टिक्स की 2019 की बैठकों के 4,744 शोधपत्रों की, जब AI लेखन सहायक आम नहीं थे, तुलना 2026 में उसी सम्मेलन-प्रारूप में arXiv पर डाले गए 1,821 NLP शोधपत्रों से की।
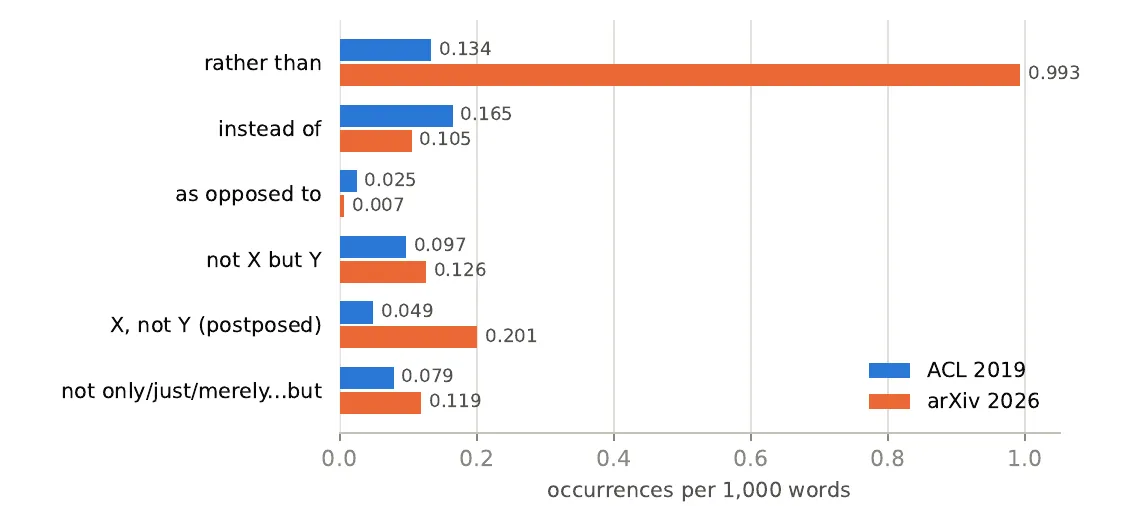
2019 (नीला) और 2026 (नारंगी) के शोधपत्रों में प्रति 1,000 शब्दों पर उपस्थिति: “rather than” और “X, not Y” तेज़ी से बढ़ते हैं, जबकि “instead of” और “as opposed to” घटते हैं। — चित्र 1, Zamaraeva et al. (2026), arXiv:2610.10092.
- “rather than” प्रति 1,000 शब्दों पर 0.134 से 0.993 बार तक पहुँचा, लगभग सात गुना ज़्यादा।
- इससे जुड़ा “X, not Y” (X, Y नहीं) चार गुना हो गया; वहीं “instead of” (की जगह) और “as opposed to” (के विपरीत) कम आम हो गए।
- 2026 के 94% शोधपत्रों में “rather than” है, जबकि 2019 में 36% में था, और वे इसे औसतन लगभग आठ बार इस्तेमाल करते हैं। 2026 का एक शोधपत्र इसे 69 बार इस्तेमाल करता है, मोटे तौर पर हर 170 शब्दों में एक बार; 2019 का कोई शोधपत्र 12 से आगे नहीं जाता।
टीम ने मॉडलों से असली शोधपत्रों के शीर्षक और सार के आधार पर पूरे शोधपत्र भी लिखवाए। GPT-5.6-sol और GPT-6-sol ने हर शोधपत्र में यह वाक्यांश इस्तेमाल किया, 2026 के लेखकों से भी ज़्यादा बार। Anthropic के Claude Haiku 4.5, Sonnet 5.5 और Opus 5.5 ने भी लगभग हर शोधपत्र में इसका इस्तेमाल किया, कुछ कम दरों पर। एक खुले मॉडल, Tülu 3 8B, ने अपने प्रशिक्षण के किसी भी चरण में इसे शायद ही इस्तेमाल किया। शोधपत्रों में संशोधन से यह आदत नहीं गई: उन्हीं 2026 शोधपत्रों के बाद के arXiv संस्करणों में यह थोड़ा ज़्यादा है।
खिझाने वाले, पर कौन-से?
अकेली आवृत्ति कुछ साबित नहीं करती: इस वाक्यांश के बहुत से जायज़ इस्तेमाल हैं। इसलिए दो लेखकों ने, जो अनुभवी समीक्षक हैं, बिना स्रोत जाने दिखाए गए 1,000 इस्तेमालों को “खिझाने वाला” या “जायज़” के रूप में चिह्नित किया।
- 2019 के लगभग किसी इस्तेमाल ने उन्हें नहीं खिझाया (एक के लिए 1.6%, दूसरे के लिए 0%)।
- 2026 के लगभग दस में से एक इस्तेमाल ने खिझाया (11.5% और 8.3%)।
- कौन-से इस्तेमाल खिझाने वाले थे, इस पर वे शायद ही सहमत हुए। लेकिन चूँकि 2026 के एक शोधपत्र में ऐसे बहुत सारे होते हैं, लेखकों का अनुमान है कि 2026 के लगभग आधे शोधपत्रों में कम से कम एक ऐसा इस्तेमाल है जो उनमें से हर एक को खिझाता है, और लगभग दो-तिहाई में ऐसा एक जो कम से कम उनमें से एक को खिझाता है — जबकि 2019 में यह लगभग 1% था।
खिझाने वाले इस्तेमालों को अलग करने वाली मुख्य बात यह है कि वे ठुकराए गए विकल्प के साथ कैसा बर्ताव करते हैं। वे एक विकल्प की तारीफ़ करने और दूसरे को छोटा दिखाने की प्रवृत्ति रखते हैं, और दूसरे लोगों ने भी ज़्यादा बार ठुकराए गए विकल्प को एक स्ट्रॉ मैन (straw man) माना, यानी ऐसी स्थिति जिसका बचाव कोई सक्षम शोधकर्ता नहीं करेगा। पाठकों ने वाक्यांश को ही AI लेखन का संकेत माना, जबकि वे GPT द्वारा लिखे अंशों को 2019 में मनुष्यों द्वारा लिखे अंशों से अलग नहीं कर पाए।
Claude के नतीजे, जिन्हें अभी तक केवल एक व्याख्याकार ने चिह्नित किया है, मिले-जुले हैं। Claude के पहले मसौदों ने 2019 के शोधपत्रों से ज़्यादा नहीं खिझाया और GPT-6-sol के मसौदों से कम। उसके संशोधनों ने GPT-6-sol के संशोधनों जितनी ही बार खिझाया, अपने पहले मसौदों से लगभग दोगुनी बार। फ़र्क़ “अस्वीकरणों” (disavowals) से आया, जिनमें लेखक अपने ही काम के बारे में किसी मज़बूत दावे से इनकार करते हैं (“एक परखी हुई क्रियाविधि के बजाय एक परिकल्पना”), और जो मॉडलों के अपने शोधपत्र संशोधित करने पर ज़्यादा बार आने लगे।
मूल्यांकनकर्ताओं से मिला इनाम
यह आदत आती कहाँ से है? चैटबॉट को जवाबों के जोड़ों पर फ़ाइन-ट्यून किया जाता है, जिनमें से एक को कोई मनुष्य या AI निर्णायक पसंद करता है। ऐसी पसंदों के चार सार्वजनिक डेटासेट में से तीन में “rather than” वाले जवाबों के चुने जाने की संभावना ज़्यादा थी, सबसे स्पष्ट रूप से तब जब निर्णायक मनुष्य थे। चार खुले “रिवॉर्ड मॉडलों” ने किसी वाक्य को उसके “rather than” उपवाक्य के साथ, उसके बिना की तुलना में, ऊँचे अंक दिए, तब भी जब उसकी जगह उतनी ही लंबाई का एक तटस्थ उपवाक्य रखा गया। और किसी मॉडल से “ईमानदार” होने को कहने पर उसने यह वाक्यांश थोड़ा ज़्यादा इस्तेमाल किया।
लेखक अनुमान लगाते हैं कि यह वाक्य-रचना इस तरह के प्रशिक्षण का एक दुष्प्रभाव है: किसी एक चैटबॉट जवाब में सावधानी भरा अस्वीकरण ईमानदार लगता है; पूरे शोधपत्र में, और पूरे साहित्य में, बार-बार दोहराए जाने पर वह पैरवी जैसा पढ़ा जाता है। वाक्यांश पर प्रतिबंध लगाना शायद उसी काम को कहीं और खिसका देगा, जैसा GPT-6-sol संशोधन के दौरान “rather than” की जगह “X, not Y” रखकर करता है।
यह शैली फैल रही है
अध्ययन की स्पष्ट सीमाएँ हैं: दो व्याख्याकार जो लेखक भी हैं, और Claude की तुलना अभी तक उनमें से केवल एक ने चिह्नित की है; पैटर्न-मिलान जो कुछ इस्तेमाल चूक सकता है; और पसंद के आँकड़े जो केवल सहसंबंध दिखाते हैं। लेकिन इसका निष्कर्ष एक वाक्यांश से आगे जाता है। मनुष्यों के नाम से छपे शोधपत्रों ने यह वाक्य-रचना अपना ली है, इसलिए वैज्ञानिक साहित्य की शैली मॉडलों की शैली की ओर खिसक रही है — जो बदले में उसी से सीखेंगे।
हितों का टकराव। लेखक बताते हैं कि उन्होंने अपना कोड लिखने, विश्लेषण चलाने और पूरे शोधपत्र में, विधि और परिणाम खंडों समेत, पाठ का मसौदा तैयार करने के लिए Claude Code (Claude Sonnet 5, Sonnet 5.5 और Opus 5.5) का इस्तेमाल किया, फिर उसे हाथ से संपादित किया — और अन्य चीज़ों के साथ, जनरेशन के दौरान आए दस “rather than” हटाए। Claude मॉडल अध्ययन किए गए तंत्रों में भी शामिल हैं और उन्होंने स्वचालित मूल्यांकनकर्ताओं का काम भी किया। यह लेख भी Claude ने ही लिखा है।