مصنوعی ذہانت کے دور کے مقالے "rather than" سات گنا زیادہ لکھتے ہیں
بڑے لسانی ماڈل اب سائنسی مقالوں کے ایک بڑے حصے کو لکھنے میں مدد دیتے ہیں، اور اپنے نشان چھوڑ جاتے ہیں: پسندیدہ الفاظ، ایک خاص لہجہ۔ ایک عادت نے نیچرل لینگویج پروسیسنگ (NLP) کے محققین کو چڑانا شروع کر دیا ہے: “X rather than Y” (“X، نہ کہ Y”) پر بنے جملے، جو کسی دعوے کی تعریف جزوی طور پر اس سے کرتے ہیں جو وہ نہیں ہے۔ مقالے کے مطابق NLP کانفرنسوں میں جمع کرائے گئے مقالوں کے حالیہ دور کے مبصرین نے اس کی شکایت کی، اور کانفرنسوں کے منتظمین اب “مصنوعی ذہانت کے گھسے پٹے انداز سے بھری” تحریر پر بحث کرتے ہیں۔
اسپین کی یونیورسٹی آف اے کورونیا کی اولگا زماراییوا (Olga Zamaraeva)، آدریان گودے (Adrián Gude)، روئی سانتوس ریوس (Roi Santos-Ríos) اور کارلوس گومیز رودریگیز (Carlos Gómez-Rodríguez) نے اسے ناپنے کا بیڑا اٹھایا — ایک ایسے عنوان کے ساتھ جو خود ہی بات کہہ دیتا ہے۔
سات گنا زیادہ
انہوں نے ایسوسی ایشن فار کمپیوٹیشنل لنگوئسٹکس کے 2019 کے اجلاسوں کے 4,744 مقالوں، جب مصنوعی ذہانت کے تحریری معاون عام نہیں تھے، کا موازنہ 2026 میں اسی کانفرنس فارمیٹ میں arXiv پر شائع ہونے والے NLP کے 1,821 مقالوں سے کیا۔
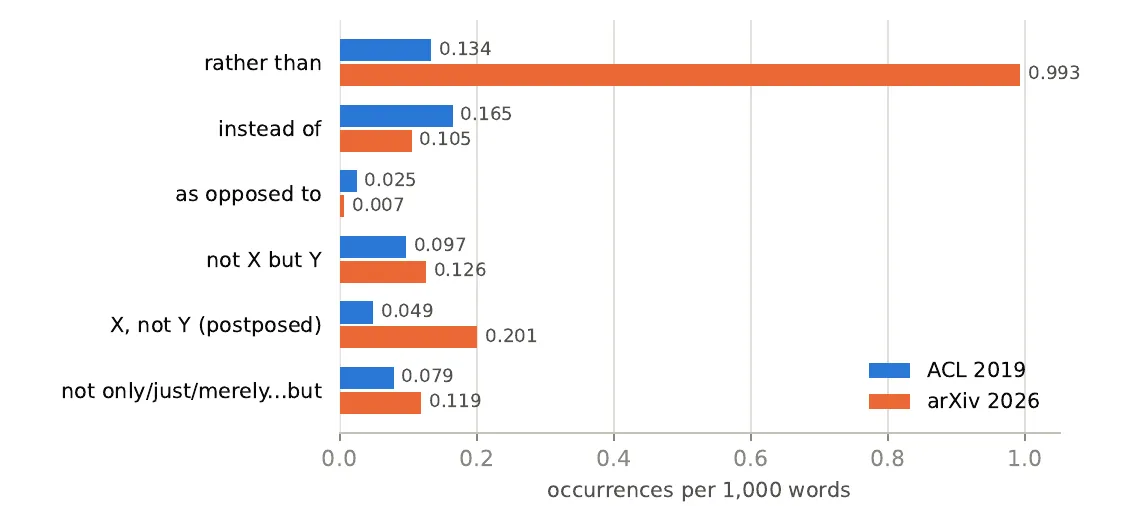
2019 (نیلا) اور 2026 (نارنجی) کے مقالوں میں فی 1,000 الفاظ وقوعات: “rather than” اور “X, not Y” تیزی سے بڑھتے ہیں، جبکہ “instead of” اور “as opposed to” گھٹتے ہیں۔ — شکل 1، Zamaraeva et al. (2026)، arXiv:2610.10092۔
- “rather than” فی 1,000 الفاظ 0.134 سے بڑھ کر 0.993 استعمالات تک پہنچ گیا، یعنی تقریباً سات گنا۔
- اس سے ملتا جلتا “X, not Y” (“X، Y نہیں”) چار گنا ہو گیا؛ اس دوران “instead of” اور “as opposed to” کم عام ہو گئے۔
- 2026 کے 94% مقالوں میں “rather than” موجود ہے، جبکہ 2019 میں یہ شرح 36% تھی، اور یہ اوسطاً اسے تقریباً آٹھ بار استعمال کرتے ہیں۔ 2026 کا ایک مقالہ اسے 69 بار استعمال کرتا ہے، یعنی تقریباً ہر 170 الفاظ میں ایک بار؛ 2019 کا کوئی مقالہ 12 سے آگے نہیں جاتا۔
ٹیم نے ماڈلز سے حقیقی مقالوں کے عنوان اور خلاصے کی بنیاد پر مکمل مقالے بھی لکھوائے۔ GPT-5.6-sol اور GPT-6-sol نے یہ فقرہ ہر مقالے میں استعمال کیا، 2026 کے مصنفین سے بھی زیادہ کثرت سے۔ Anthropic کے Claude Haiku 4.5، Sonnet 5.5 اور Opus 5.5 نے بھی اسے تقریباً ہر مقالے میں استعمال کیا، کچھ کم شرح کے ساتھ۔ ایک کھلے ماڈل، Tülu 3 8B، نے اپنی تربیت کے کسی بھی مرحلے میں اسے شاذ ہی استعمال کیا۔ مقالوں پر نظرِ ثانی سے یہ عادت ختم نہیں ہوئی: 2026 کے انہی مقالوں کے بعد والے arXiv نسخوں میں یہ کچھ زیادہ ہی ہے۔
کھٹکنے والا، مگر کون سا؟
صرف تعداد کچھ ثابت نہیں کرتی: اس فقرے کے بہت سے جائز استعمال ہیں۔ چنانچہ مصنفین میں سے دو، جو تجربہ کار مبصر ہیں، نے بغیر شناخت کے دکھائے گئے 1,000 استعمالات کو “کھٹکنے والا” یا “جائز” کا لیبل دیا۔
- 2019 کا تقریباً کوئی استعمال انہیں نہیں کھٹکا (ایک کے لیے 1.6%، دوسرے کے لیے 0%)۔
- 2026 کا تقریباً ہر دسواں استعمال کھٹکا (11.5% اور 8.3%)۔
- کون سے استعمال کھٹکنے والے ہیں، اس پر وہ کم ہی متفق ہوئے۔ لیکن چونکہ 2026 کے ایک مقالے میں یہ اتنی کثرت سے ہوتا ہے، مصنفین کا اندازہ ہے کہ 2026 کے تقریباً آدھے مقالوں میں کم از کم ایک ایسا استعمال ہے جو ان دونوں میں سے ہر ایک کو کھٹکتا ہے، اور تقریباً دو تہائی میں ایک ایسا جو کم از کم ایک کو کھٹکتا ہے — جبکہ 2019 میں یہ شرح تقریباً 1% تھی۔
کھٹکنے والے استعمالات کو جو چیز ممتاز کرتی ہے وہ بنیادی طور پر یہ ہے کہ وہ رد کیے گئے متبادل کے ساتھ کیسا سلوک کرتے ہیں۔ وہ ایک متبادل کی تعریف کرنے اور دوسرے کو حقیر دکھانے کا رجحان رکھتے ہیں، اور دوسرے لوگوں نے زیادہ کثرت سے رد کیے گئے متبادل کو ایک فرضی پُتلا (اسٹرا مین) سمجھا، یعنی ایسا مؤقف جس کا کوئی قابل محقق دفاع نہیں کرے گا۔ قارئین نے خود اس فقرے کو بھی مصنوعی ذہانت کی تحریر کی علامت سمجھا، حالانکہ وہ GPT کے لکھے حصوں کو 2019 میں انسانوں کے لکھے حصوں سے الگ نہیں پہچان سکے۔
Claude کے نتائج، جن پر اب تک صرف ایک تشریح کار نے لیبل لگائے ہیں، ملے جلے ہیں۔ Claude کے پہلے مسودے 2019 کے مقالوں سے زیادہ نہیں کھٹکے اور GPT-6-sol کے مسودوں سے کم کھٹکے۔ لیکن اس کے نظرِ ثانی شدہ نسخے GPT-6-sol جتنی ہی کثرت سے کھٹکے، یعنی اس کے اپنے پہلے مسودوں سے تقریباً دوگنا۔ یہ فرق “دستبرداریوں” (disavowals) سے آیا، جن میں مصنفین اپنے کام کے بارے میں کسی مضبوط تر دعوے سے انکار کرتے ہیں (“ایک مفروضہ rather than ایک آزمودہ میکانزم”)، جو ماڈلز کے اپنے مقالوں پر نظرِ ثانی کرنے پر زیادہ عام ہو گئیں۔
درجہ بندی کرنے والوں کی طرف سے انعام
یہ عادت آتی کہاں سے ہے؟ چیٹ بوٹس کو جوابات کے جوڑوں پر مزید تربیت دی جاتی ہے، جن میں سے ایک کو کوئی انسان یا مصنوعی ذہانت کا منصف ترجیح دیتا ہے۔ ایسی ترجیحات کے چار عوامی ڈیٹا سیٹس میں سے تین میں “rather than” والے جوابات کے منتخب ہونے کا امکان زیادہ تھا، سب سے واضح طور پر جب منصف انسان تھے۔ چار کھلے “ریوارڈ ماڈلز” نے کسی جملے کو اس کی “rather than” والی شق کے ساتھ اس کے بغیر سے زیادہ نمبر دیے، یہاں تک کہ جب اسی لمبائی کی ایک غیر جانبدار شق نے اس کی جگہ لی۔ اور کسی ماڈل کو “دیانت دار” ہونے کا کہنے سے وہ یہ فقرہ کچھ زیادہ استعمال کرنے لگا۔
مصنفین کا قیاس ہے کہ یہ ساخت اسی قسم کی تربیت کا ضمنی اثر ہے: چیٹ بوٹ کے کسی ایک جواب میں محتاط دستبرداری دیانت دار لگتی ہے؛ پورے مقالے اور پورے علمی ادب میں دہرائی جائے تو وکالت جیسی لگتی ہے۔ اس فقرے پر پابندی شاید محض اسی کام کو کہیں اور منتقل کر دے گی، جیسا کہ GPT-6-sol نظرِ ثانی کے دوران “rather than” کو “X, not Y” سے بدل کر کرتا ہے۔
انداز پھیل رہا ہے
مطالعے کی واضح حدود ہیں: دو تشریح کار جو خود مصنفین بھی ہیں، اور Claude کا موازنہ اب تک ان میں سے صرف ایک نے لیبل کیا ہے؛ نمونوں کی ایسی تلاش جو کچھ استعمالات چھوڑ سکتی ہے؛ اور ترجیحی ڈیٹا جو صرف باہمی تعلق دکھاتا ہے۔ لیکن اس کا نتیجہ ایک فقرے سے آگے جاتا ہے۔ انسانوں کے دستخط والے مقالوں نے یہ ساخت اپنا لی ہے، چنانچہ سائنسی ادب کا انداز ماڈلز کے انداز کی طرف کھسک رہا ہے — جو بدلے میں اسی سے سیکھیں گے۔
مفادات کا ٹکراؤ۔ مصنفین بتاتے ہیں کہ انہوں نے اپنا کوڈ لکھنے، تجزیے چلانے اور پورے مقالے میں، بشمول طریقۂ کار اور نتائج کے حصوں کے، متن کا مسودہ تیار کرنے کے لیے Claude Code (Claude Sonnet 5، Sonnet 5.5 اور Opus 5.5) استعمال کیا، پھر ہاتھ سے اس کی تدوین کی — اور دیگر چیزوں کے علاوہ تیاری کے دوران شامل ہونے والے دس “rather than” نکالے۔ Claude ماڈلز زیرِ مطالعہ نظاموں میں بھی شامل ہیں اور خودکار درجہ بندی کرنے والوں کے طور پر بھی استعمال ہوئے۔ یہ مضمون بھی Claude نے لکھا ہے۔