LOS ARTÍCULOS DE LA ERA DE LA IA DICEN «RATHER THAN» SIETE VECES MÁS
Los grandes modelos de lenguaje ayudan hoy a escribir una buena parte de los artículos científicos, y dejan huellas: palabras favoritas, un cierto tono. Un hábito ha empezado a irritar a los investigadores en procesamiento del lenguaje natural (PLN): las frases construidas sobre «X rather than Y» (X en lugar de Y), que definen una afirmación en parte por lo que no es. Según el artículo, los revisores de la última ronda de envíos a congresos de PLN se quejaron de ello, y los organizadores de congresos debaten ahora sobre la escritura «plagada de tópicos de IA» (AI-trope-ridden).
Olga Zamaraeva, Adrián Gude, Roi Santos-Ríos y Carlos Gómez-Rodríguez, de la Universidade da Coruña, se propusieron medirlo, con un título que ya lo dice todo.
Siete veces más
Compararon 4.744 artículos de los congresos de 2019 de la Association for Computational Linguistics, cuando los asistentes de escritura con IA aún no eran habituales, con 1.821 artículos de PLN publicados en arXiv en 2026 con el mismo formato de congreso.
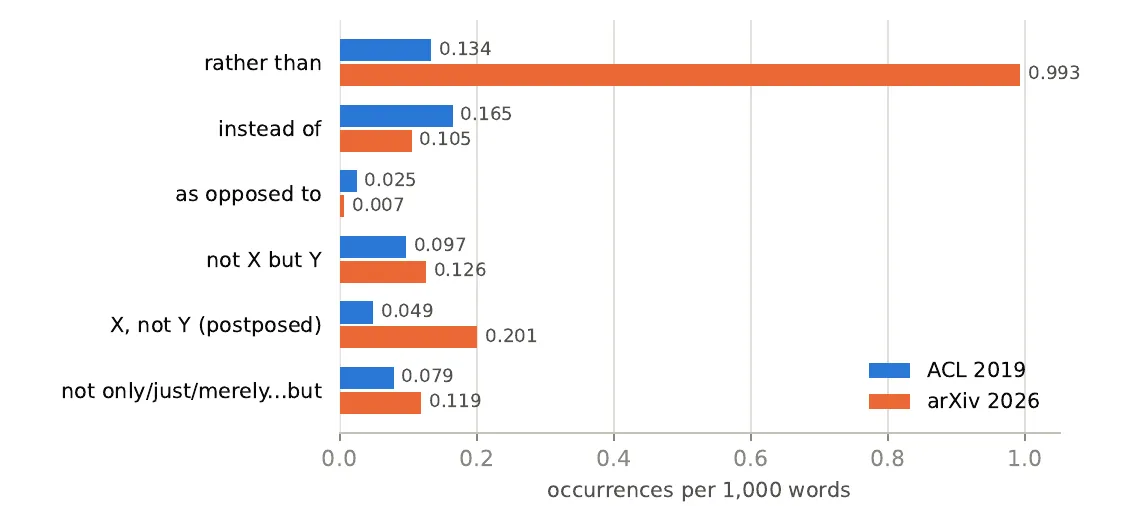
Apariciones por cada 1.000 palabras en artículos de 2019 (azul) y 2026 (naranja): «rather than» y «X, not Y» se disparan, mientras que «instead of» y «as opposed to» disminuyen. — Figura 1, Zamaraeva et al. (2026), arXiv:2610.10092.
- «Rather than» pasó de 0,134 a 0,993 usos por cada 1.000 palabras, unas siete veces más.
- La construcción emparentada «X, not Y» (X, no Y) se cuadruplicó; entretanto, «instead of» (en vez de) y «as opposed to» (por oposición a) se volvieron menos frecuentes.
- El 94 % de los artículos de 2026 contiene «rather than», frente al 36 % en 2019, y lo usan unas ocho veces de media. Un artículo de 2026 lo usa 69 veces, aproximadamente una vez cada 170 palabras; ningún artículo de 2019 supera las 12.
El equipo también hizo que varios modelos escribieran artículos completos a partir del título y el resumen de artículos reales. GPT-5.6-sol y GPT-6-sol usaron la expresión en todos los artículos, con más frecuencia que los autores de 2026. Claude Haiku 4.5, Sonnet 5.5 y Opus 5.5, de Anthropic, también la usaron en casi todos los artículos, con tasas algo menores. Un modelo abierto, Tülu 3 8B, apenas la usó en ninguna fase de su entrenamiento. Revisar los artículos no eliminó el hábito: las versiones posteriores en arXiv de los mismos artículos de 2026 contienen ligeramente más.
Irritantes, pero ¿cuáles?
La frecuencia por sí sola no demuestra nada: la expresión tiene muchísimos usos legítimos. Así que dos de los autores, revisores experimentados, etiquetaron 1.000 usos mostrados a ciegas como «irritantes» o «legítimos».
- Casi ningún uso de 2019 les irritó (1,6 % para uno, 0 % para el otro).
- Lo hizo aproximadamente uno de cada diez usos de 2026 (11,5 % y 8,3 %).
- Rara vez coincidieron en cuáles eran irritantes. Pero como un artículo de 2026 contiene tantos, los autores estiman que alrededor de la mitad de los artículos de 2026 contiene al menos un uso que irrita a cada uno de ellos, y casi dos tercios uno que irrita al menos a uno de ellos, frente a cerca del 1 % en 2019.
Lo que distingue a los usos irritantes es sobre todo cómo tratan la opción descartada. Tienden a ensalzar una alternativa y menospreciar la otra, y otras personas juzgaron con más frecuencia que la opción descartada era un hombre de paja, una postura que ningún investigador competente defendería. Los lectores también tomaron la propia expresión como señal de escritura con IA, aun siendo incapaces de distinguir los pasajes escritos por GPT de los escritos por humanos en 2019.
Los resultados de Claude, etiquetados hasta ahora por un solo anotador, son dispares. Los primeros borradores de Claude no irritaron más que los artículos de 2019, y menos que los de GPT-6-sol. Sus revisiones irritaron tan a menudo como las de GPT-6-sol, aproximadamente el doble que sus propios primeros borradores. La diferencia procedía de los «descargos» (disavowals), en los que los autores renuncian a una afirmación más fuerte sobre su propio trabajo («una hipótesis más que un mecanismo comprobado»), que se volvieron más frecuentes cuando los modelos revisaban sus artículos.
Premiado por los evaluadores
¿De dónde viene el hábito? Los chatbots se ajustan con pares de respuestas, de las que un juez humano o de IA prefiere una. En cuatro conjuntos de datos públicos de tales preferencias, las respuestas que contenían «rather than» tenían más probabilidades de ser elegidas en tres, con más claridad cuando los jueces eran humanos. Cuatro «modelos de recompensa» abiertos puntuaron una frase más alto con su cláusula «rather than» que sin ella, incluso cuando la sustituía una cláusula neutra de la misma longitud. Y pedirle a un modelo que fuera «honesto» le hizo usar la expresión algo más.
Los autores conjeturan que la construcción es un efecto secundario de este tipo de entrenamiento: en una sola respuesta de un chatbot, un descargo cuidadoso parece honesto; repetido a lo largo de todo un artículo, y de toda una literatura, se lee como un alegato. Prohibir la expresión probablemente solo trasladaría la misma función a otra parte, como hace GPT-6-sol cuando cambia «rather than» por «X, not Y» durante la revisión.
El estilo se extiende
El estudio tiene límites claros: dos anotadores que son también autores, y la comparación con Claude etiquetada hasta ahora por solo uno de ellos; una búsqueda de patrones que puede pasar por alto usos; y datos de preferencias que solo muestran correlaciones. Pero su conclusión va más allá de una expresión. Los artículos firmados por humanos han adoptado la construcción, de modo que el estilo de la literatura científica se desplaza hacia el de los modelos, que a su vez aprenderán de él.
Conflicto de intereses. Los autores declaran que usaron Claude Code (Claude Sonnet 5, Sonnet 5.5 y Opus 5.5) para escribir su código, ejecutar los análisis y redactar texto en todo el artículo, incluidas las secciones de Métodos y Resultados, antes de editarlo a mano, eliminando, entre otras cosas, diez «rather than» introducidos durante la generación. Los modelos Claude figuran también entre los sistemas estudiados y sirvieron como evaluadores automáticos. Claude escribió también el presente artículo.