CONTAR LOS RÉCORDS NO DICE NADA SOBRE EL MAYOR DE TODOS
Imagina una serie de mediciones diarias de lluvia. Dos números resumen sus extremos. El primero es el máximo: el día más lluvioso. El segundo es el número de récords: cuántas veces un día superó a todos los anteriores. El máximo es simplemente el último récord.
Sin embargo, ninguno de los dos números dice cómo se alcanzó el pico. ¿Fue una larga escalera de récords, cada uno un poco más alto que el anterior? ¿O un único aguacero excepcional tras una larga calma? La intuición dice que ambos deberían ir juntos: un máximo muy alto debería requerir muchos récords por el camino. Satya Majumdar (Universidad Paris-Saclay y CNRS), Sanjib Sabhapandit (Raman Research Institute, India) y Grégory Schehr (Sorbonne Université y CNRS) se propusieron calcular este vínculo con exactitud. Máximos y récords se han estudiado cada uno por separado durante décadas, señalan, pero su comportamiento conjunto ha recibido «notablemente poca atención».
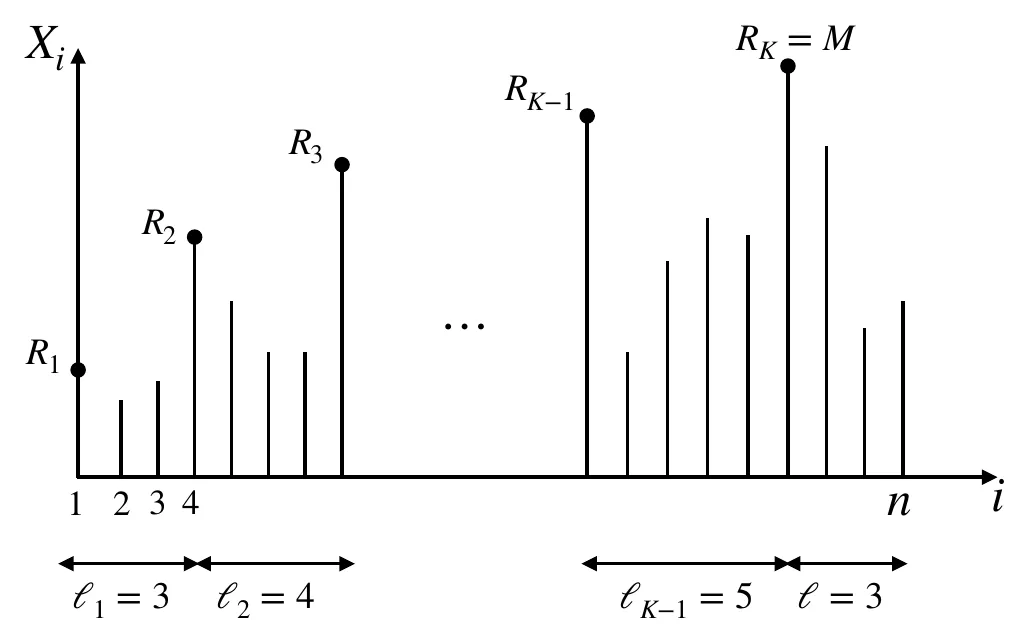
Una serie aleatoria de n valores con K récords (R₁ … R_K); el último récord es el máximo M. Los intervalos ℓ entre récords son las «edades» de los récords. — Figura 1, Majumdar, Sabhapandit y Schehr (2026), arXiv:2610.23217, CC BY 4.0.
Exactamente ningún vínculo
Empecemos por el caso más sencillo: cada valor se extrae de forma independiente de la misma distribución continua, sin huecos ni picos. Aquí los récords ya tienen una propiedad famosa: en promedio, una serie de n valores contiene 1 + 1/2 + 1/3 + … + 1/n récords, sea cual sea la distribución. Ese número crece solo como el logaritmo de n: los récords son cada vez más difíciles de batir.
El primer resultado del equipo es, en sus palabras, «bastante llamativo e inesperado». Para cualquier serie de este tipo, de cualquier longitud, el número de récords K y el máximo M son completamente independientes. Su probabilidad conjunta se descompone en el producto de las dos probabilidades por separado. Saber cuántos récords se batieron no dice nada sobre lo alto que es el mayor, y viceversa.
Los días secos lo cambian todo
La lluvia real no es continua: algunos días no llueve en absoluto. Los autores lo modelizan con una probabilidad q de día seco (lluvia cero) y una distribución continua para la cantidad de los días húmedos. Los récords se cuentan solo entre los días húmedos.
Ahora aparece un vínculo. Para un número fijo de días húmedos, las dos magnitudes siguen siendo independientes. Es el número aleatorio de días húmedos el que las une. Durante una larga racha seca, ni el recuento de récords ni el máximo pueden cambiar: quedan congelados juntos, y esa congelación compartida los correlaciona. En series muy largas, el vínculo vuelve a desvanecerse.
Los dos efectos compiten, y el resultado se invierte en un umbral preciso. Por debajo de una proporción crítica de días secos q_c, el vínculo (medido por la covarianza) solo disminuye a medida que la serie se alarga. Por encima de q_c, primero crece, alcanza un máximo y luego disminuye. Los autores dan el umbral exacto:
q_c = ½(−b + √(b² + 8)), con b = 1 + 2µ₁/µ₂
donde µ₁ y µ₂ son dos promedios sencillos calculados a partir de la distribución de la lluvia de los días húmedos. Para una lluvia con distribución exponencial, q_c = (√33 − 5)/2 ≈ 0,372. Para una lluvia con distribución uniforme, √6 − 2 ≈ 0,449. La nitidez de este cambio, escriben, es «sorprendente y nada trivial». En series largas, el vínculo decae como una potencia de la longitud de la serie, con un exponente fijado por lo pesada que es la cola de la distribución de la lluvia, no por q.
Contrastado con la lluvia alemana
Para poner a prueba la predicción, el equipo recurrió a los datos diarios del servicio meteorológico alemán, el Deutscher Wetterdienst: 6105 estaciones. Para eliminar la memoria del tiempo de un día a otro, conservaron solo un día de cada trece. Después formaron dos grupos:
- Grupo A: 232 estaciones con registros completos de 1974 a 2013 y aproximadamente la mitad de los días secos (q ≈ 0,50). El umbral previsto para su lluvia era 0,315, así que el vínculo debía subir y luego bajar.
- Grupo B: los registros de noviembre de 15 estaciones con pocos días secos (q ≈ 0,23), por debajo de su umbral previsto de 0,28. El vínculo solo debía bajar.
La teoría usó únicamente la proporción medida de días secos y la distribución medida de la lluvia, sin ningún parámetro ajustable. Ambos grupos siguieron la forma prevista.
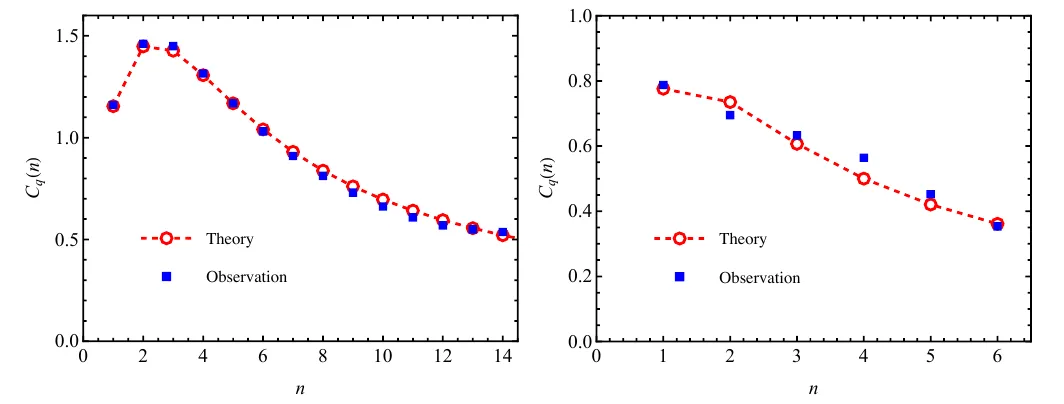
Datos de lluvia alemanes (cuadrados azules) frente a la teoría exacta (rojo). Izquierda: estaciones con alrededor de un 50 % de días secos, por encima del umbral; el vínculo sube y luego baja. Derecha: datos de noviembre con un 23 % de días secos, por debajo del umbral; solo baja. — Figura 3, Majumdar, Sabhapandit y Schehr (2026), arXiv:2610.23217, CC BY 4.0.
La lluvia real también arrastra memoria de un día al siguiente. El trabajo preliminar de los autores sobre series con esa memoria sugiere que entonces el vínculo siempre sube antes de bajar, sea cual sea la intensidad de la memoria: el próximo cálculo que les gustaría hacer exacto, días secos incluidos.