DIE ZAHL DER REKORDE VERRÄT NICHTS ÜBER DEN GRÖSSTEN
Stellen Sie sich eine Reihe täglicher Niederschlagsmessungen vor. Zwei Zahlen fassen ihre Extreme zusammen. Die erste ist das Maximum: der nasseste Tag. Die zweite ist die Zahl der Rekorde: wie oft ein Tag alle vorherigen übertraf. Das Maximum ist einfach der letzte Rekord.
Doch keine der beiden Zahlen sagt, wie die Spitze erreicht wurde. War es eine lange Treppe von Rekorden, jeder ein wenig höher als der vorige? Oder ein einziger außergewöhnlicher Wolkenbruch nach langer Ruhe? Die Intuition sagt, beides sollte zusammengehen: Ein sehr hohes Maximum müsste unterwegs viele Rekorde brauchen. Satya Majumdar (Universität Paris-Saclay und CNRS), Sanjib Sabhapandit (Raman Research Institute, Indien) und Grégory Schehr (Sorbonne-Universität und CNRS) machten sich daran, diesen Zusammenhang exakt zu berechnen. Maxima und Rekorde seien jeweils seit Jahrzehnten untersucht worden, merken sie an, ihr gemeinsames Verhalten habe aber „bemerkenswert wenig Aufmerksamkeit“ erhalten.
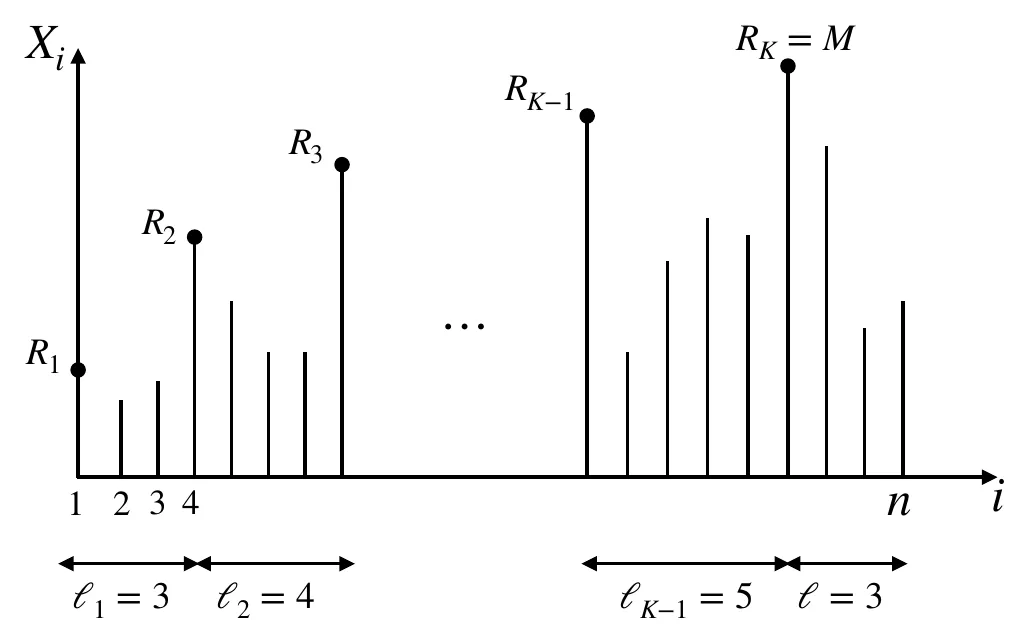
Eine Zufallsreihe aus n Werten mit K Rekorden (R₁ … R_K); der letzte Rekord ist das Maximum M. Die Abstände ℓ zwischen den Rekorden sind die „Alter“ der Rekorde. — Abbildung 1, Majumdar, Sabhapandit & Schehr (2026), arXiv:2610.23217, CC BY 4.0.
Exakt kein Zusammenhang
Man beginne mit dem einfachsten Fall: Jeder Wert wird unabhängig aus derselben glatten Verteilung gezogen, ohne Lücken oder Spitzen. Hier haben Rekorde bereits eine berühmte Eigenschaft: Im Mittel enthält eine Reihe aus n Werten 1 + 1/2 + 1/3 + … + 1/n Rekorde, unabhängig von der Verteilung. Diese Zahl wächst nur wie der Logarithmus von n – Rekorde werden immer schwerer zu brechen.
Das erste Ergebnis des Teams ist, in ihren Worten, „ziemlich verblüffend und unerwartet“. Für jede solche Reihe, gleich welcher Länge, sind die Zahl der Rekorde K und das Maximum M völlig unabhängig. Ihre gemeinsame Wahrscheinlichkeit zerfällt in das Produkt der beiden einzelnen. Zu wissen, wie viele Rekorde gebrochen wurden, verrät nichts darüber, wie hoch der oberste ist, und umgekehrt.
Trockene Tage ändern alles
Echter Niederschlag ist nicht glatt: An manchen Tagen regnet es überhaupt nicht. Die Autoren modellieren das mit einer Wahrscheinlichkeit q für einen trockenen Tag (null Regen) und einer glatten Verteilung für die Menge an nassen Tagen. Rekorde werden nur unter den nassen Tagen gezählt.
Jetzt entsteht ein Zusammenhang. Bei fester Zahl nasser Tage bleiben die beiden Größen unabhängig. Es ist die zufällige Zahl nasser Tage, die sie verbindet. Während einer langen Trockenperiode können sich weder die Zahl der Rekorde noch das Maximum ändern: Sie sind gemeinsam eingefroren, und dieses gemeinsame Einfrieren korreliert sie. Über sehr lange Reihen verblasst der Zusammenhang wieder.
Die beiden Effekte konkurrieren, und das Ergebnis kippt an einer präzisen Schwelle. Unterhalb eines kritischen Anteils trockener Tage q_c schrumpft der Zusammenhang (gemessen durch die Kovarianz) nur, je länger die Reihe wird. Oberhalb von q_c wächst er erst, erreicht einen Höchstwert und schrumpft dann. Die Autoren geben die Schwelle exakt an:
q_c = ½(−b + √(b² + 8)), mit b = 1 + 2µ₁/µ₂
wobei µ₁ und µ₂ zwei einfache Mittelwerte sind, die aus der Niederschlagsverteilung der nassen Tage berechnet werden. Für exponentialverteilten Regen ist q_c = (√33 − 5)/2 ≈ 0,372. Für gleichverteilten Regen √6 − 2 ≈ 0,449. Die Schärfe dieses Umschlags, schreiben sie, sei „überraschend und alles andere als trivial“. Über lange Reihen zerfällt der Zusammenhang wie eine Potenz der Reihenlänge, mit einem Exponenten, der davon abhängt, wie schwer der Ausläufer der Regenverteilung ist, nicht von q.
Am deutschen Regen geprüft
Um die Vorhersage zu prüfen, griff das Team auf Tagesdaten des Deutschen Wetterdienstes zurück: 6.105 Stationen. Um das Gedächtnis des Wetters von einem Tag zum nächsten zu beseitigen, behielten sie nur einen von dreizehn Tagen. Dann bildeten sie zwei Gruppen:
- Gruppe A: 232 Stationen mit lückenlosen Aufzeichnungen von 1974 bis 2013 und etwa der Hälfte trockener Tage (q ≈ 0,50). Die vorhergesagte Schwelle für ihren Regen lag bei 0,315, der Zusammenhang sollte also erst steigen, dann fallen.
- Gruppe B: die November-Aufzeichnungen von 15 Stationen mit wenigen trockenen Tagen (q ≈ 0,23), unter ihrer vorhergesagten Schwelle von 0,28. Der Zusammenhang sollte nur fallen.
Die Theorie nutzte nur den gemessenen Anteil trockener Tage und die gemessene Niederschlagsverteilung, ohne einstellbaren Parameter. Beide Gruppen folgten dem vorhergesagten Verlauf.
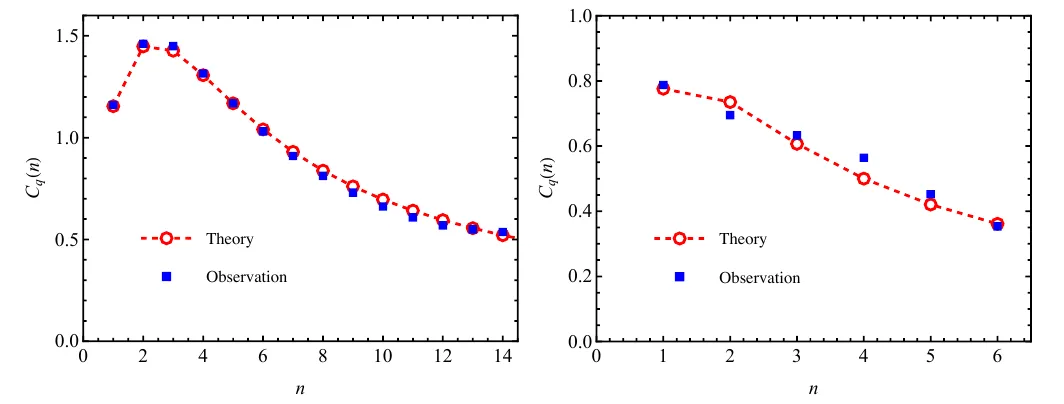
Deutsche Niederschlagsdaten (blaue Quadrate) im Vergleich zur exakten Theorie (rot). Links: Stationen mit etwa 50 % trockenen Tagen, über der Schwelle – der Zusammenhang steigt, dann fällt er. Rechts: November-Daten mit 23 % trockenen Tagen, unter der Schwelle – er fällt nur. — Abbildung 3, Majumdar, Sabhapandit & Schehr (2026), arXiv:2610.23217, CC BY 4.0.
Echter Niederschlag hat zudem ein Gedächtnis von einem Tag zum nächsten. Vorläufige Arbeiten der Autoren zu Reihen mit einem solchen Gedächtnis deuten darauf hin, dass der Zusammenhang dann immer erst steigt, bevor er fällt, unabhängig von der Stärke des Gedächtnisses – die nächste Rechnung, die sie gern exakt machen würden, trockene Tage eingeschlossen.