COMPTER LES RECORDS NE DIT RIEN DU PLUS GRAND
Prenez une série de mesures quotidiennes de pluie. Deux nombres en résument les extrêmes. Le premier est le maximum : le jour le plus arrosé. Le second est le nombre de records : combien de fois un jour a battu tous les jours précédents. Le maximum n’est autre que le dernier record.
Pourtant, aucun de ces deux nombres ne dit comment le pic a été atteint. Par un long escalier de records, chacun un peu plus haut que le précédent ? Ou par une seule averse exceptionnelle après un long calme ? L’intuition dit que les deux vont ensemble : un maximum très élevé devrait demander beaucoup de records en chemin. Satya Majumdar (université Paris-Saclay et CNRS), Sanjib Sabhapandit (Raman Research Institute, Inde) et Grégory Schehr (Sorbonne Université et CNRS) ont entrepris de calculer ce lien exactement. Maxima et records sont étudiés séparément depuis des décennies, notent-ils, mais leur comportement conjoint a reçu « remarquablement peu d’attention ».
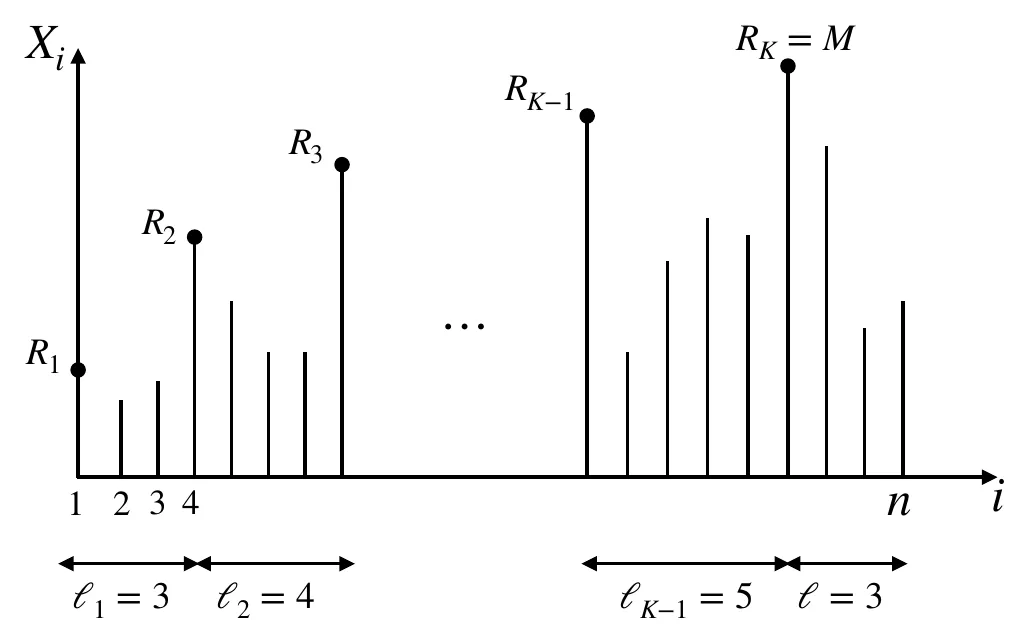
Une série aléatoire de n valeurs avec K records (R₁ … R_K) ; le dernier record est le maximum M. Les écarts ℓ entre records sont les « âges » des records. — Figure 1, Majumdar, Sabhapandit et Schehr (2026), arXiv:2610.23217, CC BY 4.0.
Exactement aucun lien
Commençons par le cas le plus simple : chaque valeur tirée indépendamment selon la même loi continue, sans trou ni pic. Les records y ont déjà une propriété célèbre : en moyenne, une série de n valeurs contient 1 + 1/2 + 1/3 + … + 1/n records, quelle que soit la loi. Ce nombre ne croît que comme le logarithme de n — les records deviennent de plus en plus difficiles à battre.
Le premier résultat de l’équipe est, selon ses propres mots, « plutôt frappant et inattendu ». Pour toute série de ce type, de n’importe quelle longueur, le nombre de records K et le maximum M sont complètement indépendants. Leur probabilité conjointe se sépare en produit des deux probabilités individuelles. Savoir combien de records ont été battus n’apprend rien sur la hauteur du plus grand, et inversement.
Les jours secs changent tout
La vraie pluie n’est pas continue : certains jours, il ne pleut pas du tout. Les auteurs le modélisent par une probabilité q d’avoir un jour sec (zéro pluie), et une loi continue pour la quantité les jours humides. Les records ne sont comptés que parmi les jours humides.
Cette fois, un lien apparaît. Pour un nombre fixé de jours humides, les deux grandeurs restent indépendantes. C’est le nombre aléatoire de jours humides qui les attache l’une à l’autre. Pendant une longue période sèche, ni le nombre de records ni le maximum ne peuvent changer : ils sont figés ensemble, et ce gel commun les corrèle. Sur des séries très longues, le lien s’estompe de nouveau.
Les deux effets s’affrontent, et l’issue bascule à un seuil précis. En dessous d’une part critique de jours secs q_c, le lien (mesuré par la covariance) ne fait que diminuer quand la série s’allonge. Au-dessus de q_c, il commence par grandir, passe par un maximum, puis diminue. Les auteurs donnent ce seuil exactement :
q_c = ½(−b + √(b² + 8)), avec b = 1 + 2µ₁/µ₂
où µ₁ et µ₂ sont deux moyennes simples calculées à partir de la loi des pluies des jours humides. Pour une pluie de loi exponentielle, q_c = (√33 − 5)/2 ≈ 0,372. Pour une pluie de loi uniforme, √6 − 2 ≈ 0,449. La netteté de cette bascule est, écrivent-ils, « surprenante et loin d’être triviale ». Sur de longues séries, le lien décroît comme une puissance de la longueur de la série, avec un exposant fixé par la lourdeur de la queue de la loi des pluies, pas par q.
Vérifié sur la pluie allemande
Pour tester la prédiction, l’équipe s’est tournée vers les données quotidiennes du service météorologique allemand, le Deutscher Wetterdienst : 6 105 stations. Pour effacer la mémoire du temps d’un jour à l’autre, elle n’a gardé qu’un jour sur treize. Puis elle a formé deux groupes :
- Groupe A : 232 stations aux relevés complets de 1974 à 2013, avec environ la moitié de jours secs (q ≈ 0,50). Le seuil prédit pour leur pluie était de 0,315 : le lien devait monter, puis descendre.
- Groupe B : les relevés de novembre de 15 stations avec peu de jours secs (q ≈ 0,23), sous leur seuil prédit de 0,28. Le lien ne devait que descendre.
La théorie n’utilisait que la part mesurée de jours secs et la loi des pluies mesurée, sans aucun paramètre ajustable. Les deux groupes ont suivi la forme prévue.
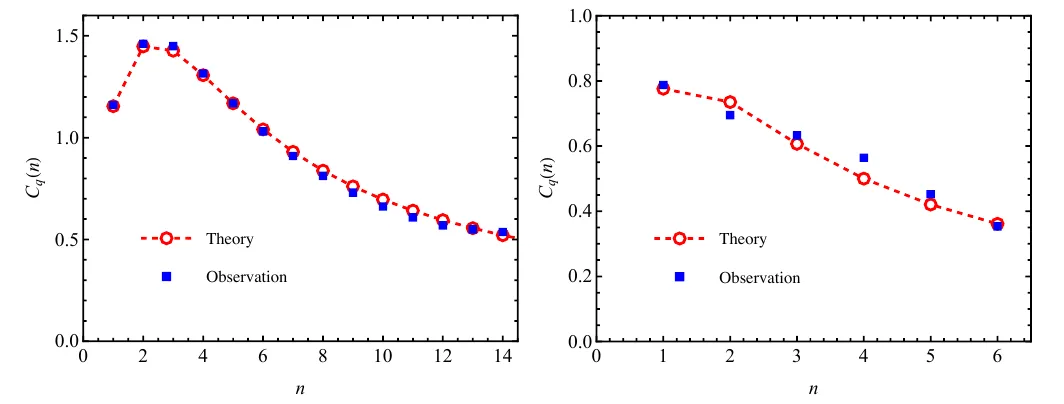
Données de pluie allemandes (carrés bleus) face à la théorie exacte (rouge). À gauche : stations avec environ 50 % de jours secs, au-dessus du seuil — le lien monte, puis descend. À droite : données de novembre avec 23 % de jours secs, sous le seuil — il ne fait que descendre. — Figure 3, Majumdar, Sabhapandit et Schehr (2026), arXiv:2610.23217, CC BY 4.0.
La vraie pluie garde aussi une mémoire d’un jour à l’autre. Les travaux préliminaires des auteurs sur des séries dotées d’une telle mémoire suggèrent que le lien monte alors toujours avant de descendre, quelle que soit la force de cette mémoire — le prochain calcul qu’ils aimeraient rendre exact, jours secs compris.