هل بدأ العلم يكرّر نفسه؟
لا يكفّ الأدب العلمي عن النمو — بنحو 4% سنويًا، أي يتضاعف كل 17 عامًا تقريبًا، وفقًا للأرقام الواردة في الورقة. وقد يعني أدبٌ أكبر جبهةً أوسع من الأفكار. وقد يعني أيضًا مزيدًا من الأوراق التي تكرّر ما كُتب من قبل. وقد شرع إيلان دورون-أراد وإلخانان موسيل، الرياضيان في معهد ماساتشوستس للتقنية، في قياس جانب واحد من هذه المسألة.
للأصالة أبعاد كثيرة ولا مقياس متفق عليه لها. لكن أحد هذه الأبعاد صار قابلًا للقياس على نطاق واسع: التميّز النصي (textual distinctiveness)، أي مقدار ما يُقرأ من الورقة كأنه عمل حديث. فالنماذج اللغوية الحديثة تستطيع تحويل مقطع إلى قائمة أرقام تلتقط معناه، بحيث ينتهي مقطعان يقولان الشيء نفسه بكلمات مختلفة متقاربين.
ويحرص المؤلفان على توضيح ما تلتقطه هذه الطريقة وما لا تلتقطه. فاكتشاف جديد حقًا قد يُكتب بجمل مألوفة؛ والعبارة غير المألوفة ليست فكرة جديدة.
تثبيت المقارنة
كانت المقارنة الساذجة ستكون مضلِّلة: فمع نمو الأدب، تزداد فرص أن يشبه أي مقطع شيئًا ما. لذلك أبقى المؤلفان مجموعة المقارنة ثابتة. فلكلٍّ من ثمانية مجالات — الفيزياء الفلكية، والمعلوماتية الحيوية، والكيمياء، وتغيّر المناخ، وتعلّم الآلة، والطب، وعلم النفس، والحوسبة الكمومية — ولكل عام من 2015 إلى 2025، أخذا 300 ورقة من قاعدة البيانات المفتوحة الوصول CORE وقارناها بـ3,000 ورقة من السنوات الخمس السابقة. وفي المجموع، نحو 26,000 نص كامل.
قُسِّمت كل ورقة إلى مقاطع متداخلة من 160 كلمة. واشترط التطابق تشابهًا عاليًا في المعنى، وستة مصطلحات محددة مشتركة على الأقل، وعدم وجود أي تسلسل متطابق من خمس كلمات — لاستبعاد النسخ الصريح — وعدم وجود مؤلف مشترك، وألّا يكون الأمر نسختين من الورقة نفسها. وعلى مجموعة اختبار بُنيت لهذا الغرض، لم يرتكب الكاشف تقريبًا أي تطابق خاطئ (دقة 99.6%)، مع إغفاله بعض التطابقات الحقيقية.
استقرار، ثم ارتفاع حاد
حتى عام 2020، كانت حصة نص الورقة المطابقة لأعمال حديثة تحوم حول 0.43%. ومن 2021 أخذت ترتفع، فبلغت 1.34% في 2025 — أي 3.1 أضعاف المستوى السابق. ويضع اختبار إحصائي بداية الارتفاع في عام 2021.
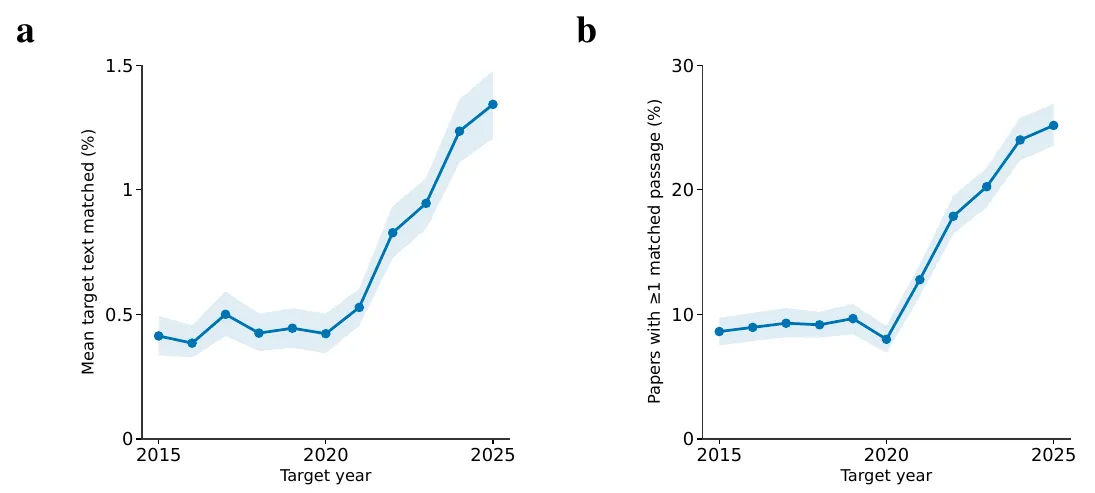
يسارًا: متوسط حصة نص كل ورقة الذي يشبه أعمالًا حديثة. يمينًا: حصة الأوراق التي تحتوي على مقطع واحد على الأقل من هذا النوع. — الشكل 1a–b، دورون-أراد وموسيل (2026)، arXiv:2609.32963.
لم يأتِ الارتفاع من قلة من المقتبسين بكثافة. فقد بلغت حصة الأوراق التي تحتوي على مقطع مردِّد للصدى واحد على الأقل 25% في 2025. وارتفعت المجالات الثمانية كلها، بمعدلات مختلفة.
أصداء بلا استشهادات
هل استشهد المؤلفون ببساطة بالأعمال التي يردّدون صداها؟ نادرًا. فلم يُعثَر على رابط استشهاد إلا لـ6.4% من أزواج الأوراق المتطابقة، وأعطى فحص يدوي لـ176 زوجًا نسبة 7%. وبين 2015 و2025، ازدادت الأزواج المتطابقة من 449 إلى 1,831 — لكن تلك التي تتضمن استشهادًا بقيت عند 59 في كلا العامين.
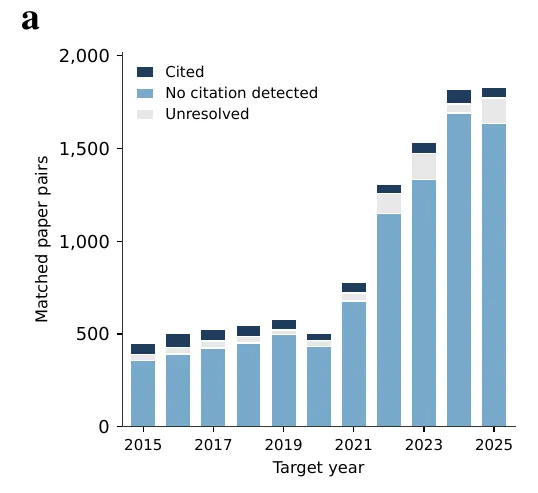
عدد أزواج الأوراق المتطابقة في كل عام، بحسب حالة الاستشهاد: يكاد كل النمو يقع في الأزواج التي لم يُكتشَف فيها استشهاد. — الشكل 3a، دورون-أراد وموسيل (2026)، arXiv:2609.32963.
وتساءل الفريق أيضًا عمّا إذا كانت الأفكار تتكرر، لا الصياغة فحسب. فلخّصت نماذج ذكاء اصطناعي من شركة Anthropic كل مقطع في كلمات قليلة، ثم حكمت، من دون رؤية النص الأصلي، على ما إذا كان ملخّصان يعبّران في جوهرهما عن الادعاء العلمي نفسه. وباستخدام تعريف صارم، ارتفعت هذه الأزواج من متوسط نحو 26 زوجًا سنويًا في 2015–2020 إلى 139 في 2025.
وصمد هذا النمط أمام فحوص عديدة — عتبات مختلفة، وأطوال مقاطع مختلفة، وحذف أقسام المنهجية وأكثر المصادر تعرّضًا للنسخ — وتكرّر في قاعدة بيانات ثانية مستقلة، هي Europe PMC، حيث تضاعفت حصة النص المردِّد للصدى.
مشتبه به، لا حكم
يتزامن الارتفاع الأكبر مع التبنّي السريع لأدوات الذكاء الاصطناعي في الكتابة العلمية، ويرى المؤلفان فيها عاملًا مساهمًا محتملًا، إذ تميل إلى نشر الصياغات الأكثر شيوعًا. لكن الدراسة لا تثبت السبب. فاللغة المشتركة داخل التخصصات وانحصار الاهتمام في الأوراق القليلة نفسها قد يؤديان دورًا أيضًا؛ ومن هذا المنظور، يكون الذكاء الاصطناعي أحدث مسرِّع لتقارب كان جاريًا أصلًا. ويشدّد المؤلفان كذلك على أن التشابه الدلالي لا يعني سوء السلوك.
ويقترحان أدوات تجعل الأصالة مرئية للمؤلفين والمراجعين والمحررين والجهات المموّلة — مع تحذير واحد: لا تجعلوا أبدًا درجة التميّز هدفًا، لأنها ستكافئ الصياغة غير المألوفة على حساب البصيرة الحقيقية، وسيسهل التلاعب بها.