НАУКА НАЧИНАЕТ ПОВТОРЯТЬСЯ?
Научная литература постоянно растёт — примерно на 4% в год, удваиваясь приблизительно каждые 17 лет, согласно приводимым в статье цифрам. Больший объём литературы мог бы означать более широкий фронт идей. А мог бы — больше статей, повторяющих уже написанное. Илан Дорон-Арад и Эльханан Моссель, математики из MIT, решили измерить одну сторону этого вопроса.
У оригинальности много измерений и нет общепринятой меры. Но одно из них теперь можно измерять в больших масштабах: текстовую самобытность — то, насколько статья читается как недавние работы. Современные языковые модели умеют превращать фрагмент текста в набор чисел, отражающий его смысл, так что два фрагмента, говорящие одно и то же разными словами, оказываются рядом.
Авторы аккуратно оговаривают, что этот подход улавливает, а что нет. Действительно новый результат можно изложить привычными фразами; необычный оборот — ещё не новая идея.
Неизменная база сравнения
Наивное сравнение вводило бы в заблуждение: чем больше литература, тем больше у любого фрагмента шансов оказаться похожим на что-нибудь. Поэтому авторы зафиксировали объём базы сравнения. Для каждой из восьми областей — астрофизики, биоинформатики, химии, изменения климата, машинного обучения, медицины, психологии и квантовых вычислений — и для каждого года с 2015 по 2025-й они брали 300 статей из открытой базы данных CORE и сравнивали их с 3000 статей за пять предыдущих лет. Всего около 26 000 полных текстов.
Каждую статью разрезали на перекрывающиеся фрагменты по 160 слов. Для совпадения требовались высокое смысловое сходство, не менее шести общих специальных терминов, отсутствие одинаковых цепочек из пяти слов — так что простое копирование исключено, — отсутствие общих авторов, и это не должны быть две версии одной статьи. На специально созданном тестовом наборе детектор почти не давал ложных совпадений (точность 99,6%), хотя часть настоящих пропускал.
Стабильность, затем резкий рост
До 2020 года доля текста статьи, совпадающего с недавними работами, держалась около 0,43%. С 2021 года она пошла вверх и в 2025-м достигла 1,34% — в 3,1 раза выше прежнего уровня. Статистический тест относит начало роста к 2021 году.
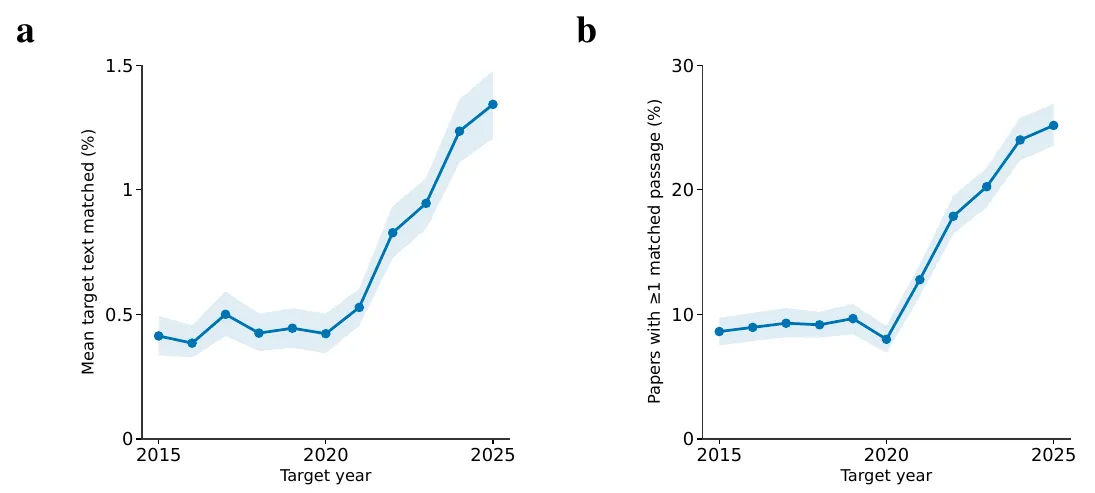
Слева: средняя доля текста каждой статьи, похожего на недавние работы. Справа: доля статей хотя бы с одним таким фрагментом. — Рисунок 1a–b, Doron-Arad & Mossel (2026), arXiv:2609.32963.
Рост обеспечили не несколько злостных заимствователей. Доля статей хотя бы с одним фрагментом-эхом достигла в 2025 году 25%. Рост наблюдался во всех восьми областях, с разной скоростью.
Эхо без ссылок
Может быть, авторы просто ссылались на работы, с которыми перекликаются? Редко. Связь через цитирование удалось найти лишь для 6,4% совпавших пар статей, а ручная проверка 176 пар дала 7%. С 2015 по 2025 год число совпавших пар выросло с 449 до 1831 — а пар со ссылкой в оба года было 59.
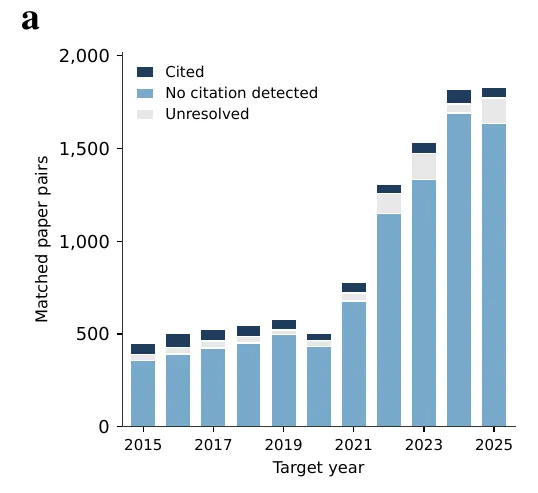
Число совпавших пар статей по годам в зависимости от наличия ссылки: почти весь рост приходится на пары без обнаруженной ссылки. — Рисунок 3a, Doron-Arad & Mossel (2026), arXiv:2609.32963.
Команда также проверила, повторяются ли идеи, а не только формулировки. ИИ-модели Anthropic кратко резюмировали каждый фрагмент в нескольких словах, а затем, не видя исходного текста, оценивали, выражают ли два резюме по сути одно и то же научное утверждение. При строгом определении число таких пар выросло в среднем примерно с 26 в год в 2015–2020 годах до 139 в 2025-м.
Картина устояла при множестве проверок — с другими порогами, длинами фрагментов, без разделов «Методы» и без самых копируемых источников — и воспроизвелась на второй, независимой базе данных Europe PMC, где доля текста-эха удвоилась.
Подозреваемый, а не приговор
Самый сильный рост совпадает с быстрым распространением ИИ-инструментов для написания научных текстов, и авторы считают их правдоподобным фактором, поскольку такие инструменты склонны тиражировать самые распространённые формулировки. Но причину исследование не устанавливает. Свою роль могут играть и общий язык дисциплин, и сужение внимания к одним и тем же немногим статьям; с этой точки зрения ИИ — лишь новейший ускоритель уже идущего сближения. Авторы также подчёркивают, что смысловое сходство не означает недобросовестности.
Они предлагают инструменты, которые делали бы оригинальность видимой для авторов, рецензентов, редакторов и грантодателей, — с одним предупреждением: ни в коем случае не превращать балл самобытности в цель, ведь он поощрял бы необычные формулировки вместо подлинного понимания и его было бы легко накрутить.