PHẢI CHĂNG KHOA HỌC ĐANG BẮT ĐẦU LẶP LẠI CHÍNH MÌNH?
Tài liệu khoa học không ngừng tăng lên — khoảng 4% mỗi năm, tăng gấp đôi khoảng 17 năm một lần, theo các số liệu được trích dẫn trong bài báo. Một kho tài liệu lớn hơn có thể có nghĩa là một biên giới ý tưởng rộng hơn. Nó cũng có thể có nghĩa là nhiều bài báo lặp lại những gì đã được viết hơn. Ilan Doron-Arad và Elchanan Mossel, hai nhà toán học tại MIT, đã bắt tay đo lường một mặt của câu hỏi đó.
Tính độc đáo có nhiều chiều và không có thước đo thống nhất. Nhưng một trong số đó giờ có thể đo được ở quy mô lớn: tính khác biệt về văn bản, tức mức độ một bài báo đọc lên giống các công trình gần đây. Các mô hình ngôn ngữ hiện đại có thể biến một đoạn văn thành một dãy số nắm bắt ý nghĩa của nó, nhờ đó hai đoạn văn nói cùng một điều bằng những từ ngữ khác nhau sẽ nằm gần nhau.
Các tác giả thận trọng về những gì phương pháp này nắm bắt được và không nắm bắt được. Một phát hiện thực sự mới vẫn có thể được viết bằng những câu quen thuộc; một cụm từ khác thường không phải là một ý tưởng mới.
Giữ cố định phép so sánh
Một phép so sánh ngây thơ sẽ gây hiểu lầm: khi kho tài liệu tăng lên, bất kỳ đoạn văn nào cũng có nhiều cơ hội giống với một điều gì đó hơn. Vì thế các tác giả giữ cố định nhóm đối chiếu. Với mỗi lĩnh vực trong tám lĩnh vực — vật lý thiên văn, tin sinh học, hóa học, biến đổi khí hậu, học máy, y học, tâm lý học và điện toán lượng tử — và mỗi năm từ 2015 đến 2025, họ lấy 300 bài báo từ cơ sở dữ liệu truy cập mở CORE và so sánh chúng với 3.000 bài báo của năm năm trước đó. Tổng cộng khoảng 26.000 bài toàn văn.
Mỗi bài báo được cắt thành những đoạn chồng lấn, mỗi đoạn 160 từ. Một trường hợp trùng khớp đòi hỏi độ tương đồng về nghĩa cao, ít nhất sáu thuật ngữ chuyên biệt chung, không có chuỗi năm từ giống hệt nhau — để loại trừ việc sao chép đơn thuần — không có tác giả chung, và không phải hai phiên bản của cùng một bài báo. Trên một tập kiểm tra được xây dựng cho mục đích này, bộ phát hiện hầu như không đưa ra kết quả trùng khớp sai (độ chính xác 99,6%) dù bỏ sót một số trường hợp thật.
Ổn định, rồi tăng vọt
Cho đến năm 2020, tỉ lệ văn bản của một bài báo trùng khớp với các công trình gần đây dao động quanh 0,43%. Từ năm 2021, nó tăng lên, đạt 1,34% vào năm 2025 — gấp 3,1 lần mức trước đó. Một kiểm định thống kê xác định điểm bắt đầu của sự gia tăng là năm 2021.
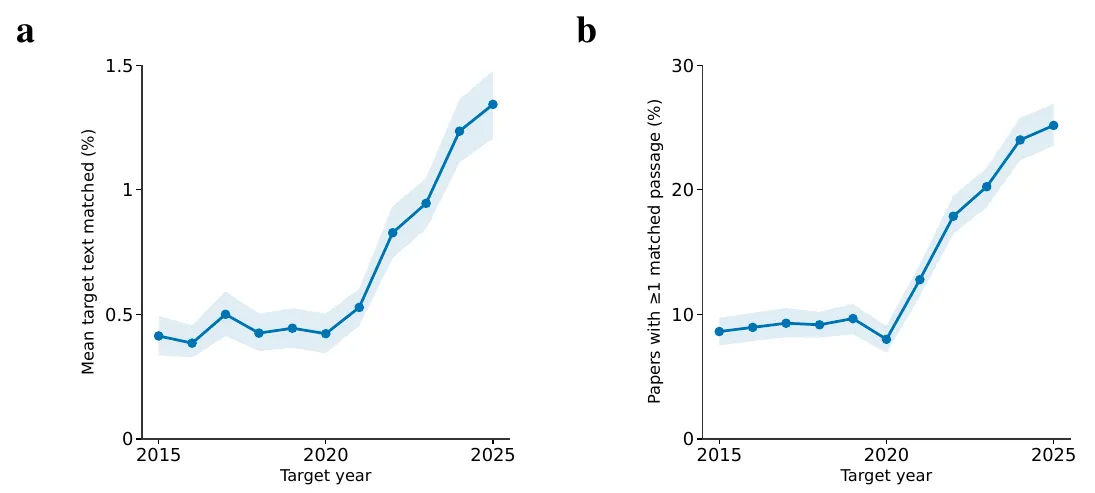
Trái: tỉ lệ trung bình văn bản của mỗi bài báo giống với công trình gần đây. Phải: tỉ lệ bài báo có ít nhất một đoạn như vậy. — Hình 1a–b, Doron-Arad & Mossel (2026), arXiv:2609.32963.
Sự gia tăng không đến từ một vài bài báo vay mượn nhiều. Tỉ lệ bài báo chứa ít nhất một đoạn lặp lại đạt 25% vào năm 2025. Cả tám lĩnh vực đều tăng, với tốc độ khác nhau.
Những tiếng vọng không có trích dẫn
Phải chăng các tác giả chỉ đơn giản trích dẫn những công trình mà họ lặp lại? Hiếm khi. Chỉ tìm được liên kết trích dẫn cho 6,4% các cặp bài báo trùng khớp, và một đợt kiểm tra thủ công trên 176 cặp cho kết quả 7%. Từ năm 2015 đến 2025, số cặp trùng khớp tăng từ 449 lên 1.831 — nhưng số cặp có trích dẫn vẫn ở mức 59 trong cả hai năm.
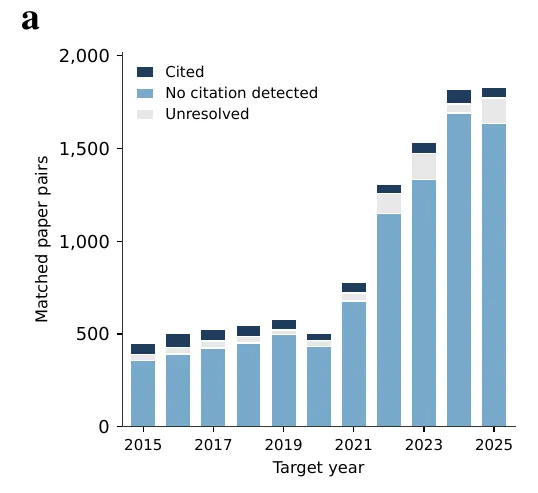
Số cặp bài báo trùng khớp mỗi năm, theo tình trạng trích dẫn: gần như toàn bộ mức tăng nằm ở các cặp không phát hiện trích dẫn. — Hình 3a, Doron-Arad & Mossel (2026), arXiv:2609.32963.
Nhóm cũng đặt câu hỏi liệu các ý tưởng có lặp lại hay không, chứ không chỉ cách diễn đạt. Các mô hình AI của Anthropic tóm tắt mỗi đoạn trong vài từ, rồi đánh giá, mà không xem văn bản gốc, liệu hai bản tóm tắt có diễn đạt về cơ bản cùng một tuyên bố khoa học hay không. Với một định nghĩa chặt chẽ, số cặp như vậy tăng từ trung bình khoảng 26 cặp mỗi năm trong giai đoạn 2015–2020 lên 139 vào năm 2025.
Xu hướng này vẫn đứng vững qua nhiều phép kiểm tra — các ngưỡng khác nhau, độ dài đoạn khác nhau, loại bỏ phần phương pháp và các nguồn bị sao chép nhiều nhất — và được tái hiện trong một cơ sở dữ liệu thứ hai, độc lập, Europe PMC, nơi tỉ lệ văn bản lặp lại tăng gấp đôi.
Một nghi phạm, không phải một phán quyết
Mức tăng lớn nhất trùng với giai đoạn các công cụ AI được áp dụng nhanh chóng để viết bài khoa học, và các tác giả xem chúng là một yếu tố góp phần hợp lý, vì chúng có xu hướng phổ biến những cách diễn đạt thông dụng nhất. Nhưng nghiên cứu không xác lập được nguyên nhân. Ngôn ngữ chung của từng chuyên ngành và việc sự chú ý bị thu hẹp vào cùng một số ít bài báo cũng có thể đóng một vai trò; theo quan điểm này, AI sẽ là chất xúc tác mới nhất cho một sự hội tụ đã diễn ra từ trước. Các tác giả cũng nhấn mạnh rằng sự tương đồng về ngữ nghĩa không có nghĩa là có hành vi sai trái.
Họ đề xuất những công cụ giúp tác giả, người phản biện, biên tập viên và các nhà tài trợ nhìn thấy được tính độc đáo — kèm một lời cảnh báo: đừng bao giờ biến điểm số về tính khác biệt thành một mục tiêu, vì nó sẽ khen thưởng cách diễn đạt khác thường hơn là hiểu biết thực sự, và sẽ dễ bị “lách”.