அறிவியல் தன்னைத்தானே திரும்பச் சொல்லத் தொடங்கிவிட்டதா?
அறிவியல் இலக்கியம் தொடர்ந்து வளர்கிறது — ஆய்வுக் கட்டுரையில் மேற்கோள் காட்டப்பட்ட எண்களின்படி, ஆண்டுக்குச் சுமார் 4%, ஏறக்குறைய ஒவ்வொரு 17 ஆண்டுகளுக்கும் இரட்டிப்பாகிறது. பெரிய இலக்கியம் என்பது கருத்துகளின் பரந்த எல்லையைக் குறிக்கலாம். ஏற்கெனவே எழுதப்பட்டதைத் திரும்பச் சொல்லும் அதிகக் கட்டுரைகளையும் குறிக்கலாம். MIT-யைச் சேர்ந்த கணிதவியலாளர்கள் இலான் டோரான்-அராத், எல்கானன் மோசெல் ஆகியோர் அந்தக் கேள்வியின் ஒரு பக்கத்தை அளக்கப் புறப்பட்டனர்.
அசல்தன்மைக்குப் பல பரிமாணங்கள் உள்ளன, ஒப்புக்கொள்ளப்பட்ட அளவுகோல் எதுவுமில்லை. ஆனால் அவற்றில் ஒன்றை இப்போது பெரிய அளவில் அளக்க முடியும்: உரைத் தனித்தன்மை (textual distinctiveness), அதாவது ஒரு கட்டுரையின் எவ்வளவு பகுதி சமீபத்திய ஆய்வுகளைப் போலப் படிக்கப்படுகிறது. நவீன மொழி மாதிரிகள் ஒரு பகுதியை அதன் பொருளைப் பிடிக்கும் எண்களின் பட்டியலாக மாற்ற முடியும்; அதனால் ஒரே விஷயத்தை வேறு சொற்களில் சொல்லும் இரண்டு பகுதிகள் ஒன்றுக்கொன்று அருகில் வந்து சேர்கின்றன.
இது எதைப் பிடிக்கிறது, எதைப் பிடிக்கவில்லை என்பதில் ஆய்வாளர்கள் கவனமாக உள்ளனர். உண்மையிலேயே புதிய ஒரு கண்டுபிடிப்பைப் பழக்கமான வாக்கியங்களில் எழுதலாம்; வழக்கத்துக்கு மாறான ஒரு சொற்றொடர் புதிய கருத்து அல்ல.
ஒப்பீட்டை நிலையாக வைத்தல்
எளிமையான ஒப்பீடு தவறாக வழிநடத்தும்: இலக்கியம் வளர வளர, எந்தப் பகுதிக்கும் ஏதோ ஒன்றை ஒத்திருக்க அதிக வாய்ப்புகள் கிடைக்கின்றன. எனவே ஆய்வாளர்கள் ஒப்பீட்டுத் தொகுப்பை நிலையாக வைத்தனர். எட்டுத் துறைகள் ஒவ்வொன்றுக்கும் — வானியற்பியல், உயிர்த்தகவலியல், வேதியியல், காலநிலை மாற்றம், இயந்திரக் கற்றல், மருத்துவம், உளவியல், குவாண்டம் கணிமை — 2015 முதல் 2025 வரை ஒவ்வோர் ஆண்டுக்கும், அவர்கள் திறந்த அணுகல் தரவுத்தளமான CORE-இலிருந்து 300 கட்டுரைகளை எடுத்து, முந்தைய ஐந்து ஆண்டுகளின் 3,000 கட்டுரைகளுடன் ஒப்பிட்டனர். மொத்தம், சுமார் 26,000 முழு உரைகள்.
ஒவ்வொரு கட்டுரையும் 160 சொற்கள் கொண்ட, ஒன்றின்மேல் ஒன்று படியும் பகுதிகளாக வெட்டப்பட்டது. ஒரு பொருத்தத்துக்கு உயர்ந்த பொருள் ஒற்றுமை, குறைந்தது ஆறு பகிரப்பட்ட குறிப்பிட்ட சொற்கள், ஐந்து சொற்களின் ஒரே மாதிரியான தொடர் எதுவும் இல்லாமை — எனவே நேரடி நகல் விலக்கப்படுகிறது — பகிரப்பட்ட ஆசிரியர் இல்லாமை, ஒரே கட்டுரையின் இரண்டு பதிப்புகள் அல்லாமை ஆகியவை தேவைப்பட்டன. இதற்காகவே உருவாக்கப்பட்ட ஒரு சோதனைத் தொகுப்பில், கண்டறிவி ஏறக்குறைய தவறான பொருத்தங்களைச் செய்யவில்லை (99.6% துல்லியம்), சில உண்மையான பொருத்தங்களைத் தவறவிட்டது.
நிலையாக, பின்னர் கூர்மையான உயர்வு
2020 வரை, ஒரு கட்டுரையின் உரையில் சமீபத்திய ஆய்வுகளுடன் பொருந்தும் பங்கு சுமார் 0.43% அருகே இருந்தது. 2021 முதல் அது ஏறி, 2025-இல் 1.34% ஐ எட்டியது — முந்தைய நிலையின் 3.1 மடங்கு. ஒரு புள்ளியியல் சோதனை உயர்வின் தொடக்கத்தை 2021-இல் வைக்கிறது.
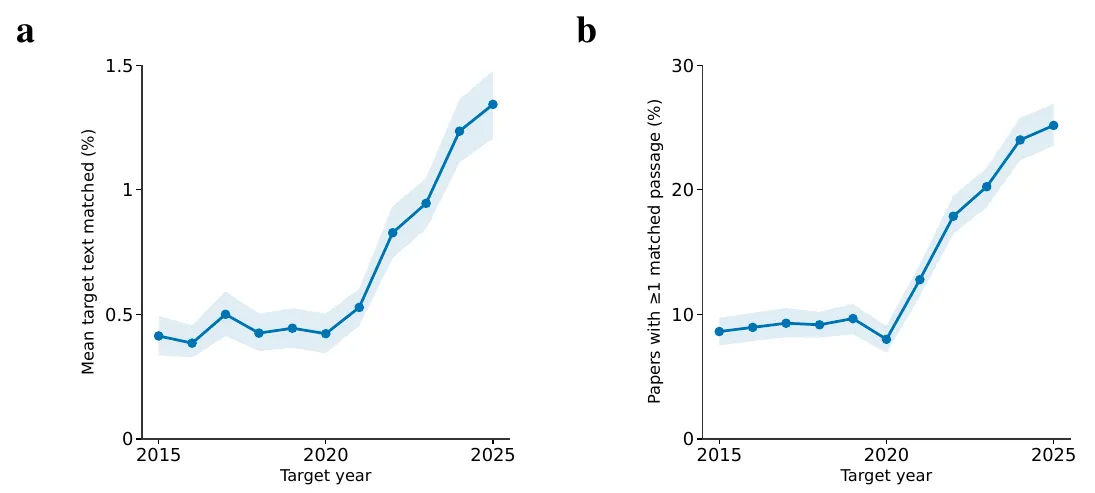
இடது: ஒவ்வொரு கட்டுரையின் உரையிலும் சமீபத்திய ஆய்வுகளை ஒத்திருக்கும் சராசரிப் பங்கு. வலது: குறைந்தது ஒரு அத்தகைய பகுதி கொண்ட கட்டுரைகளின் பங்கு. — படம் 1a–b, Doron-Arad & Mossel (2026), arXiv:2609.32963.
இந்த உயர்வு சில பெரிய கடன்வாங்குபவர்களிடமிருந்து வரவில்லை. குறைந்தது ஒரு எதிரொலிக்கும் பகுதி கொண்ட கட்டுரைகளின் பங்கு 2025-இல் 25% ஐ எட்டியது. எட்டுத் துறைகளும், வெவ்வேறு வீதங்களில், அதிகரித்தன.
மேற்கோள் இல்லாத எதிரொலிகள்
தாங்கள் எதிரொலிக்கும் ஆய்வை ஆசிரியர்கள் வெறுமனே மேற்கோள் காட்டினார்களா? அரிதாகவே. பொருந்திய கட்டுரை இணைகளில் வெறும் 6.4%-க்கு மட்டுமே மேற்கோள் இணைப்பு கண்டறியப்பட்டது; 176 இணைகளின் கைமுறைச் சோதனை 7% தந்தது. 2015-க்கும் 2025-க்கும் இடையே, பொருந்திய இணைகள் 449-இலிருந்து 1,831 ஆக வளர்ந்தன — ஆனால் மேற்கோள் கொண்டவை இரண்டு ஆண்டுகளிலும் 59-இலேயே இருந்தன.
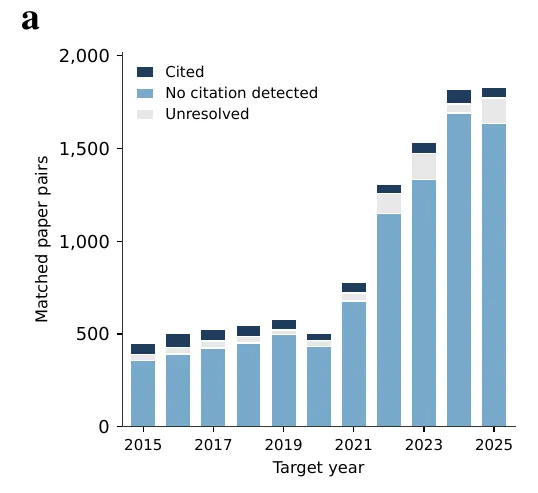
மேற்கோள் நிலையின்படி ஒவ்வோர் ஆண்டும் பொருந்திய கட்டுரை இணைகளின் எண்ணிக்கை: ஏறக்குறைய முழு வளர்ச்சியும் மேற்கோள் கண்டறியப்படாத இணைகளில்தான். — படம் 3a, Doron-Arad & Mossel (2026), arXiv:2609.32963.
சொற்கள் மட்டுமல்லாமல் கருத்துகளும் திரும்ப வருகின்றனவா என்றும் குழு கேட்டது. Anthropic-இன் AI மாதிரிகள் ஒவ்வொரு பகுதியையும் சில சொற்களில் சுருக்கி, பின்னர் மூல உரையைப் பார்க்காமல், இரண்டு சுருக்கங்கள் அடிப்படையில் ஒரே அறிவியல் கூற்றை வெளிப்படுத்துகின்றனவா என்று மதிப்பிட்டன. கண்டிப்பான வரையறையைப் பயன்படுத்தியபோது, அத்தகைய இணைகள் 2015–2020-இல் ஆண்டுக்குச் சராசரியாகச் சுமார் 26-இலிருந்து 2025-இல் 139 ஆக உயர்ந்தன.
இந்தப் போக்கு பல சோதனைகளிலும் நிலைத்தது — வெவ்வேறு வரம்புகள், பகுதி நீளங்கள், முறையியல் பிரிவுகளையும் அதிகம் நகலெடுக்கப்பட்ட மூலங்களையும் நீக்குதல் — மேலும் இரண்டாவது, சுயாதீனத் தரவுத்தளமான Europe PMC-இலும் மீண்டும் கிடைத்தது; அங்கே எதிரொலிக்கும் உரையின் பங்கு இரட்டிப்பானது.
ஒரு சந்தேக நபர், தீர்ப்பு அல்ல
மிகப் பெரிய அதிகரிப்பு, அறிவியல் எழுத்துக்கான AI கருவிகளின் விரைவான ஏற்புடன் ஒத்துப்போகிறது; அவை மிகப் பொதுவான சொற்றொடர்களைப் பரப்ப முனைவதால், ஆய்வாளர்கள் அவற்றை ஒரு நம்பத்தகுந்த பங்களிப்பாளராகப் பார்க்கின்றனர். ஆனால் ஆய்வு காரணத்தை நிறுவவில்லை. பகிரப்பட்ட துறைசார் மொழியும், அதே சில கட்டுரைகள் மீது கவனம் குறுகுவதும் பங்கு வகிக்கலாம்; இந்தப் பார்வையில், ஏற்கெனவே நடந்துவரும் ஒருமுகமாதலின் சமீபத்திய முடுக்கியாக AI இருக்கும். பொருள் ஒற்றுமை முறைகேட்டைக் குறிக்காது என்றும் ஆய்வாளர்கள் வலியுறுத்துகின்றனர்.
அசல்தன்மையை ஆசிரியர்கள், மதிப்பாய்வாளர்கள், பதிப்பாசிரியர்கள், நிதியளிப்பவர்களுக்குத் தெரியும்படி செய்யும் கருவிகளை அவர்கள் பரிந்துரைக்கின்றனர் — ஓர் எச்சரிக்கையுடன்: தனித்தன்மை மதிப்பெண்ணை ஒருபோதும் இலக்காக்க வேண்டாம், ஏனெனில் அது உண்மையான நுண்ணறிவைவிட வழக்கத்துக்கு மாறான சொல்லாடலுக்கு வெகுமதி அளிக்கும், அதை ஏமாற்றுவதும் எளிதாக இருக்கும்.