BİLİM KENDİNİ TEKRARLAMAYA MI BAŞLADI?
Bilimsel literatür büyümeye devam ediyor — makalede aktarılan rakamlara göre yılda kabaca %4, yaklaşık her 17 yılda iki katına çıkarak. Daha büyük bir literatür, daha geniş bir fikir sınırı anlamına gelebilir. Daha önce yazılmış olanı tekrarlayan daha fazla makale anlamına da gelebilir. MIT’den matematikçiler Ilan Doron-Arad ve Elchanan Mossel, bu sorunun bir yanını ölçmeye koyuldu.
Özgünlüğün pek çok boyutu var ve üzerinde uzlaşılmış bir ölçüsü yok. Ama bunlardan biri artık geniş ölçekte ölçülebilir: metinsel ayırt edicilik, yani bir makalenin ne kadarının yakın tarihli çalışmalar gibi okunduğu. Modern dil modelleri bir pasajı anlamını yakalayan bir sayı listesine dönüştürebiliyor; böylece aynı şeyi farklı sözcüklerle söyleyen iki pasaj birbirine yakın düşüyor.
Yazarlar bunun neyi yakalayıp neyi yakalamadığı konusunda dikkatli. Gerçekten yeni bir bulgu tanıdık cümlelerle yazılabilir; alışılmadık bir ifade yeni bir fikir değildir.
Karşılaştırmayı sabit tutmak
Saf bir karşılaştırma yanıltıcı olurdu: literatür büyüdükçe herhangi bir pasajın bir şeye benzeme şansı artar. Bu yüzden yazarlar karşılaştırma havuzunu sabit tuttu. Sekiz alanın — astrofizik, biyoenformatik, kimya, iklim değişikliği, makine öğrenmesi, tıp, psikoloji ve kuantum hesaplama — her biri için ve 2015’ten 2025’e her yıl için, açık erişimli CORE veritabanından 300 makale aldılar ve bunları önceki beş yılın 3.000 makalesiyle karşılaştırdılar. Toplamda yaklaşık 26.000 tam metin.
Her makale 160 sözcüklük örtüşen pasajlara bölündü. Bir eşleşme için yüksek bir anlam benzerliği, en az altı ortak özgül terim, beş sözcüklük hiçbir özdeş dizi bulunmaması — böylece düz kopyalama hariç tutuluyor —, ortak yazar olmaması ve aynı makalenin iki sürümü olmaması gerekiyordu. Bu amaçla oluşturulan bir test kümesinde dedektör neredeyse hiç yanlış eşleşme yapmadı (%99,6 kesinlik), bazı gerçek eşleşmeleri ise kaçırdı.
Önce sabit, sonra keskin bir artış
2020’ye kadar bir makalenin metninin yakın tarihli çalışmalarla eşleşen payı %0,43 civarında seyrediyordu. 2021’den itibaren tırmandı ve 2025’te %1,34’e ulaştı — önceki düzeyin 3,1 katı. Bir istatistiksel test artışın başlangıcını 2021’e yerleştiriyor.
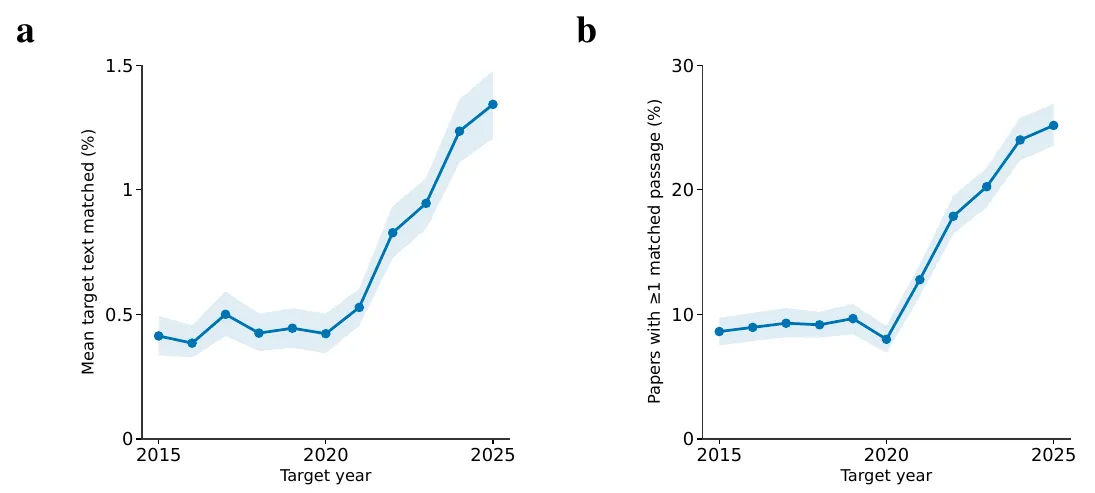
Sol: her makalenin metninin yakın tarihli çalışmalara benzeyen ortalama payı. Sağ: en az bir böyle pasaj içeren makalelerin payı. — Şekil 1a–b, Doron-Arad ve Mossel (2026), arXiv:2609.32963.
Artış birkaç büyük ödünç alıcıdan gelmedi. En az bir yankılanan pasaj içeren makalelerin payı 2025’te %25’e ulaştı. Sekiz alanın hepsi farklı hızlarda arttı.
Atıfsız yankılar
Yazarlar yankıladıkları çalışmaya basitçe atıf mı yaptı? Nadiren. Eşleşen makale çiftlerinin yalnızca %6,4’ü için bir atıf bağlantısı bulunabildi ve 176 çiftin elle denetimi %7 verdi. 2015 ile 2025 arasında eşleşen çiftler 449’dan 1.831’e çıktı — ama atıflı olanlar her iki yılda da 59’da kaldı.
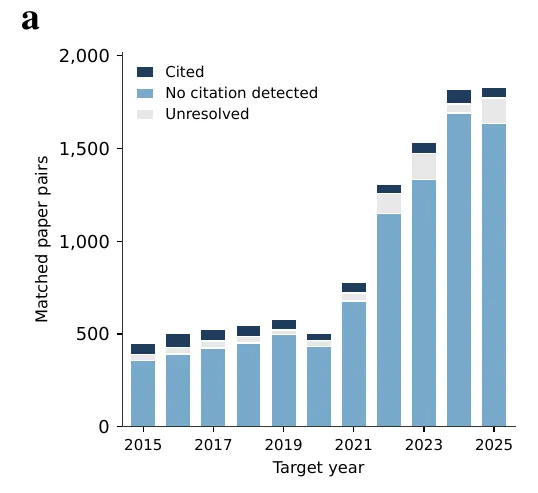
Her yıl eşleşen makale çiftlerinin sayısı, atıf durumuna göre: büyümenin neredeyse tamamı saptanmış atıfı olmayan çiftlerde. — Şekil 3a, Doron-Arad ve Mossel (2026), arXiv:2609.32963.
Ekip yalnızca ifadelerin değil, fikirlerin de tekrarlanıp tekrarlanmadığını sordu. Anthropic’in yapay zekâ modelleri her pasajı birkaç sözcükle özetledi, ardından özgün metni görmeden iki özetin esasen aynı bilimsel iddiayı dile getirip getirmediğine karar verdi. Katı bir tanım kullanıldığında bu tür çiftler 2015–2020’de yılda ortalama yaklaşık 26’dan 2025’te 139’a çıktı.
Desen pek çok denetim altında geçerliliğini korudu — farklı eşikler, pasaj uzunlukları, yöntem bölümlerinin ve en çok kopyalanan kaynakların çıkarılması — ve yankılanan metnin payının iki katına çıktığı ikinci, bağımsız bir veritabanında, Europe PMC’de de tekrarlandı.
Bir şüpheli, bir hüküm değil
En büyük artış, bilimsel yazım için yapay zekâ araçlarının hızla benimsenmesiyle aynı döneme denk geliyor ve yazarlar, en yaygın ifadeleri yayma eğiliminde oldukları için onları makul bir katkıda bulunan olarak görüyor. Ama çalışma nedeni ortaya koymuyor. Ortak disiplin dili ve dikkatin aynı birkaç makaleye daralması da rol oynayabilir; bu görüşe göre yapay zekâ, zaten süren bir yakınsamanın en son hızlandırıcısı olur. Yazarlar ayrıca anlamsal benzerliğin suistimal anlamına gelmediğini vurguluyor.
Özgünlüğü yazarlar, hakemler, editörler ve fon sağlayıcılar için görünür kılan araçlar öneriyorlar — bir uyarıyla: bir ayırt edicilik puanını asla hedef haline getirmeyin, çünkü gerçek kavrayış yerine alışılmadık ifadeleri ödüllendirir ve kolayca manipüle edilebilir.