BEGINNT DIE WISSENSCHAFT, SICH ZU WIEDERHOLEN?
Die wissenschaftliche Literatur wächst ständig — um etwa 4 % pro Jahr, mit einer Verdopplung ungefähr alle 17 Jahre, nach den in der Studie zitierten Zahlen. Eine größere Literatur könnte eine breitere Front von Ideen bedeuten. Sie könnte aber auch mehr Artikel bedeuten, die wiederholen, was bereits geschrieben wurde. Ilan Doron-Arad und Elchanan Mossel, Mathematiker am MIT, haben sich vorgenommen, eine Seite dieser Frage zu messen.
Originalität hat viele Dimensionen und kein anerkanntes Maß. Eine davon lässt sich heute jedoch in großem Maßstab messen: die textuelle Eigenständigkeit, also wie viel eines Artikels sich wie jüngere Arbeiten liest. Moderne Sprachmodelle können eine Passage in eine Liste von Zahlen verwandeln, die ihre Bedeutung erfasst, sodass zwei Passagen, die dasselbe mit anderen Worten sagen, nah beieinander landen.
Die Autoren achten genau darauf, was das erfasst und was nicht. Ein wirklich neuer Befund kann mit vertrauten Sätzen geschrieben sein; eine ungewöhnliche Formulierung ist keine neue Idee.
Den Vergleich konstant halten
Ein naiver Vergleich wäre irreführend: Je größer die Literatur, desto mehr Chancen hat jede Passage, irgendetwas zu ähneln. Deshalb hielten die Autoren den Vergleichsbestand konstant. Für jedes von acht Fächern — Astrophysik, Bioinformatik, Chemie, Klimawandel, maschinelles Lernen, Medizin, Psychologie und Quantencomputing — und jedes Jahr von 2015 bis 2025 nahmen sie 300 Artikel aus der Open-Access-Datenbank CORE und verglichen sie mit 3.000 Artikeln der fünf Vorjahre. Insgesamt waren es etwa 26.000 Volltexte.
Jeder Artikel wurde in überlappende Passagen von 160 Wörtern zerlegt. Ein Treffer erforderte eine hohe Bedeutungsähnlichkeit, mindestens sechs gemeinsame Fachbegriffe, keine identische Folge von fünf Wörtern — so ist bloßes Kopieren ausgeschlossen —, keinen gemeinsamen Autor und keine zwei Versionen desselben Artikels. Auf einem eigens dafür erstellten Testdatensatz erzeugte der Detektor fast keine falschen Treffer (99,6 % Präzision), verpasste aber einige echte.
Stabil, dann ein steiler Anstieg
Bis 2020 lag der Anteil am Text eines Artikels, der jüngeren Arbeiten entsprach, bei etwa 0,43 %. Ab 2021 stieg er und erreichte 2025 1,34 % — das 3,1-Fache des früheren Niveaus. Ein statistischer Test legt den Beginn des Anstiegs auf 2021.
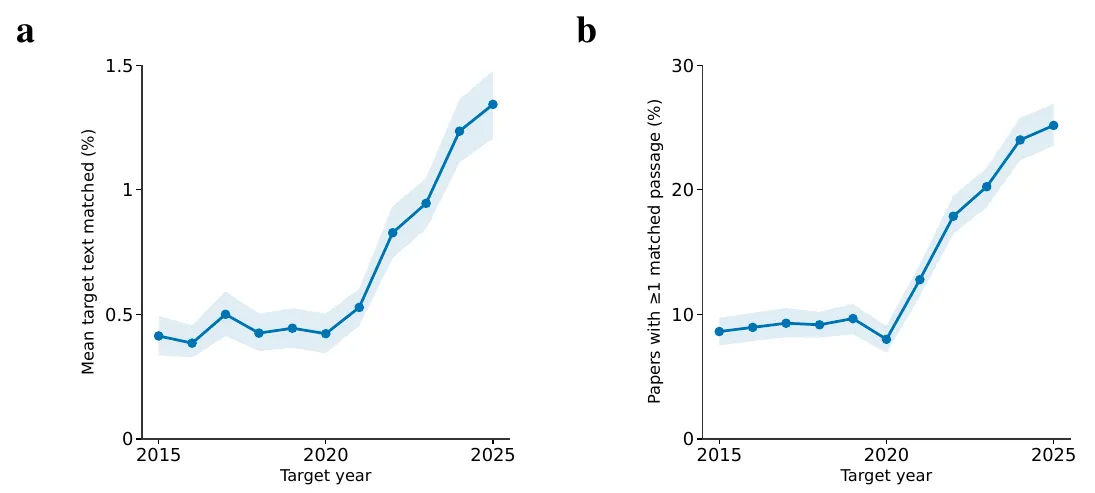
Links: mittlerer Anteil des Texts jedes Artikels, der jüngeren Arbeiten ähnelt. Rechts: Anteil der Artikel mit mindestens einer solchen Passage. — Abbildung 1a–b, Doron-Arad & Mossel (2026), arXiv:2609.32963.
Der Anstieg ging nicht auf einige wenige starke Entleiher zurück. Der Anteil der Artikel mit mindestens einer Echo-Passage erreichte 2025 25 %. Alle acht Fächer legten zu, in unterschiedlichem Tempo.
Echos ohne Zitate
Haben die Autoren einfach die Arbeiten zitiert, die sie wiedergeben? Selten. Nur für 6,4 % der übereinstimmenden Artikelpaare ließ sich eine Zitierverbindung finden, und eine manuelle Prüfung von 176 Paaren ergab 7 %. Zwischen 2015 und 2025 stieg die Zahl der übereinstimmenden Paare von 449 auf 1.831 — die mit Zitat blieben in beiden Jahren bei 59.
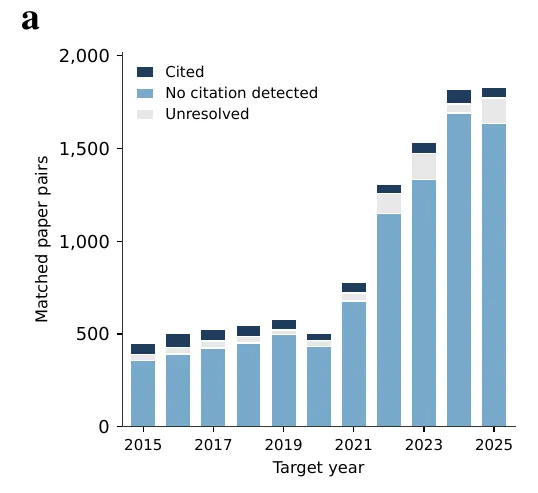
Anzahl übereinstimmender Artikelpaare pro Jahr nach Zitierstatus: Fast das gesamte Wachstum entfällt auf Paare ohne erkanntes Zitat. — Abbildung 3a, Doron-Arad & Mossel (2026), arXiv:2609.32963.
Das Team fragte auch, ob sich die Ideen wiederholen, nicht nur die Formulierung. KI-Modelle von Anthropic fassten jede Passage in wenigen Worten zusammen und beurteilten dann, ohne den Originaltext zu sehen, ob zwei Zusammenfassungen im Wesentlichen dieselbe wissenschaftliche Aussage ausdrückten. Nach einer strengen Definition stieg die Zahl solcher Paare von durchschnittlich etwa 26 pro Jahr in 2015–2020 auf 139 im Jahr 2025.
Das Muster hielt vielen Prüfungen stand — anderen Schwellenwerten, Passagenlängen, dem Entfernen der Methodenteile und der am häufigsten kopierten Quellen — und ließ sich in einer zweiten, unabhängigen Datenbank, Europe PMC, reproduzieren, wo sich der Anteil an Echo-Text verdoppelte.
Ein Verdächtiger, kein Urteil
Der stärkste Anstieg fällt mit der raschen Verbreitung von KI-Werkzeugen zum Schreiben wissenschaftlicher Texte zusammen, und die Autoren sehen in ihnen einen plausiblen Faktor, da sie dazu neigen, die gängigsten Formulierungen zu verbreiten. Die Ursache belegt die Studie jedoch nicht. Eine gemeinsame Fachsprache und die Verengung der Aufmerksamkeit auf dieselben wenigen Artikel könnten ebenfalls eine Rolle spielen; aus dieser Sicht wäre KI der jüngste Beschleuniger einer bereits laufenden Angleichung. Die Autoren betonen außerdem, dass semantische Ähnlichkeit kein Fehlverhalten bedeutet.
Sie schlagen Werkzeuge vor, die Originalität für Autoren, Gutachter, Herausgeber und Geldgeber sichtbar machen — mit einer Warnung: Eine Eigenständigkeitspunktzahl dürfe nie zum Ziel werden, denn sie würde ungewöhnliche Formulierungen statt echter Erkenntnis belohnen und ließe sich leicht austricksen.