क्या विज्ञान ख़ुद को दोहराने लगा है?
वैज्ञानिक साहित्य लगातार बढ़ रहा है — शोधपत्र में दिए आँकड़ों के अनुसार लगभग 4% प्रति वर्ष, यानी हर क़रीब 17 साल में दोगुना। बड़ा साहित्य विचारों की एक चौड़ी सीमा का संकेत हो सकता है। इसका मतलब यह भी हो सकता है कि ऐसे शोधपत्र बढ़ रहे हैं जो पहले से लिखी बातें दोहराते हैं। MIT के गणितज्ञ इलान डोरोन-अराद और एलखानान मोसेल ने इस सवाल के एक पहलू को मापने का बीड़ा उठाया।
मौलिकता के कई आयाम हैं और उसका कोई सर्वमान्य पैमाना नहीं है। लेकिन उनमें से एक को अब बड़े पैमाने पर मापा जा सकता है: पाठ की विशिष्टता (textual distinctiveness), यानी किसी शोधपत्र का कितना हिस्सा हाल के कामों जैसा पढ़ता है। आधुनिक भाषा मॉडल किसी अंश को संख्याओं की एक सूची में बदल सकते हैं जो उसके अर्थ को पकड़ती है, ताकि एक ही बात को अलग शब्दों में कहने वाले दो अंश एक-दूसरे के पास आ जाएँ।
लेखक इस बारे में सावधान हैं कि यह तरीका क्या पकड़ता है और क्या नहीं। एक सचमुच नई खोज जाने-पहचाने वाक्यों में लिखी जा सकती है; और कोई असामान्य वाक्यांश अपने-आप में नया विचार नहीं होता।
तुलना को स्थिर रखना
एक भोली तुलना भ्रामक होती: जैसे-जैसे साहित्य बढ़ता है, किसी भी अंश के किसी न किसी चीज़ से मिलने की संभावना बढ़ जाती है। इसलिए लेखकों ने तुलना के समूह को स्थिर रखा। आठ क्षेत्रों — खगोलभौतिकी, जैव-सूचना विज्ञान, रसायन विज्ञान, जलवायु परिवर्तन, मशीन लर्निंग, चिकित्सा, मनोविज्ञान और क्वांटम कंप्यूटिंग — में से हर एक के लिए, और 2015 से 2025 तक हर वर्ष के लिए, उन्होंने ओपन-एक्सेस डेटाबेस CORE से 300 शोधपत्र लिए और उनकी तुलना पिछले पाँच वर्षों के 3,000 शोधपत्रों से की। कुल मिलाकर लगभग 26,000 पूरे पाठ।
हर शोधपत्र को 160 शब्दों के एक-दूसरे पर चढ़े हुए अंशों में काटा गया। मिलान मानने के लिए ज़रूरी था: अर्थ की ऊँची समानता, कम से कम छह साझा विशिष्ट शब्द, पाँच शब्दों का कोई भी एक-जैसा क्रम नहीं — ताकि सीधी नक़ल बाहर रहे — कोई साझा लेखक नहीं, और एक ही शोधपत्र के दो संस्करण नहीं। इसी उद्देश्य से बनाए गए एक परीक्षण-समूह पर, डिटेक्टर ने लगभग कोई ग़लत मिलान नहीं किया (99.6% परिशुद्धता), हालाँकि कुछ सच्चे मिलान छूट गए।
स्थिरता, फिर तेज़ उछाल
2020 तक, किसी शोधपत्र के पाठ का हाल के कामों से मिलने वाला हिस्सा लगभग 0.43% के आसपास बना रहा। 2021 से यह चढ़ने लगा और 2025 में 1.34% पर पहुँच गया — पहले के स्तर का 3.1 गुना। एक सांख्यिकीय परीक्षण इस वृद्धि की शुरुआत 2021 में रखता है।
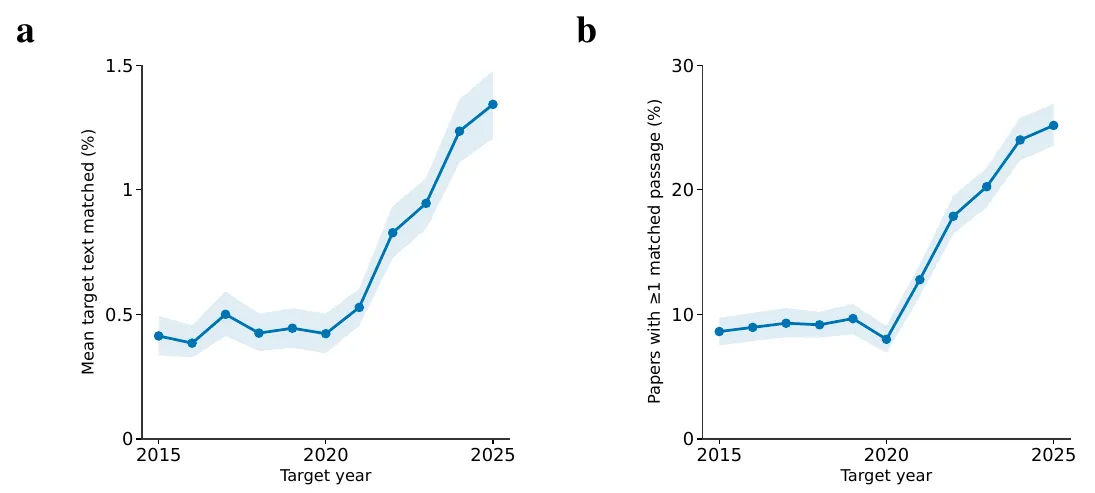
बाएँ: हर शोधपत्र के पाठ का औसत हिस्सा जो हाल के कामों जैसा है। दाएँ: कम से कम एक ऐसे अंश वाले शोधपत्रों का हिस्सा। — चित्र 1a–b, डोरोन-अराद और मोसेल (2026), arXiv:2609.32963.
यह वृद्धि कुछ भारी उधार लेने वालों से नहीं आई। कम से कम एक प्रतिध्वनि करने वाले अंश वाले शोधपत्रों का हिस्सा 2025 में 25% तक पहुँच गया। आठों क्षेत्रों में बढ़ोतरी हुई, अलग-अलग दरों से।
बिना हवाले की प्रतिध्वनियाँ
क्या लेखकों ने बस उन कामों का हवाला दिया जिनकी वे प्रतिध्वनि करते हैं? शायद ही कभी। मिलान वाले शोधपत्र-जोड़ों में से केवल 6.4% के बीच हवाले का कोई संबंध मिला, और 176 जोड़ों की हाथ से की गई जाँच में यह 7% निकला। 2015 से 2025 के बीच, मिलान वाले जोड़े 449 से बढ़कर 1,831 हो गए — लेकिन हवाले वाले जोड़े दोनों वर्षों में 59 ही रहे।
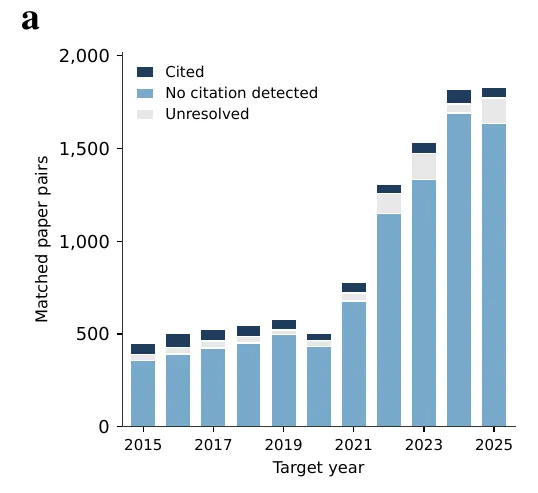
हर वर्ष मिलान वाले शोधपत्र-जोड़ों की संख्या, हवाले की स्थिति के अनुसार: लगभग सारी वृद्धि उन जोड़ों में है जिनमें कोई हवाला नहीं मिला। — चित्र 3a, डोरोन-अराद और मोसेल (2026), arXiv:2609.32963.
टीम ने यह भी पूछा कि क्या सिर्फ़ शब्द नहीं, बल्कि विचार भी दोहराए जा रहे हैं। Anthropic के AI मॉडलों ने हर अंश का कुछ शब्दों में सार बनाया, फिर मूल पाठ देखे बिना यह आँका कि क्या दो सार मूलतः एक ही वैज्ञानिक दावा व्यक्त करते हैं। सख़्त परिभाषा के साथ, ऐसे जोड़े 2015–2020 में औसतन लगभग 26 प्रति वर्ष से बढ़कर 2025 में 139 हो गए।
यह पैटर्न कई जाँचों में टिका रहा — अलग सीमाएँ, अंशों की अलग लंबाई, विधि वाले खंडों और सबसे ज़्यादा नक़ल किए गए स्रोतों को हटाना — और एक दूसरे, स्वतंत्र डेटाबेस Europe PMC में भी दोहराया गया, जहाँ प्रतिध्वनि करने वाले पाठ का हिस्सा दोगुना हो गया।
एक संदिग्ध, फ़ैसला नहीं
सबसे बड़ी वृद्धि विज्ञान-लेखन के लिए AI उपकरणों के तेज़ी से अपनाए जाने के साथ मेल खाती है, और लेखक उन्हें एक संभावित योगदानकर्ता मानते हैं, क्योंकि वे सबसे आम शब्द-विन्यास को फैलाने की ओर झुकते हैं। लेकिन अध्ययन कारण स्थापित नहीं करता। किसी विषय की साझा भाषा और ध्यान का गिने-चुने उन्हीं शोधपत्रों पर सिमट जाना भी भूमिका निभा सकते हैं; इस नज़रिए से, AI पहले से चल रहे एकरूपीकरण का सबसे नया त्वरक होगा। लेखक यह भी ज़ोर देकर कहते हैं कि अर्थ की समानता का मतलब कदाचार नहीं है।
वे ऐसे उपकरणों का सुझाव देते हैं जो लेखकों, समीक्षकों, संपादकों और वित्तपोषकों के लिए मौलिकता को दृश्यमान बनाएँ — एक चेतावनी के साथ: विशिष्टता के अंक को कभी लक्ष्य न बनाया जाए, क्योंकि वह असली अंतर्दृष्टि के बजाय असामान्य शब्दों को पुरस्कृत करेगा, और उसमें आसानी से हेरफेर की जा सकेगी।