科学开始自我重复了吗?
科学文献在不断增长——根据论文中引用的数据,每年约增长4%,大约每17年翻一番。更庞大的文献可能意味着更广阔的思想前沿,也可能意味着更多论文在重复已经写过的内容。麻省理工学院的数学家伊兰·多龙-阿拉德(Ilan Doron-Arad)和埃尔恰南·莫塞尔(Elchanan Mossel)着手测量这个问题的一个侧面。
原创性有许多维度,也没有公认的衡量标准。但其中一个维度如今已可以大规模测量:文本独特性,即一篇论文有多少内容读起来像近期的研究。现代语言模型可以把一个段落转换成一串捕捉其含义的数字,这样,两个用不同措辞表达同一内容的段落,最终会彼此靠近。
作者对这种方法能捕捉什么、不能捕捉什么十分谨慎。一项真正新颖的发现,可以用熟悉的句子写出来;一个不寻常的措辞,也不等于一个新想法。
固定比较基准
简单的比较会产生误导:随着文献增长,任何段落与某些内容相似的机会都会增加。因此,作者保持比较池的规模不变。在八个领域——天体物理学、生物信息学、化学、气候变化、机器学习、医学、心理学和量子计算——中,对2015年至2025年的每一年,他们从开放获取数据库CORE中选取300篇论文,与此前五年的3000篇论文进行比较。总计约2.6万篇全文。
每篇论文被切分成相互重叠的160词段落。一个匹配须满足:语义高度相似,至少共享六个专门术语,没有连续五个相同的词——从而排除直接复制——没有共同作者,且不是同一篇论文的两个版本。在一个专门构建的测试集上,该检测器几乎没有误判(精确率99.6%),但漏掉了一些真实匹配。
先稳定,后急升
2020年以前,论文中与近期研究相匹配的文本比例徘徊在0.43%左右。从2021年起,这一比例开始攀升,到2025年达到1.34%——是此前水平的3.1倍。一项统计检验将增长的起点定在2021年。
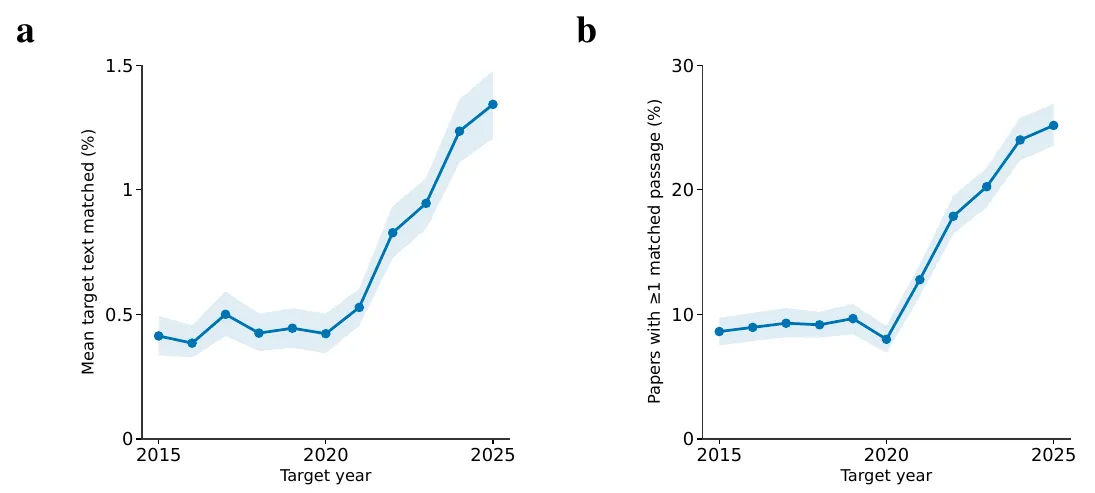
左:每篇论文中与近期研究相似的文本平均比例。右:至少含有一个此类段落的论文比例。——图1a–b,Doron-Arad和Mossel(2026),arXiv:2609.32963。
这一增长并非来自少数“大量借用者”。2025年,至少含有一个呼应段落的论文比例达到25%。八个领域都在增长,只是速度不同。
没有引用的呼应
作者们是否只是引用了他们所呼应的研究?很少。只有6.4%的匹配论文对能找到引用关系,对176对论文的人工核查得出的比例为7%。2015年至2025年间,匹配论文对从449对增至1831对——但其中有引用关系的,两年都只有59对。
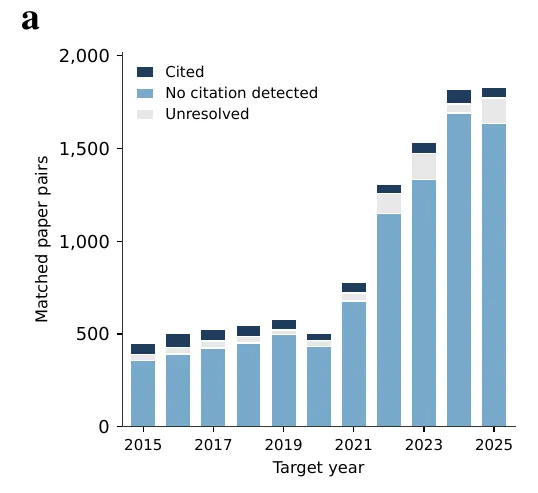
按引用状态划分的每年匹配论文对数量:几乎所有增长都来自未检测到引用的论文对。——图3a,Doron-Arad和Mossel(2026),arXiv:2609.32963。
团队还考察了重复的是否不只是措辞,还有观点。Anthropic公司的AI模型用几个词概括每个段落,然后在看不到原文的情况下,判断两条概括是否表达了本质上相同的科学论断。按照严格的定义,这类论文对从2015—2020年平均每年约26对,增加到2025年的139对。
这一规律经受住了许多检验——不同的阈值、段落长度,去除方法部分和被复制最多的来源——并在第二个独立数据库Europe PMC中得到复现,在那里,呼应文本的比例翻了一番。
是嫌疑,不是判决
最大幅度的增长与AI工具在科学写作中的迅速普及同时发生,作者认为它们可能是原因之一,因为这些工具倾向于传播最常见的表述。但研究并未确定原因。学科内共享的语言,以及注意力日益集中于同一批少数论文,也可能起作用;按照这种观点,AI只是一场早已开始的趋同过程的最新加速器。作者还强调,语义相似并不意味着学术不端。
他们建议开发能让作者、审稿人、编辑和资助者看到原创性的工具——但提出一个警告:永远不要把独特性分数当作目标,因为那样会奖励不寻常的措辞而非真正的洞见,而且很容易被操纵。