آیا علم دارد خودش را تکرار میکند؟
ادبیات علمی پیوسته رشد میکند — بر پایهٔ ارقامی که مقاله نقل میکند، تقریباً 4% در سال، یعنی دو برابر شدن در هر حدود 17 سال. ادبیاتی بزرگتر میتواند به معنای مرزی گستردهتر از ایدهها باشد. همچنین میتواند به معنای مقالههای بیشتری باشد که آنچه را پیشتر نوشته شده تکرار میکنند. ایلان دورون-آراد و الکانان موسل، ریاضیدانانی در MIT، بر آن شدند تا یک جنبه از این پرسش را اندازه بگیرند.
اصالت ابعاد بسیاری دارد و هیچ معیار مورد توافقی ندارد. اما یکی از این ابعاد اکنون در مقیاس بزرگ اندازهپذیر است: تمایز متنی، یعنی اینکه چه مقدار از یک مقاله شبیه کارهای اخیر خوانده میشود. مدلهای زبانی امروزی میتوانند یک بند را به فهرستی از اعداد تبدیل کنند که معنای آن را در بر میگیرد، بهطوری که دو بند که همان چیز را با واژههای متفاوت میگویند در نهایت به هم نزدیک میافتند.
نویسندگان دربارهٔ اینکه این روش چه چیزی را میسنجد و چه چیزی را نمیسنجد محتاطاند. یک یافتهٔ واقعاً تازه میتواند با جملههای آشنا نوشته شود؛ یک عبارت غیرمعمول، ایدهای تازه نیست.
ثابت نگه داشتن مقایسه
یک مقایسهٔ سادهانگارانه گمراهکننده میبود: با رشد ادبیات، هر بندی شانس بیشتری دارد که به چیزی شبیه باشد. بنابراین نویسندگان مجموعهٔ مقایسه را ثابت نگه داشتند. برای هر یک از هشت رشته — اخترفیزیک، بیوانفورماتیک، شیمی، تغییر اقلیم، یادگیری ماشین، پزشکی، روانشناسی و رایانش کوانتومی — و برای هر سال از 2015 تا 2025، آنها 300 مقاله از پایگاه دادهٔ دسترسی آزاد CORE برداشتند و آنها را با 3,000 مقاله از پنج سال پیش از آن مقایسه کردند. در مجموع، حدود 26,000 متن کامل.
هر مقاله به بندهای همپوشان 160 واژهای بریده شد. برای یک تطابق لازم بود: شباهت معنایی بالا، دستکم شش اصطلاح تخصصی مشترک، هیچ رشتهٔ یکسانی از پنج واژه — تا کپیبرداری ساده کنار گذاشته شود — هیچ نویسندهٔ مشترک، و نه دو نسخه از یک مقاله. روی یک مجموعهٔ آزمون که برای همین منظور ساخته شده بود، این آشکارساز تقریباً هیچ تطابق نادرستی نداشت (دقت 99.6%)، در حالی که برخی تطابقهای واقعی را از دست میداد.
ثابت، سپس جهشی تند
تا 2020، سهم متن یک مقاله که با کارهای اخیر تطابق داشت حول 0.43% در نوسان بود. از 2021 بالا رفت و در 2025 به 1.34% رسید — 3.1 برابر سطح پیشین. یک آزمون آماری آغاز این افزایش را در 2021 قرار میدهد.
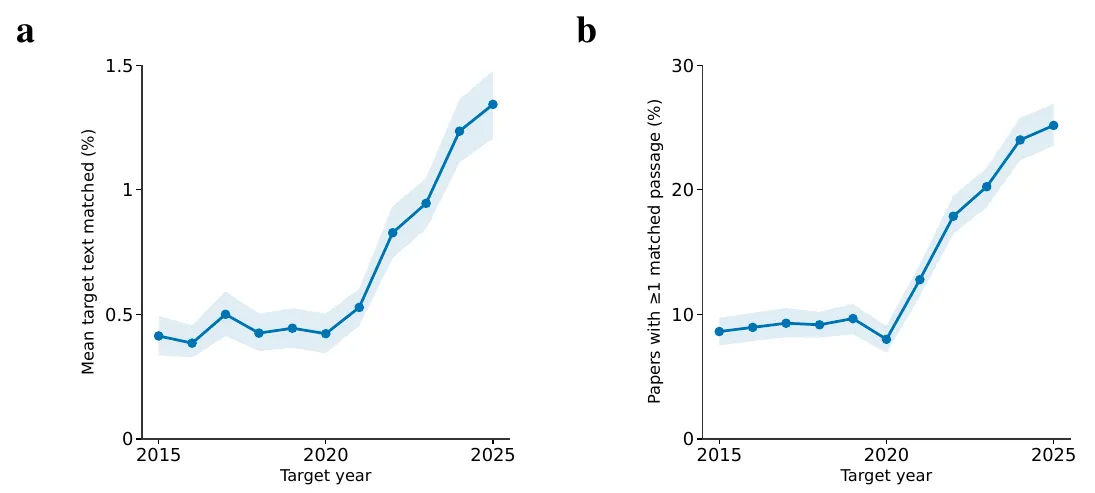
چپ: میانگین سهم متن هر مقاله که به کارهای اخیر شبیه است. راست: سهم مقالههایی که دستکم یک چنین بندی دارند. — شکل 1a–b، Doron-Arad & Mossel (2026)، arXiv:2609.32963.
این افزایش از چند وامگیرندهٔ پرکار نیامد. سهم مقالههایی که دستکم یک بند پژواکگونه دارند در 2025 به 25% رسید. هر هشت رشته افزایش داشتند، با آهنگهای متفاوت.
پژواکهایی بدون ارجاع
آیا نویسندگان به سادگی به کاری که پژواکش را تکرار میکنند ارجاع دادهاند؟ بهندرت. تنها برای 6.4% از جفتمقالههای منطبق پیوند ارجاعی یافت شد، و بررسی دستی 176 جفت به 7% رسید. میان 2015 و 2025، جفتهای منطبق از 449 به 1,831 رسیدند — اما شمار جفتهای دارای ارجاع در هر دو سال 59 ماند.
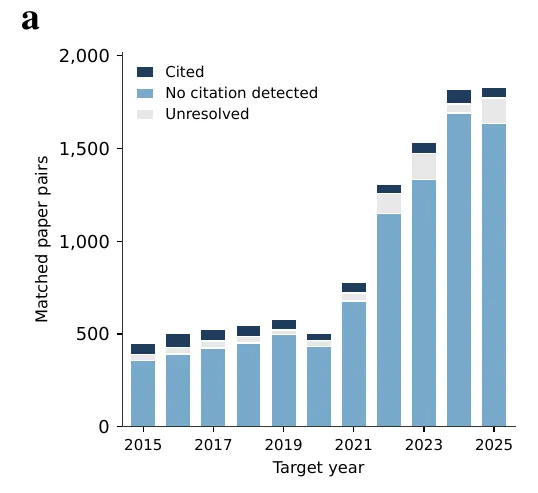
شمار جفتمقالههای منطبق در هر سال، بر حسب وضعیت ارجاع: تقریباً همهٔ رشد در جفتهایی است که ارجاعی برایشان یافت نشده. — شکل 3a، Doron-Arad & Mossel (2026)، arXiv:2609.32963.
گروه همچنین پرسید آیا ایدهها تکرار میشوند، نه فقط واژهها. مدلهای هوش مصنوعی شرکت Anthropic هر بند را در چند واژه خلاصه کردند، سپس بدون دیدن متن اصلی داوری کردند که آیا دو خلاصه در اصل همان ادعای علمی را بیان میکنند. با تعریفی سختگیرانه، چنین جفتهایی از میانگین حدود 26 در سال در 2015–2020 به 139 در 2025 رسیدند.
این الگو در برابر بررسیهای بسیاری پایدار ماند — آستانههای متفاوت، طولهای متفاوت بند، حذف بخشهای روششناسی و پرکپیترین منابع — و در پایگاه دادهٔ دوم و مستقلی، Europe PMC، تکرار شد، جایی که سهم متن پژواکگونه دو برابر شد.
یک مظنون، نه یک حکم
بزرگترین افزایش با پذیرش سریع ابزارهای هوش مصنوعی برای نگارش علمی همزمان است، و نویسندگان آنها را عاملی محتمل میدانند، چون این ابزارها به گسترش رایجترین عبارتپردازیها گرایش دارند. اما پژوهش علت را اثبات نمیکند. زبان مشترک رشتهها و تمرکز توجه بر همان چند مقاله نیز ممکن است نقش داشته باشند؛ از این دیدگاه، هوش مصنوعی تازهترین شتابدهندهٔ همگراییای است که از پیش در جریان بوده. نویسندگان همچنین تأکید میکنند که شباهت معنایی به معنای تخلف نیست.
آنها ابزارهایی پیشنهاد میکنند که اصالت را برای نویسندگان، داوران، ویراستاران و تأمینکنندگان مالی آشکار کنند — با یک هشدار: هرگز امتیاز تمایز را به هدف تبدیل نکنید، چون عبارتپردازی غیرمعمول را بر بینش واقعی پاداش میدهد و دور زدنش آسان خواهد بود.