¿EMPIEZA LA CIENCIA A REPETIRSE?
La literatura científica no deja de crecer: alrededor de un 4 % al año, lo que la duplica aproximadamente cada 17 años, según las cifras citadas en el artículo. Una literatura más amplia podría significar una frontera de ideas más extensa. También podría significar más artículos que repiten lo ya escrito. Ilan Doron-Arad y Elchanan Mossel, matemáticos del MIT, se propusieron medir una de las caras de esta cuestión.
La originalidad tiene muchas dimensiones y ninguna medida consensuada. Pero una de ellas puede medirse ya a gran escala: la singularidad textual, es decir, cuánto de un artículo se lee como trabajos recientes. Los modelos de lenguaje modernos pueden convertir un pasaje en una lista de números que captura su significado, de modo que dos pasajes que dicen lo mismo con palabras distintas quedan cerca uno del otro.
Los autores son cuidadosos con lo que esto capta y lo que no. Un hallazgo genuinamente nuevo puede redactarse con frases familiares; una expresión insólita no es una idea nueva.
Mantener fija la comparación
Una comparación ingenua sería engañosa: a medida que crece la literatura, cualquier pasaje tiene más posibilidades de parecerse a algo. Por eso los autores mantuvieron constante el conjunto de comparación. Para cada una de ocho disciplinas —astrofísica, bioinformática, química, cambio climático, aprendizaje automático, medicina, psicología y computación cuántica— y cada año de 2015 a 2025, tomaron 300 artículos de la base de datos de acceso abierto CORE y los compararon con 3000 artículos de los cinco años anteriores. En total, unos 26 000 textos completos.
Cada artículo se dividió en pasajes solapados de 160 palabras. Una coincidencia exigía una gran similitud de significado, al menos seis términos específicos compartidos, ninguna secuencia idéntica de cinco palabras —para excluir la copia literal—, ningún autor en común y que no fueran dos versiones del mismo artículo. En un conjunto de prueba creado para ello, el detector casi no dio falsas coincidencias (99,6 % de precisión), aunque se le escaparon algunas verdaderas.
Estable, luego un fuerte aumento
Hasta 2020, la proporción del texto de un artículo que coincidía con trabajos recientes rondaba el 0,43 %. A partir de 2021 subió, hasta alcanzar el 1,34 % en 2025, 3,1 veces el nivel anterior. Una prueba estadística sitúa el inicio del aumento en 2021.
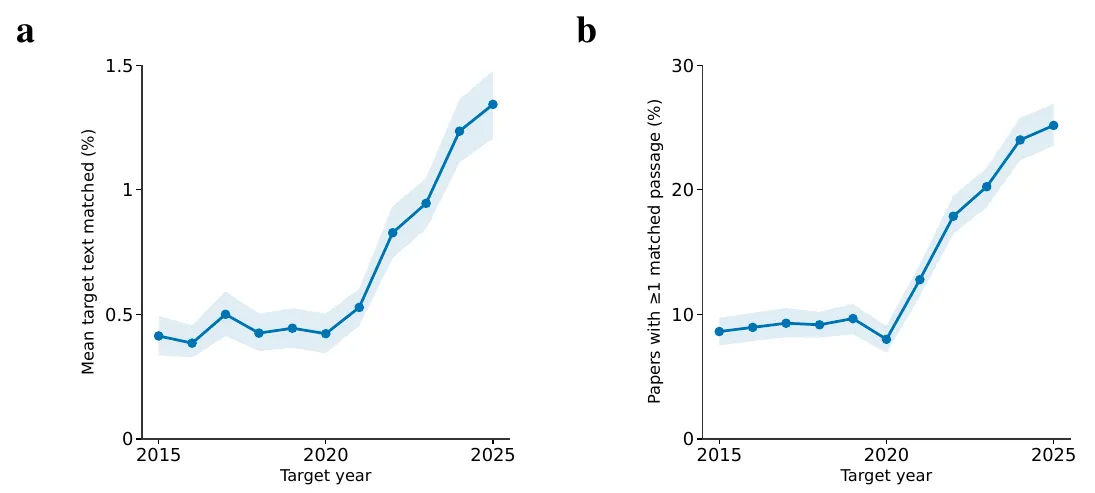
Izquierda: proporción media del texto de cada artículo que se parece a trabajos recientes. Derecha: proporción de artículos con al menos un pasaje así. — Figura 1a–b, Doron-Arad y Mossel (2026), arXiv:2609.32963.
El aumento no procede de unos pocos que toman prestado mucho. La proporción de artículos con al menos un pasaje con eco alcanzó el 25 % en 2025. Las ocho disciplinas aumentaron, a ritmos distintos.
Ecos sin citas
¿Citaban simplemente los autores el trabajo del que se hacían eco? Rara vez. Solo se encontró un vínculo de cita para el 6,4 % de los pares de artículos coincidentes, y una comprobación manual de 176 pares dio un 7 %. Entre 2015 y 2025, los pares coincidentes pasaron de 449 a 1831, pero los que tenían una cita se quedaron en 59 ambos años.
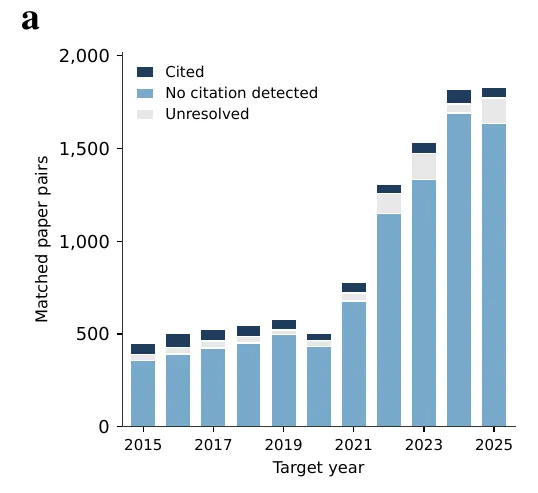
Número de pares de artículos coincidentes cada año, según la existencia de cita: casi todo el aumento corresponde a pares sin cita detectada. — Figura 3a, Doron-Arad y Mossel (2026), arXiv:2609.32963.
El equipo se preguntó también si se repiten las ideas, no solo la redacción. Modelos de IA de Anthropic resumieron cada pasaje en pocas palabras y luego juzgaron, sin ver el texto original, si dos resúmenes expresaban esencialmente la misma afirmación científica. Con una definición estricta, esos pares pasaron de una media de unos 26 al año en 2015–2020 a 139 en 2025.
El patrón resistió muchas comprobaciones —umbrales diferentes, longitudes de pasaje, eliminación de las secciones de métodos y de las fuentes más copiadas— y se reprodujo en una segunda base de datos independiente, Europe PMC, donde la proporción de texto con eco se duplicó.
Un sospechoso, no un veredicto
El mayor aumento coincide con la rápida adopción de herramientas de IA para escribir ciencia, y los autores las consideran un factor plausible, ya que tienden a difundir las formulaciones más comunes. Pero el estudio no establece la causa. El lenguaje compartido de cada disciplina y la concentración de la atención en los mismos pocos artículos también pueden influir; desde este punto de vista, la IA sería el último acelerador de una convergencia ya en marcha. Los autores subrayan también que la similitud semántica no implica una mala conducta.
Proponen herramientas que hagan visible la originalidad para autores, revisores, editores y financiadores, con una advertencia: no convertir nunca una puntuación de singularidad en un objetivo, ya que premiaría la redacción insólita por encima de las ideas reales y sería fácil de manipular.