科学は同じことを繰り返し始めたのか?
論文で引用されている数字によれば、科学文献は年に約4%ずつ増え続けており、およそ17年ごとに倍増している。文献が増えれば、アイデアのフロンティアが広がることを意味するかもしれない。しかし、すでに書かれたことを繰り返す論文が増えることを意味するかもしれない。MITの数学者イラン・ドロン=アラド(Ilan Doron-Arad)とエルハナン・モッセル(Elchanan Mossel)は、この問いの一つの側面を測定しようとした。
独創性には多くの次元があり、合意された尺度はない。しかし、そのうちの一つは今や大規模に測定できる。テキストの独自性、つまり論文のどれだけの部分が最近の研究のように読めるかである。現代の言語モデルは、ある文章をその意味をとらえた数値の列に変換できる。そのため、同じことを別の言葉で述べた2つの文章は、互いに近い位置に来る。
著者らは、この方法が何をとらえ、何をとらえないかについて慎重だ。本当に新しい発見でも、ありふれた文で書かれることはある。珍しい言い回しは、新しいアイデアではない。
比較の条件を固定する
単純な比較は誤解を招く。文献が増えるほど、どんな文章でも何かに似る機会が増えるからだ。そこで著者らは、比較対象の集合を一定に保った。天体物理学、バイオインフォマティクス、化学、気候変動、機械学習、医学、心理学、量子コンピューティングの8分野それぞれについて、2015年から2025年までの各年で、オープンアクセスのデータベースCOREから300本の論文を取り出し、その前の5年間の3000本の論文と比較した。合計で約2万6000本の全文である。
各論文は、160語ずつの重なり合う区間に切り分けられた。一致とみなすには、意味の類似度が高いこと、特定の用語を少なくとも6つ共有すること、5語の同一の連なりがないこと(単純なコピーは除外される)、共著者が共通でないこと、同じ論文の2つのバージョンでないことが必要とされた。この目的のために作られたテストセットでは、検出器は誤った一致をほとんど出さず(適合率99.6%)、一方で本物の一致の一部を見逃した。
安定、そして急上昇
2020年までは、論文の本文のうち最近の研究と一致する割合は約0.43%で推移していた。2021年からは上昇し、2025年には1.34%に達した。以前の水準の3.1倍である。統計的検定によれば、上昇の始まりは2021年に位置づけられる。
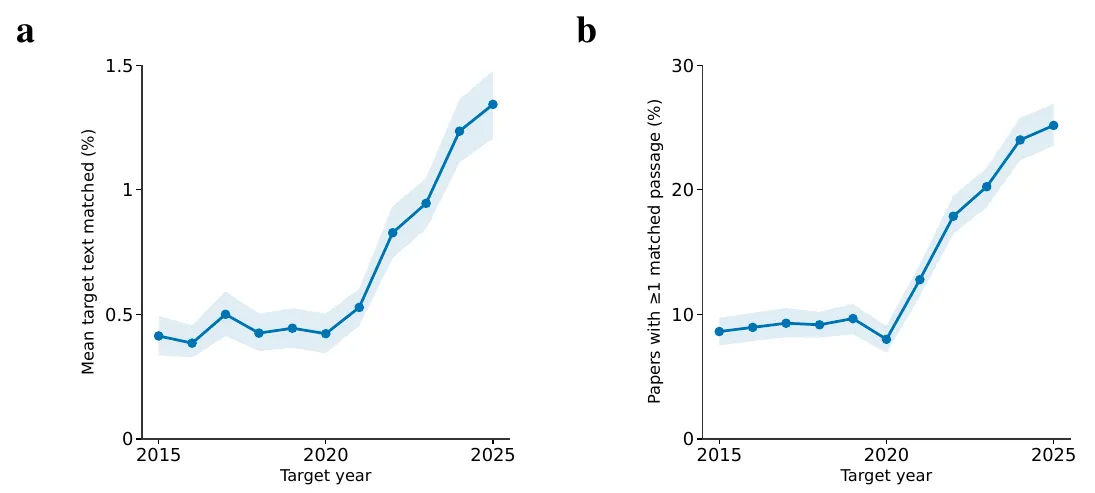
左:各論文の本文のうち最近の研究に似ている部分の平均割合。右:そうした箇所を少なくとも一つ含む論文の割合。— 図1a〜b、Doron-Arad & Mossel (2026), arXiv:2609.32963.
この増加は、大量に借用する一部の論文によるものではなかった。重なる箇所を少なくとも一つ含む論文の割合は、2025年に**25%**に達した。8つの分野すべてで、程度の差はあれ増加していた。
引用のない反響
著者たちは、自分たちが重ねている研究を単に引用していたのだろうか。それはまれだった。引用関係が見つかったのは、一致した論文ペアの6.4%にすぎず、176組を手作業で確認したところでは7%だった。2015年から2025年の間に、一致したペアは449組から1831組に増えたが、引用のあるものはどちらの年も59組のままだった。
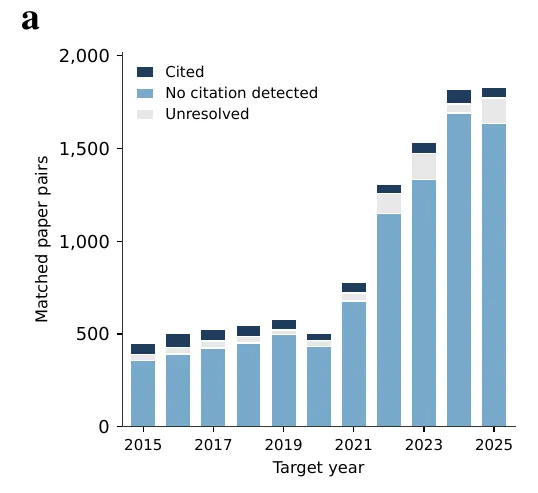
年ごとの一致した論文ペアの数を、引用の有無で分けたもの。増加のほぼすべては、引用が検出されないペアによる。— 図3a、Doron-Arad & Mossel (2026), arXiv:2609.32963.
チームはまた、言い回しだけでなくアイデアも繰り返されているのかを問うた。AnthropicのAIモデルが各箇所を数語に要約し、元の文章を見ずに、2つの要約が本質的に同じ科学的主張を表しているかどうかを判定した。厳密な定義を使うと、そうしたペアは2015〜2020年の年平均約26組から、2025年には139組に増えた。
このパターンは、多くの検証のもとで保たれた。しきい値や区間の長さを変えても、方法のセクションや最もコピーされた出典を除いても同じだった。さらに、独立した2つめのデータベースEurope PMCでも再現され、そこでは重なる本文の割合が2倍になっていた。
容疑者であって、判決ではない
最大の増加は、科学論文の執筆にAIツールが急速に取り入れられた時期と重なる。著者らは、AIツールが最もありふれた言い回しを広める傾向があることから、それがもっともらしい要因の一つだと見ている。しかし、この研究は原因を立証してはいない。分野で共有される言葉づかいや、同じ少数の論文への注目の集中も一役買っているかもしれない。この見方によれば、AIはすでに進行していた収束を加速させる最新の要因ということになる。著者らはまた、意味の類似性が不正を意味するわけではないことも強調している。
彼らは、著者、査読者、編集者、研究資金の提供者に独創性を見えるようにするツールを提案している。ただし一つの警告を添えて。独自性のスコアを決して目標にしてはならない。そうすれば、本当の洞察よりも珍しい言い回しが報われることになり、簡単に操作されてしまうからだ。