A CIÊNCIA ESTÁ COMEÇANDO A SE REPETIR?
A literatura científica não para de crescer — cerca de 4% ao ano, dobrando aproximadamente a cada 17 anos, segundo os números citados no artigo. Uma literatura maior poderia significar uma fronteira de ideias mais ampla. Também poderia significar mais artigos repetindo o que já foi escrito. Ilan Doron-Arad e Elchanan Mossel, matemáticos do MIT, decidiram medir um lado dessa questão.
A originalidade tem muitas dimensões e nenhuma medida consensual. Mas uma delas agora pode ser medida em grande escala: a distintividade textual, ou seja, quanto de um artigo soa como trabalhos recentes. Os modelos de linguagem modernos conseguem transformar uma passagem numa lista de números que captura seu significado, de modo que duas passagens que dizem a mesma coisa com palavras diferentes acabam próximas uma da outra.
Os autores tomam cuidado com o que isso capta e o que não capta. Uma descoberta genuinamente nova pode ser escrita com frases conhecidas; uma expressão incomum não é uma ideia nova.
Mantendo a comparação fixa
Uma comparação ingênua enganaria: à medida que a literatura cresce, qualquer passagem tem mais chances de se parecer com alguma coisa. Por isso os autores mantiveram constante o conjunto de comparação. Para cada uma de oito áreas — astrofísica, bioinformática, química, mudança climática, aprendizado de máquina, medicina, psicologia e computação quântica — e cada ano de 2015 a 2025, eles pegaram 300 artigos da base de acesso aberto CORE e os compararam com 3.000 artigos dos cinco anos anteriores. No total, cerca de 26.000 textos completos.
Cada artigo foi dividido em passagens sobrepostas de 160 palavras. Uma correspondência exigia alta semelhança de significado, pelo menos seis termos específicos em comum, nenhuma sequência idêntica de cinco palavras — o que exclui a simples cópia —, nenhum autor em comum e não se tratar de duas versões do mesmo artigo. Num conjunto de teste construído para isso, o detector quase não produziu falsas correspondências (precisão de 99,6%), embora tenha deixado escapar algumas verdadeiras.
Estável, e depois uma alta acentuada
Até 2020, a parte do texto de um artigo que correspondia a trabalhos recentes girava em torno de 0,43%. A partir de 2021 ela subiu, chegando a 1,34% em 2025 — 3,1 vezes o nível anterior. Um teste estatístico situa o início da alta em 2021.
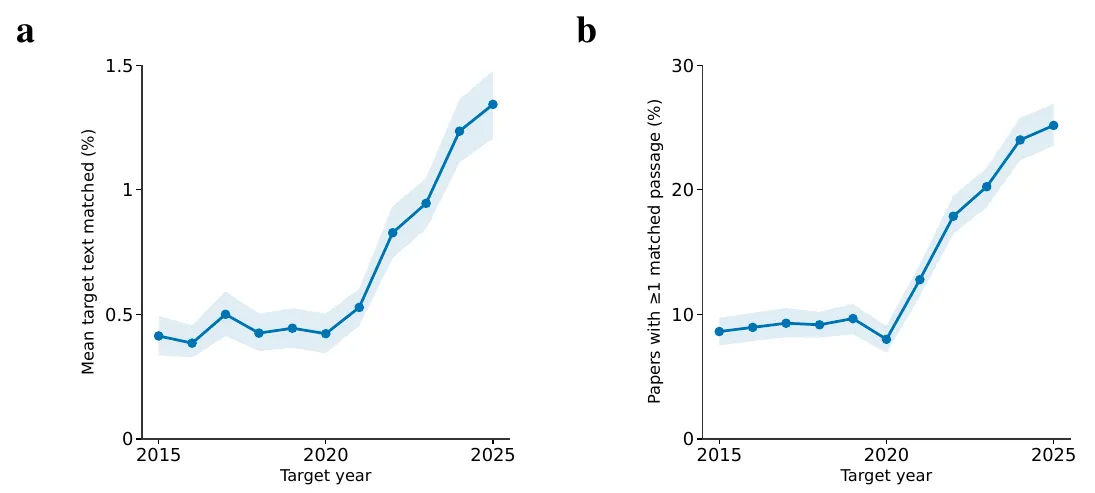
À esquerda: parte média do texto de cada artigo que se assemelha a trabalhos recentes. À direita: parte dos artigos com pelo menos uma passagem assim. — Figura 1a–b, Doron-Arad & Mossel (2026), arXiv:2609.32963.
A alta não veio de alguns poucos grandes copiadores. A parte dos artigos com pelo menos uma passagem que ecoa outro trabalho chegou a 25% em 2025. As oito áreas aumentaram, em ritmos diferentes.
Ecos sem citações
Os autores simplesmente citaram os trabalhos que ecoam? Raramente. Foi possível encontrar um vínculo de citação em apenas 6,4% dos pares de artigos correspondentes, e uma verificação manual de 176 pares deu 7%. Entre 2015 e 2025, os pares correspondentes passaram de 449 para 1.831 — mas os que tinham citação ficaram em 59 nos dois anos.
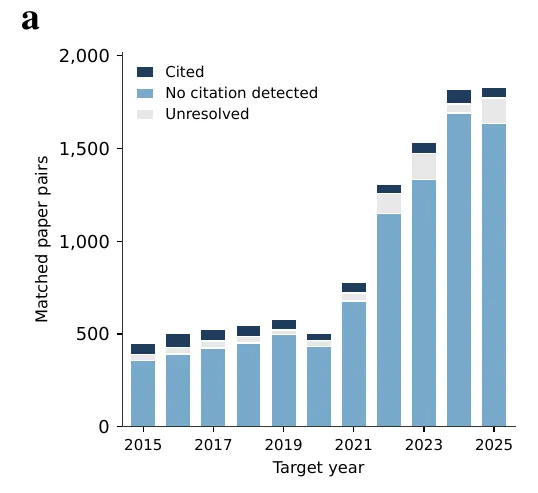
Número de pares de artigos correspondentes por ano, segundo a situação de citação: quase todo o crescimento está nos pares sem citação detectada. — Figura 3a, Doron-Arad & Mossel (2026), arXiv:2609.32963.
A equipe também perguntou se as ideias se repetem, e não só a redação. Modelos de IA da Anthropic resumiram cada passagem em poucas palavras e depois julgaram, sem ver o texto original, se dois resumos expressavam essencialmente a mesma afirmação científica. Com uma definição estrita, esses pares passaram de uma média de cerca de 26 por ano em 2015–2020 para 139 em 2025.
O padrão resistiu a muitas verificações — limiares diferentes, tamanhos de passagem, remoção das seções de métodos e das fontes mais copiadas — e se repetiu numa segunda base de dados independente, a Europe PMC, onde a parte de texto que ecoa outros trabalhos dobrou.
Um suspeito, não um veredito
O maior aumento coincide com a rápida adoção de ferramentas de IA para escrever ciência, e os autores as veem como um fator plausível, já que elas tendem a espalhar as formulações mais comuns. Mas o estudo não estabelece a causa. A linguagem compartilhada de cada disciplina e o estreitamento da atenção para os mesmos poucos artigos também podem ter um papel; nessa visão, a IA seria o acelerador mais recente de uma convergência que já estava em curso. Os autores ressaltam ainda que semelhança semântica não implica má conduta.
Eles sugerem ferramentas que tornem a originalidade visível para autores, revisores, editores e financiadores — com um alerta: nunca fazer de uma pontuação de distintividade uma meta, pois ela recompensaria a redação incomum em vez da percepção real, e seria fácil de burlar.