APAKAH SAINS MULAI MENGULANG DIRINYA?
Literatur ilmiah terus bertambah — sekitar 4% per tahun, berlipat dua kira-kira setiap 17 tahun, menurut angka yang dikutip dalam makalah ini. Literatur yang lebih besar bisa berarti garis depan gagasan yang lebih luas. Bisa juga berarti lebih banyak makalah yang mengulang apa yang sudah ditulis. Ilan Doron-Arad dan Elchanan Mossel, matematikawan di MIT, berupaya mengukur satu sisi dari pertanyaan itu.
Orisinalitas punya banyak dimensi dan tak ada ukuran yang disepakati. Namun salah satunya kini bisa diukur dalam skala besar: kekhasan tekstual, yaitu seberapa banyak isi sebuah makalah terdengar seperti karya terbaru. Model bahasa modern dapat mengubah sebuah bagian teks menjadi deretan angka yang menangkap maknanya, sehingga dua bagian yang mengatakan hal sama dengan kata-kata berbeda akan berdekatan.
Para penulis berhati-hati tentang apa yang ditangkap dan tidak ditangkap oleh metode ini. Temuan yang benar-benar baru bisa ditulis dengan kalimat yang akrab; ungkapan yang tidak biasa bukanlah gagasan baru.
Menjaga pembanding tetap sama
Perbandingan yang naif akan menyesatkan: seiring bertambahnya literatur, setiap bagian teks punya lebih banyak peluang untuk mirip dengan sesuatu. Karena itu para penulis menjaga kumpulan pembanding tetap konstan. Untuk masing-masing dari delapan bidang — astrofisika, bioinformatika, kimia, perubahan iklim, pembelajaran mesin, kedokteran, psikologi, dan komputasi kuantum — dan setiap tahun dari 2015 hingga 2025, mereka mengambil 300 makalah dari basis data akses terbuka CORE dan membandingkannya dengan 3.000 makalah dari lima tahun sebelumnya. Totalnya sekitar 26.000 teks lengkap.
Setiap makalah dipotong menjadi bagian-bagian 160 kata yang saling tumpang tindih. Sebuah kecocokan mensyaratkan kemiripan makna yang tinggi, setidaknya enam istilah spesifik yang sama, tidak ada rangkaian lima kata yang identik — sehingga penyalinan biasa dikecualikan — tidak ada penulis yang sama, dan bukan dua versi dari makalah yang sama. Pada set uji yang dibuat khusus, detektor ini hampir tidak menghasilkan kecocokan palsu (presisi 99,6%), meski melewatkan sebagian kecocokan yang benar.
Stabil, lalu melonjak tajam
Hingga 2020, porsi teks makalah yang cocok dengan karya terbaru berkisar sekitar 0,43%. Sejak 2021 angkanya naik, mencapai 1,34% pada 2025 — 3,1 kali level sebelumnya. Sebuah uji statistik menempatkan awal kenaikan pada 2021.
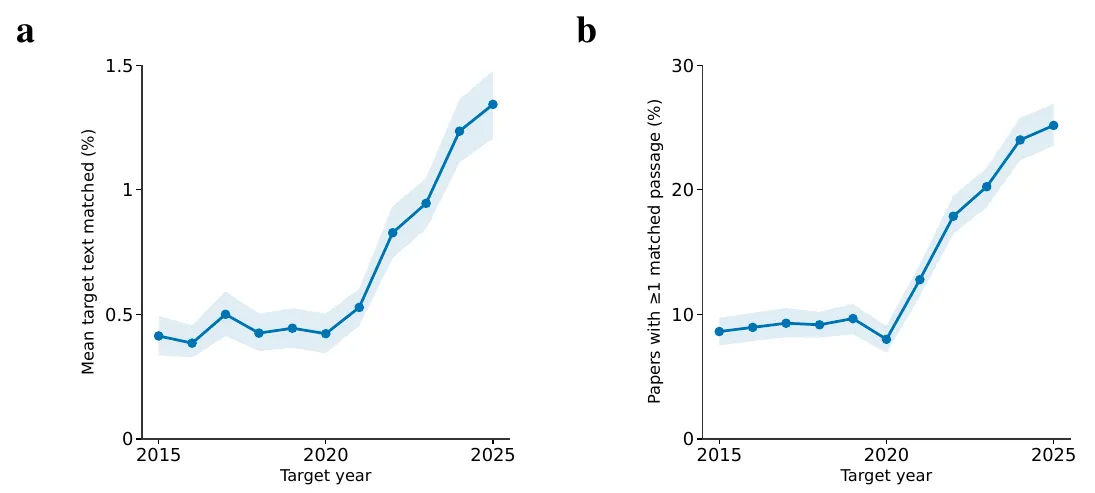
Kiri: rata-rata porsi teks setiap makalah yang mirip dengan karya terbaru. Kanan: porsi makalah dengan setidaknya satu bagian semacam itu. — Gambar 1a–b, Doron-Arad & Mossel (2026), arXiv:2609.32963.
Kenaikan ini tidak berasal dari segelintir peminjam berat. Porsi makalah yang memuat setidaknya satu bagian yang menggema mencapai 25% pada 2025. Kedelapan bidang semuanya naik, dengan laju berbeda.
Gema tanpa kutipan
Apakah para penulis sekadar mengutip karya yang mereka gemakan? Jarang. Tautan kutipan hanya ditemukan pada 6,4% pasangan makalah yang cocok, dan pemeriksaan manual atas 176 pasangan menghasilkan 7%. Antara 2015 dan 2025, pasangan yang cocok bertambah dari 449 menjadi 1.831 — tetapi yang disertai kutipan tetap 59 pada kedua tahun itu.
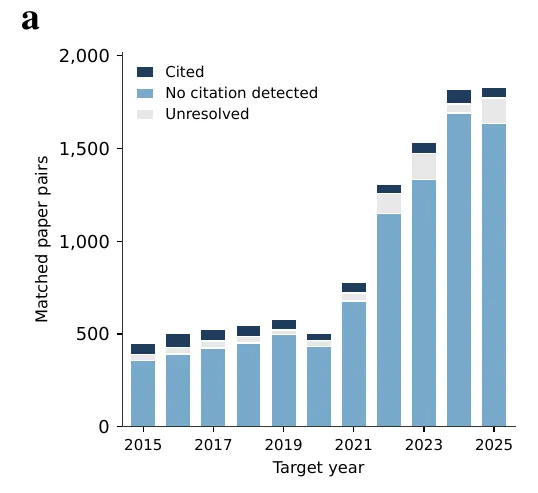
Jumlah pasangan makalah yang cocok setiap tahun, menurut status kutipan: hampir seluruh pertumbuhan ada pada pasangan tanpa kutipan yang terdeteksi. — Gambar 3a, Doron-Arad & Mossel (2026), arXiv:2609.32963.
Tim juga menelusuri apakah gagasannya yang berulang, bukan sekadar susunan katanya. Model AI dari Anthropic merangkum setiap bagian dalam beberapa kata, lalu menilai, tanpa melihat teks aslinya, apakah dua rangkuman pada dasarnya menyatakan klaim ilmiah yang sama. Dengan definisi yang ketat, pasangan semacam itu naik dari rata-rata sekitar 26 per tahun pada 2015–2020 menjadi 139 pada 2025.
Pola ini bertahan dalam banyak pengujian — ambang yang berbeda, panjang bagian, penghapusan bagian metode dan sumber yang paling banyak disalin — dan terulang di basis data kedua yang independen, Europe PMC, tempat porsi teks yang menggema berlipat dua.
Tersangka, bukan vonis
Kenaikan terbesar bertepatan dengan cepatnya adopsi alat AI untuk menulis karya ilmiah, dan para penulis melihatnya sebagai penyumbang yang masuk akal, karena alat-alat itu cenderung menyebarkan susunan kata yang paling umum. Namun studi ini tidak memastikan penyebabnya. Bahasa bersama dalam disiplin ilmu dan menyempitnya perhatian pada segelintir makalah yang sama juga bisa berperan; dalam pandangan ini, AI adalah pemercepat terbaru dari penyeragaman yang sudah berlangsung. Para penulis juga menegaskan bahwa kemiripan semantik tidak berarti pelanggaran etika.
Mereka mengusulkan alat yang membuat orisinalitas terlihat oleh penulis, penelaah, editor, dan penyandang dana — dengan satu peringatan: jangan pernah menjadikan skor kekhasan sebagai target, karena skor itu akan menghargai susunan kata yang tidak biasa alih-alih wawasan sejati, dan mudah diakali.