بختآزمایی داوری علمی
علم بر داوری همتا استوار است: پیش از انتشار یک نتیجه، متخصصان دیگر دربارهٔ آن داوری میکنند. در همایشهای بزرگ یادگیری ماشین، چند داور به هر مقالهٔ ارسالی امتیاز میدهند و مقاله پذیرفته یا رد میشود. پشت این آیین پرسشی ناخوشایند نهفته است. اگر همان مقاله را برای داوران دیگری بفرستید، آیا رأی همان میماند؟
دو آزمایش پرهزینه
تنها پاسخهای مستقیم از دو آزمایش میآیند که در آنها یک همایش برخی مقالهها را با دو کمیتهٔ مستقل دو بار داوری کرد. مقاله نتایج آنها را یادآوری میکند:
- NeurIPS 2014: از 166 مقالهٔ دوبار داوریشده، دو کمیته بر سر 43 مقاله اختلاف داشتند — 25.9 درصد. حدود نیمی از مقالههایی که یک کمیته پذیرفت، کمیتهٔ دیگر رد میکرد.
- NeurIPS 2021: در 882 مقاله، کمیتهها در 23.0 درصد موارد اختلاف داشتند.
چنین آزمایشهایی نادرند چون پرهزینهاند: یعنی دو برابر کردن داوری صدها مقاله. فیلیان هوانگ، پژوهشگری مستقل، پرسید آیا میتوان همین عدد را تنها از دادههای عمومی برآورد کرد.
شبیهسازی یک کمیتهٔ دوم
این پژوهش از داوریهای عمومی همایش ICLR از 2017 تا 2025 استفاده میکند: 36,113 مقاله و 134,912 داوری. یک مدل آماری هر امتیاز را به دو بخش تقسیم میکند: کیفیت پنهان مقاله، و «نوفهای» که هر داور میافزاید. مدل دومی بازتولید میکند که امتیازها چگونه به تصمیم تبدیل میشوند. سپس رایانه برای هر مقاله دو کمیتهٔ مستقل دو، سه یا چهارنفره را هزار بار تصور میکند و میشمارد چند بار با هم اختلاف دارند.
پیش از اعتماد به نتیجه، نویسنده آن را دو بار آزمود. در مقایسه با آزمایش NeurIPS 2021، با سه داور برای هر مقاله مانند آنجا، شبیهسازی 23.3 درصد اختلاف به دست میدهد در برابر 23.0 درصد اندازهگیریشده. و در مقالههای ICLR با دستکم چهار داوری، صرفاً تقسیم داوران واقعی به دو جفت تصادفی، در 2018 و در هر سال از 2021 تا 2025، همان پاسخ مدل را با اختلافی کمتر از یک واحد میدهد.
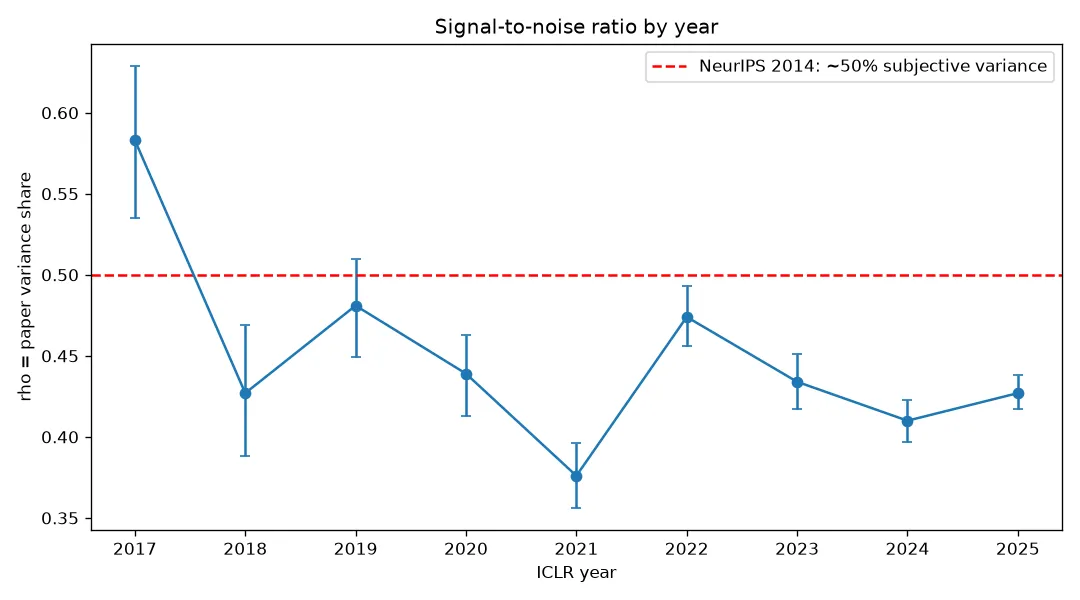
سهمی از واریانس امتیازها که از خود مقاله میآید، سال به سال: حدود نیمی؛ بقیه نوفهٔ داوران است. — شکل 2، Huang (2026)، arXiv:2610.06591.
تقریباً یک مقاله از هر چهار
سهمی از تغییرپذیری امتیازها که از خود مقاله میآید، بسته به سال از 0.38 تا 0.58 است — بقیه نوفهٔ داوران است، همراستا با برآورد 2014 که حدود نیمی بود. پیامدها:
- با دو داور در هر کمیته، رأی برای 22.8 درصد (2017) تا 30.3 درصد (2025) مقالهها برمیگردد. با چهار داور، 17.7 تا 24.2 درصد.
- 30 تا 50 درصد مقالههای پذیرفتهشده را یک کمیتهٔ مستقل رد میکرد — تا نیمی از آنها در 2021.
- در طول نُه سالی که تعداد مقالههای ارسالی حدود 24 برابر شد (489 در 2017، 11,663 در 2025)، پژوهش هیچ روند استواری نمییابد: نوفه نه آشکارا افزایش مییابد و نه کاهش. نویسنده تأکید میکند که با تنها نُه سال داده، این شاهدی علیه یک روند قوی است، نه اثبات ثبات.
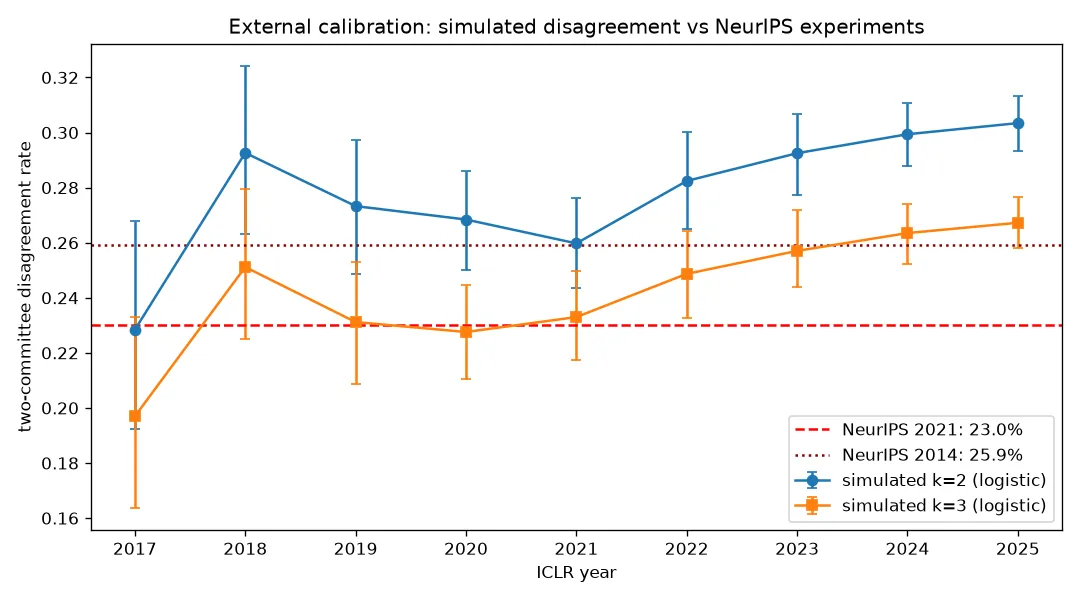
اختلاف شبیهسازیشده میان دو کمیته، در مقایسه با دو آزمایش واقعی NeurIPS. — شکل 3، Huang (2026)، arXiv:2610.06591.
خود مقیاس شانس میافزاید
دو سال متمایزند. در 2020، ICLR از مقیاس امتیازدهی درشت و چهاردرجهای (1، 3، 6، 8) استفاده کرد: 23.7 درصد مقالهها از همهٔ داورانشان امتیاز یکسان گرفتند، در برابر 4.7 تا 13.1 درصد در سالهای دیگر. برای آزمودن این اثر، نویسنده امتیازهای 2021 را که از 10 داده شده بودند برداشت و آنها را روی مقیاس چهاردرجهای بازکدگذاری کرد. نتیجه: حدود 8 درصد سیگنال از دست میرود، اختلاف میان کمیتهها حدود 7 واحد افزایش مییابد، و سهم مقالههای پذیرفتهشدهای که رأیشان برمیگردد حدود 11 واحد بالا میرود. مقیاس درشت فقط به همان نظرها برچسب تازه نمیزند؛ شانس میافزاید.
2021 فرق دارد: مقیاسی ریز، اما ضعیفترین سیگنال نُه سال، و 30.4 درصد مقالههای پذیرفتهشده درست کمی بالای آستانهٔ پذیرش قرار داشتند. مقالههای فراوان نزدیک خط، نوفهٔ فراوان: برگشتهای آسان.
و چتباتها؟
پژوهش قصد داشت پس از 2023، که مدلهای زبانی گسترش یافتند، به دنبال تغییری در رفتار داوری بگردد. دادههای عمومی پس از 2022 نه متن داوری را دارند و نه میزان اطمینان داور را، و آزمون آماری موجود تقریباً هیچ توانی ندارد. بنابراین نویسنده در هیچ جهتی نتیجهای نمیگیرد — و این خویشتنداری را آگاهانه معرفی میکند.
حسابرسی بختآزمایی
این روش فقط به امتیازها و تصمیمها نیاز دارد که چندین همایش هماکنون منتشر میکنند. هر کدام از آنها میتواند نرخ «بختآزمایی» خود را بیآنکه حتی یک داوری را تکرار کند حساب کند. حکم نویسنده دربارهٔ نُه سال ICLR: داوری نه در حال فروپاشی است و نه در حال بهبود — تقریباً در همان سطح پرنوفه باقی میماند. این پژوهش تنها ICLR را پوشش میدهد و نویسندهاش یک پژوهشگر مستقل است.