HAKEM DEĞERLENDİRMESİ PİYANGOSU
Bilim hakem değerlendirmesiyle işler: bir sonuç yayımlanmadan önce başka uzmanlar onu yargılar. Büyük makine öğrenmesi konferanslarında birkaç hakem her başvuruyu puanlar ve makale kabul ya da reddedilir. Bu ritüelin ardında rahatsız edici bir soru yatıyor. Aynı makaleyi başka hakemlere gönderseniz, karar aynı olur muydu?
İki pahalı deney
Doğrudan yanıtlar yalnızca, bir konferansın bazı makaleleri iki bağımsız kurulla iki kez değerlendirdiği iki deneyden geliyor. Makale sonuçlarını hatırlatıyor:
- NeurIPS 2014: iki kez değerlendirilen 166 makalenin 43’ünde iki kurul anlaşamadı — yüzde 25,9. Bir kurulun kabul ettiği makalelerin yaklaşık yarısı diğeri tarafından reddedilmiş olurdu.
- NeurIPS 2021: 882 makalede kurullar yüzde 23,0 oranında anlaşamadı.
Bu tür deneyler pahalı olduğu için nadirdir: yüzlerce makalenin değerlendirmesini ikiye katlamak anlamına gelir. Bağımsız araştırmacı Feilian Huang, aynı sayının yalnızca kamuya açık verilerden tahmin edilip edilemeyeceğini sordu.
İkinci bir kurulu simüle etmek
Çalışma, ICLR konferansının 2017-2025 arasındaki kamuya açık değerlendirmelerini kullanıyor: 36.113 makale ve 134.912 değerlendirme. İstatistiksel bir model her puanı iki parçaya ayırıyor: makalenin gizli kalitesi ve her hakemin eklediği “gürültü”. İkinci bir model, puanların nasıl karara dönüştüğünü yeniden üretiyor. Ardından bilgisayar, her makale için iki, üç ya da dört hakemden oluşan iki bağımsız kurulu bin kez hayal ediyor ve ne sıklıkla anlaşamadıklarını sayıyor.
Sonuca güvenmeden önce yazar onu iki kez sınadı. NeurIPS 2021 deneyiyle, oradaki gibi makale başına üç hakemle karşılaştırıldığında, simülasyon ölçülen yüzde 23,0’a karşı yüzde 23,3 uyuşmazlık veriyor. Ve en az dört değerlendirmesi olan ICLR makalelerinde, gerçek hakemleri yalnızca rastgele iki çifte ayırmak, 2018’de ve 2021’den 2025’e kadar her yıl, modelle bir puan farkla aynı yanıtı veriyor.
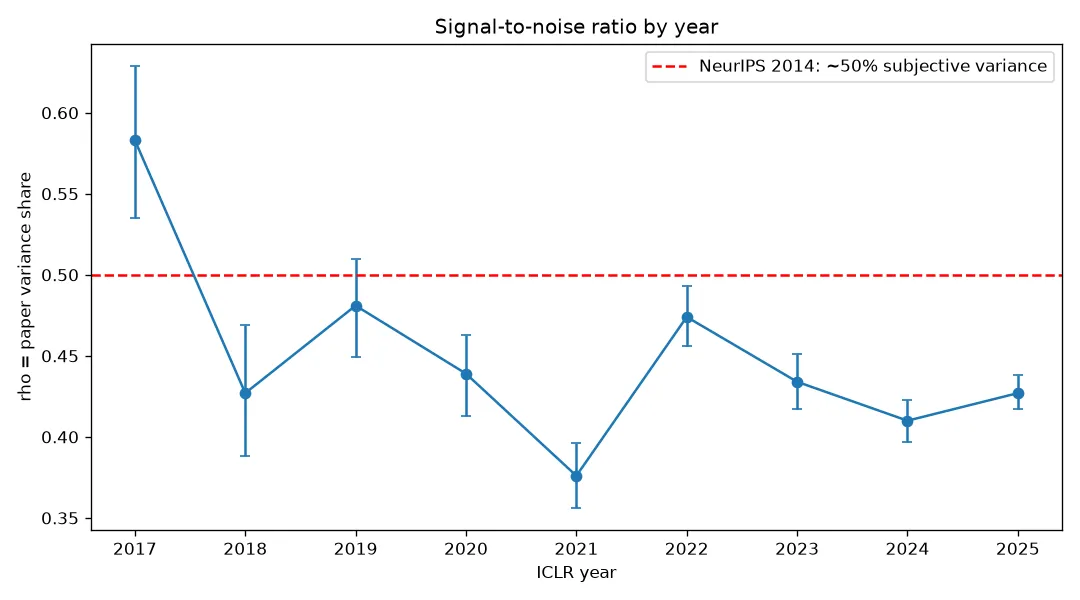
Puan varyansının makalenin kendisinden kaynaklanan payı, yıl yıl: yaklaşık yarısı; geri kalanı hakem gürültüsü. — Şekil 2, Huang (2026), arXiv:2610.06591.
Yaklaşık dört makaleden biri
Puan değişkenliğinin makalenin kendisinden gelen payı yıla göre 0,38 ile 0,58 arasında değişiyor — geri kalanı hakem gürültüsü; bu, 2014’teki yaklaşık yarı tahminiyle uyumlu. Sonuçları:
- Kurul başına iki hakemle, makalelerin yüzde 22,8’inde (2017) ile yüzde 30,3’ünde (2025) karar tersine dönüyor. Dört hakemle, yüzde 17,7 ila 24,2.
- Kabul edilen makalelerin yüzde 30 ila 50’si bağımsız bir kurul tarafından reddedilmiş olurdu — 2021’de yarısına kadar.
- Başvuruların yaklaşık 24 kat arttığı dokuz yıl boyunca (2017’de 489, 2025’te 11.663) çalışma sağlam bir eğilim bulmuyor: gürültü ne belirgin biçimde artıyor ne de azalıyor. Yazar, yalnızca dokuz yıllık veriyle bunun istikrarın kanıtı değil, güçlü bir eğilime karşı bir kanıt olduğunu vurguluyor.
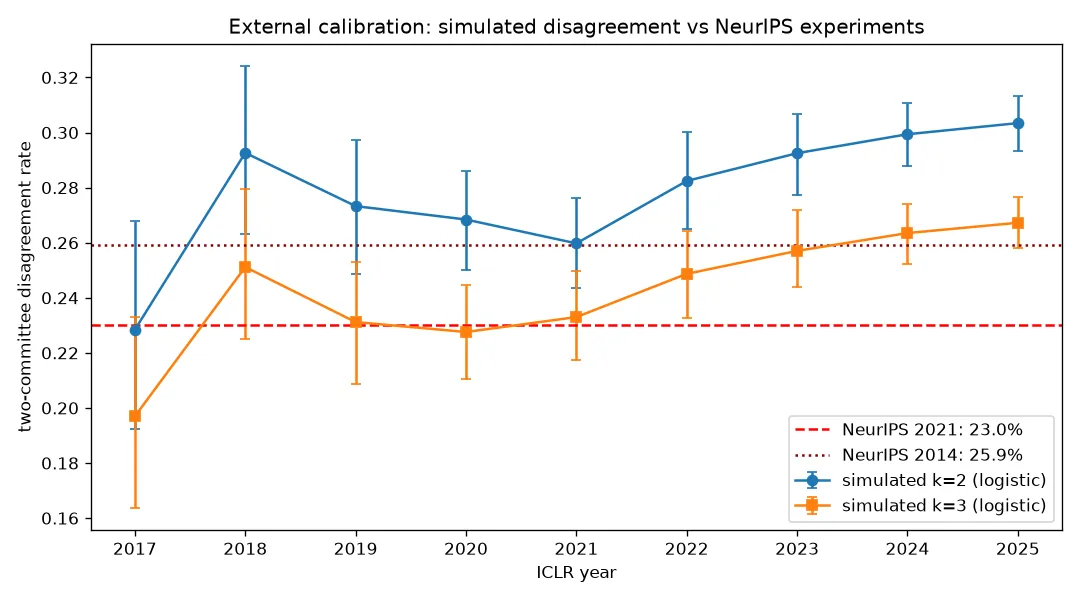
İki kurul arasındaki simüle edilmiş uyuşmazlık, iki gerçek NeurIPS deneyiyle karşılaştırmalı. — Şekil 3, Huang (2026), arXiv:2610.06591.
Ölçeğin kendisi şans ekliyor
İki yıl öne çıkıyor. 2020’de ICLR kaba, dört basamaklı bir puanlama ölçeği (1, 3, 6, 8) kullandı: diğer yıllardaki yüzde 4,7 ila 13,1’e karşı makalelerin yüzde 23,7’si tüm hakemlerinden aynı puanı aldı. Etkiyi sınamak için yazar, 10 üzerinden verilmiş 2021 puanlarını alıp dört basamaklı ölçeğe göre yeniden kodladı. Sonuç: sinyalin yaklaşık yüzde 8’i kayboluyor, kurullar arasındaki uyuşmazlık yaklaşık 7 puan artıyor ve kabul edilen makalelerden kararı tersine dönecek olanların payı yaklaşık 11 puan yükseliyor. Kaba bir ölçek aynı görüşleri yalnızca yeniden etiketlemiyor; şans ekliyor.
2021 ise farklı: ince bir ölçek, ama dokuz yılın en zayıf sinyali; kabul edilen makalelerin yüzde 30,4’ü kabul eşiğinin hemen üstündeydi. Çizgiye yakın çok sayıda makale, bol gürültü: kolay tersine dönüşler.
Ya sohbet botları?
Çalışma, dil modellerinin yaygınlaştığı 2023’ten sonra değerlendirme davranışında bir değişim aramayı planlamıştı. Kamuya açık veriler 2022’den sonrası için ne değerlendirme metnini ne de hakem güven düzeyini içeriyor ve mevcut istatistiksel testin gücü neredeyse yok. Bu yüzden yazar iki yönde de bir sonuç çıkarmıyor — ve bu temkini bilinçli bir tercih olarak sunuyor.
Piyangoyu denetlemek
Yöntem yalnızca puanlara ve kararlara ihtiyaç duyuyor; birçok konferans bunları zaten yayımlıyor. Bunlardan herhangi biri, tek bir değerlendirmeyi bile çoğaltmadan kendi “piyango” oranını hesaplayabilir. Yazarın ICLR’nin dokuz yılına dair hükmü: değerlendirme ne çöküyor ne de iyileşiyor — aşağı yukarı aynı düzeyde gürültülü kalıyor. Çalışma yalnızca ICLR’yi kapsıyor ve yazarı tek bir bağımsız araştırmacı.