LA LOTERÍA DE LA REVISIÓN POR PARES
La ciencia funciona con la revisión por pares: antes de que se publique un resultado, otros expertos lo juzgan. En los grandes congresos de aprendizaje automático, un puñado de revisores puntúa cada envío y el artículo se acepta o se rechaza. Detrás de este ritual hay una pregunta incómoda. Si se enviara el mismo artículo a otros revisores, ¿sería el mismo el veredicto?
Dos experimentos caros
Las únicas respuestas directas proceden de dos experimentos en los que un congreso revisó algunos artículos dos veces, con dos comités independientes. El artículo recuerda sus resultados:
- NeurIPS 2014: de 166 artículos revisados por partida doble, los dos comités discreparon en 43, un 25,9 %. Aproximadamente la mitad de los artículos aceptados por un comité habrían sido rechazados por el otro.
- NeurIPS 2021: sobre 882 artículos, los comités discreparon en un 23,0 %.
Estos experimentos son raros porque son caros: suponen duplicar la revisión de cientos de artículos. Feilian Huang, investigador independiente, se preguntó si podía estimarse esa misma cifra solo a partir de datos públicos.
Simular un segundo comité
El estudio utiliza las revisiones públicas del congreso ICLR de 2017 a 2025: 36.113 artículos y 134.912 revisiones. Un modelo estadístico divide cada puntuación en dos partes: la calidad oculta del artículo y el «ruido» que añade cada revisor. Un segundo modelo reproduce cómo las puntuaciones se convierten en decisiones. Después, el ordenador imagina para cada artículo dos comités independientes de dos, tres o cuatro revisores, mil veces, y cuenta con qué frecuencia discrepan.
Antes de fiarse del resultado, el autor lo comprobó dos veces. Frente al experimento de NeurIPS 2021, con tres revisores por artículo como allí, la simulación da un 23,3 % de desacuerdo frente al 23,0 % medido. Y en los artículos de ICLR con al menos cuatro revisiones, simplemente dividir a los revisores reales en dos parejas al azar da la misma respuesta que el modelo, con un margen de un punto, en 2018 y en todos los años de 2021 a 2025.
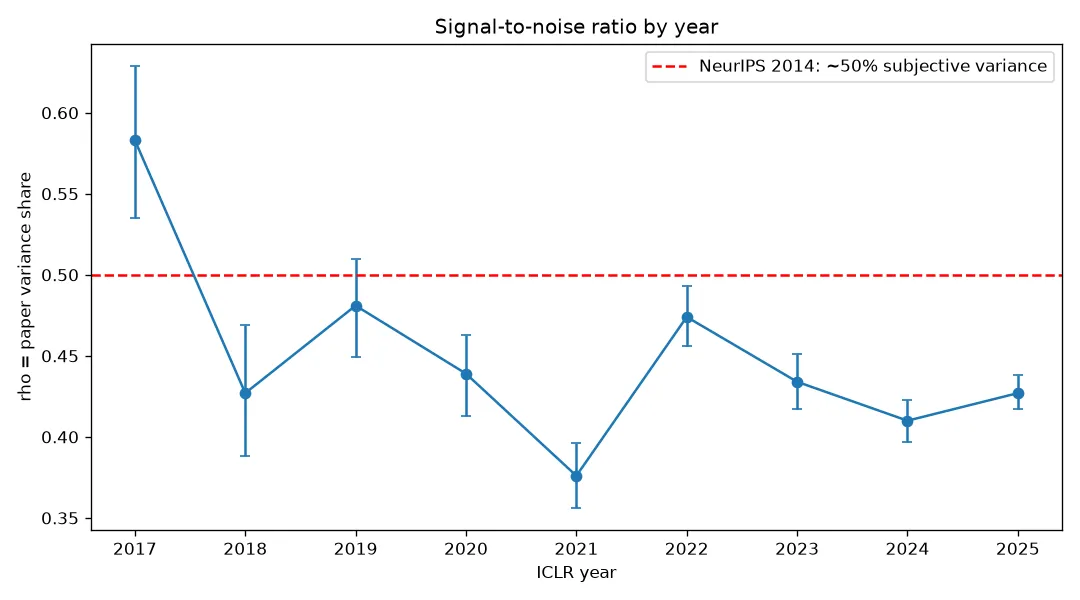
Proporción de la varianza de las puntuaciones debida al propio artículo, año a año: en torno a la mitad; el resto es ruido de los revisores. — Figura 2, Huang (2026), arXiv:2610.06591.
Aproximadamente un artículo de cada cuatro
La proporción de la variación de las puntuaciones que procede del propio artículo va de 0,38 a 0,58 según el año; el resto es ruido de los revisores, en línea con la estimación de 2014 de aproximadamente la mitad. Las consecuencias:
- Con dos revisores por comité, la decisión se invierte para entre el 22,8 % (2017) y el 30,3 % (2025) de los artículos. Con cuatro revisores, entre el 17,7 y el 24,2 %.
- Entre el 30 y el 50 % de los artículos aceptados habrían sido rechazados por un comité independiente, hasta la mitad en 2021.
- A lo largo de nueve años en los que los envíos se multiplicaron por unos 24 (489 en 2017, 11.663 en 2025), el estudio no encuentra ninguna tendencia robusta: el ruido ni crece ni disminuye claramente. El autor subraya que, con solo nueve años de datos, esto es una prueba en contra de una tendencia fuerte, no una prueba de estabilidad.
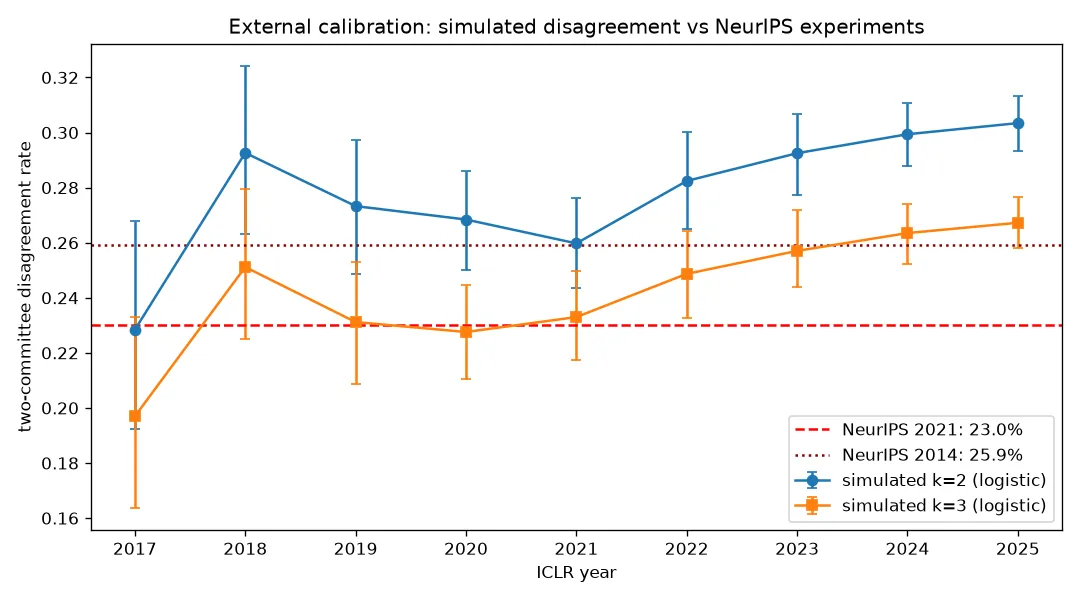
Desacuerdo simulado entre dos comités, comparado con los dos experimentos reales de NeurIPS. — Figura 3, Huang (2026), arXiv:2610.06591.
La propia escala añade azar
Dos años destacan. En 2020, ICLR usó una escala de puntuación tosca de cuatro niveles (1, 3, 6, 8): el 23,7 % de los artículos recibieron puntuaciones idénticas de todos sus revisores, frente al 4,7 a 13,1 % de los demás años. Para comprobar el efecto, el autor tomó las puntuaciones de 2021, dadas sobre 10, y las recodificó en la escala de cuatro niveles. Resultado: se pierde alrededor del 8 % de la señal, el desacuerdo entre comités sube unos 7 puntos y la proporción de artículos aceptados que cambiarían de decisión sube unos 11 puntos. Una escala tosca no se limita a reetiquetar las mismas opiniones: añade azar.
2021 es distinto: una escala fina, pero la señal más débil de los nueve años, y el 30,4 % de los artículos aceptados quedaron justo por encima del umbral de aceptación. Muchos artículos cerca de la línea, mucho ruido: decisiones que se invierten con facilidad.
¿Y los chatbots?
El estudio preveía buscar un cambio en el comportamiento de los revisores después de 2023, cuando se extendieron los modelos de lenguaje. Los datos públicos no contienen el texto de las revisiones ni la confianza de los revisores después de 2022, y la prueba estadística disponible casi no tiene potencia. Por eso el autor no saca ninguna conclusión en ningún sentido, y presenta esa prudencia como deliberada.
Auditar la lotería
El método solo necesita puntuaciones y decisiones, que varios congresos ya publican. Cualquiera de ellos podría calcular su propia tasa de «lotería» sin duplicar ni una sola revisión. El veredicto del autor sobre nueve años de ICLR: la revisión ni se hunde ni mejora; sigue igual de ruidosa, más o menos al mismo nivel. El estudio solo abarca ICLR, y su autor es un único investigador independiente.