査読という名のくじ引き
科学は査読(ピアレビュー)の上に成り立っている。ある成果が発表される前に、ほかの専門家がそれを評価するのだ。機械学習の大きな国際会議では、一握りの査読者がそれぞれの投稿を採点し、論文は採択か不採択かが決まる。この儀式の裏には、居心地の悪い問いが潜んでいる。同じ論文を別の査読者に送ったら、判定は同じになるだろうか。
二つの高くつく実験
直接の答えは、ある会議が一部の論文を、二つの独立した委員会で2回査読した二つの実験からしか得られていない。論文はその結果を振り返る。
- NeurIPS 2014:2回査読された166本の論文のうち、二つの委員会の判断は43本で食い違った。25.9%だ。一方の委員会が採択した論文のおよそ半分は、もう一方では不採択になっていたはずだった。
- NeurIPS 2021:882本の論文で、委員会の判断は23.0%で食い違った。
こうした実験が珍しいのは、費用がかかるからだ。何百本もの論文の査読を2倍にすることを意味する。独立研究者のフェイリエン・ホアン(Feilian Huang)は、同じ数値を公開データだけから推定できないかと考えた。
二つ目の委員会をシミュレーションする
研究は、2017年から2025年までのICLR会議の公開査読を使う。36,113本の論文と134,912件の査読だ。ある統計モデルが、各スコアを二つの部分に分ける。論文の隠れた質と、各査読者が加える「ノイズ」だ。二つ目のモデルは、スコアがどのように判定に変わるかを再現する。そしてコンピューターが、各論文について2人、3人、または4人の査読者からなる二つの独立した委員会を千回にわたって想定し、それらの判断がどれほどの頻度で食い違うかを数える。
結果を信用する前に、著者はそれを二重に確かめた。NeurIPS 2021の実験と比べると、そこと同じく論文あたり3人の査読者で、シミュレーションは測定値23.0%に対して**23.3%**の不一致を出す。また、査読が4件以上あるICLRの論文では、実際の査読者を無作為に二つのペアに分けるだけで、2018年と、2021年から2025年までのすべての年で、モデルと1ポイント以内の同じ答えが得られる。
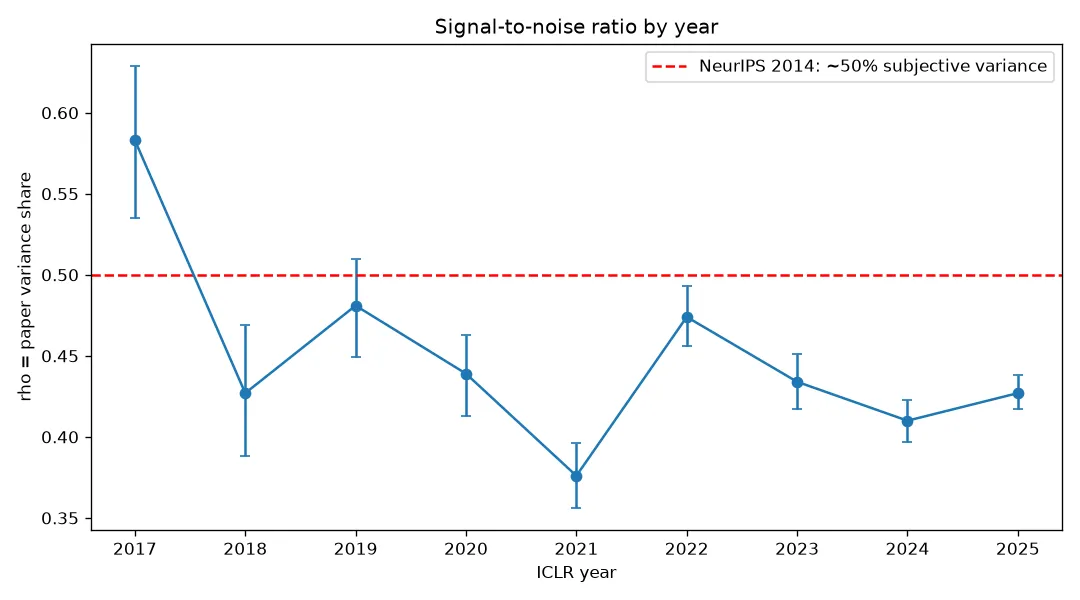
スコアの分散のうち論文そのものに由来する割合を年ごとに示したもの。およそ半分で、残りは査読者のノイズだ。— 図2、Huang (2026), arXiv:2610.06591.
およそ4本に1本
スコアのばらつきのうち論文そのものに由来する割合は、年によって0.38から0.58のあいだだ。残りは査読者のノイズで、およそ半分とした2014年の推定と一致する。その帰結は次のとおりだ。
- 委員会あたり2人の査読者では、論文の**22.8%(2017年)から30.3%(2025年)**で判定がひっくり返る。4人の査読者では17.7〜24.2%。
- **採択論文の30〜50%**は、独立した委員会では不採択になっていたはずだ。2021年には半分にもなる。
- 投稿数がおよそ24倍に増えた9年間(2017年に489本、2025年に11,663本)で、研究は頑健な傾向を見いださない。ノイズははっきり増えも減りもしない。著者は、9年分のデータしかない以上、これは強い傾向がないことの証拠であって、安定していることの証明ではないと強調する。
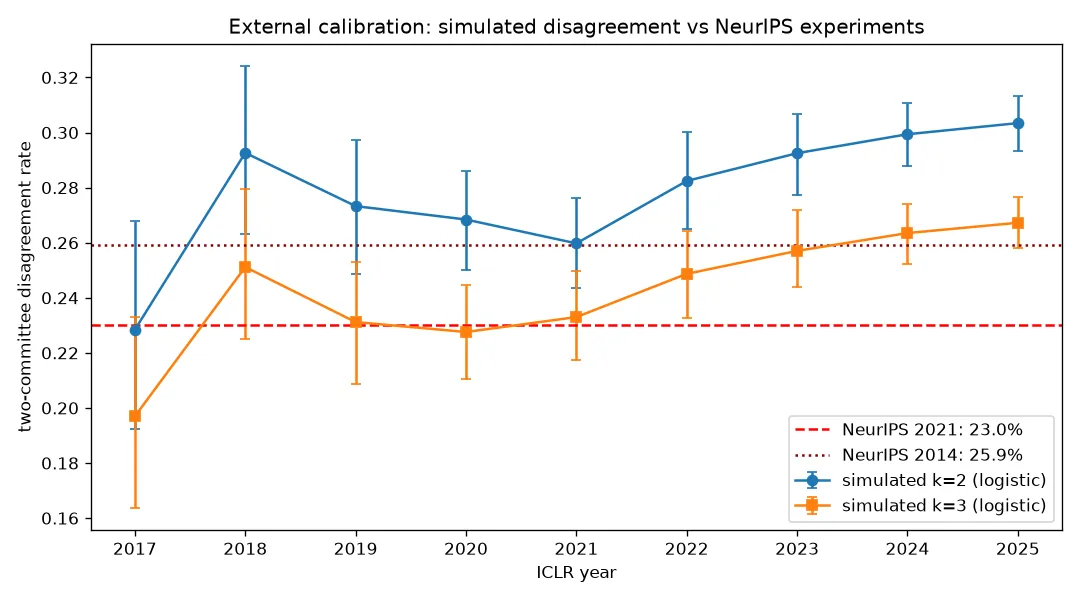
二つの委員会のあいだでシミュレーションした不一致を、NeurIPSの二つの実際の実験と比べたもの。— 図3、Huang (2026), arXiv:2610.06591.
尺度そのものが偶然を増やす
二つの年が目立つ。2020年、ICLRは粗い4段階の採点尺度(1、3、6、8)を使った。論文の23.7%が、すべての査読者から同じスコアを受けた。ほかの年は4.7〜13.1%だ。その影響を試すため、著者は10点満点でつけられた2021年のスコアを、4段階の尺度に付け直した。結果、信号のおよそ8%が失われ、委員会間の不一致は約7ポイント上がり、ひっくり返る採択論文の割合は約11ポイント上がった。粗い尺度は、同じ意見に別のラベルを貼り直すだけではない。偶然を付け加えるのだ。
2021年は事情が違う。尺度は細かいが、信号は9年間で最も弱く、採択論文の**30.4%**が採択の閾値のすぐ上にあった。境界線の近くに論文が多く、ノイズもたっぷりある。ひっくり返りやすいわけだ。
チャットボットは?
研究では、言語モデルが広まった2023年以降に査読のふるまいが変わったかを調べる計画だった。しかし公開データには、2022年より後の査読の本文も査読者の確信度も含まれておらず、使える統計検定にはほとんど検出力がない。そこで著者は、どちらの方向にも結論を出さない。そして、その自制は意図的なものだと述べる。
くじ引きを監査する
この方法に必要なのはスコアと判定だけで、いくつかの会議はすでにそれを公開している。どの会議も、査読を一件も重複させることなく、自分たちの「くじ引き」率を計算できるだろう。ICLRの9年間についての著者の判定はこうだ。査読は崩壊しているわけでも、改善しているわけでもない。ほぼ同じ水準でノイズが多いままだ。研究の対象はICLRだけで、著者は一人の独立研究者だ。