TRÒ XỔ SỐ BÌNH DUYỆT
Khoa học vận hành dựa trên bình duyệt: trước khi một kết quả được công bố, các chuyên gia khác thẩm định nó. Tại các hội nghị học máy lớn, một nhóm nhỏ người phản biện chấm điểm mỗi bài gửi, và bài báo được nhận hoặc bị loại. Đằng sau nghi thức này là một câu hỏi khó chịu. Gửi cùng một bài báo cho những người phản biện khác, phán quyết có giống vậy không?
Hai thí nghiệm tốn kém
Những câu trả lời trực tiếp duy nhất đến từ hai thí nghiệm trong đó một hội nghị bình duyệt một số bài báo hai lần, với hai hội đồng độc lập. Bài báo nhắc lại kết quả của chúng:
- NeurIPS 2014: trong 166 bài được bình duyệt hai lần, hai hội đồng bất đồng về 43 bài — 25,9 phần trăm. Khoảng một nửa số bài được một hội đồng nhận lẽ ra đã bị hội đồng kia loại.
- NeurIPS 2021: trên 882 bài, các hội đồng bất đồng ở 23,0 phần trăm.
Những thí nghiệm như vậy hiếm vì chúng tốn kém: chúng đồng nghĩa với việc nhân đôi công việc bình duyệt của hàng trăm bài báo. Feilian Huang, một nhà nghiên cứu độc lập, đặt câu hỏi liệu có thể ước tính cùng con số đó chỉ từ dữ liệu công khai hay không.
Mô phỏng một hội đồng thứ hai
Nghiên cứu sử dụng các bài phản biện công khai của hội nghị ICLR từ 2017 đến 2025: 36.113 bài báo và 134.912 bài phản biện. Một mô hình thống kê tách mỗi điểm số thành hai phần: chất lượng ẩn của bài báo, và “nhiễu” do mỗi người phản biện thêm vào. Một mô hình thứ hai tái hiện cách điểm số chuyển thành quyết định. Rồi máy tính hình dung, cho mỗi bài báo, hai hội đồng độc lập gồm hai, ba hoặc bốn người phản biện, lặp lại một nghìn lần, và đếm xem chúng bất đồng thường xuyên đến đâu.
Trước khi tin vào kết quả, tác giả đã kiểm tra nó hai lần. So với thí nghiệm NeurIPS 2021, với ba người phản biện mỗi bài như ở đó, mô phỏng cho 23,3 phần trăm bất đồng so với 23,0 phần trăm đo được. Và với các bài ICLR có ít nhất bốn bài phản biện, chỉ cần chia ngẫu nhiên những người phản biện thật thành hai cặp cũng cho cùng đáp án với mô hình, sai lệch không quá một điểm, vào năm 2018 và mọi năm từ 2021 đến 2025.
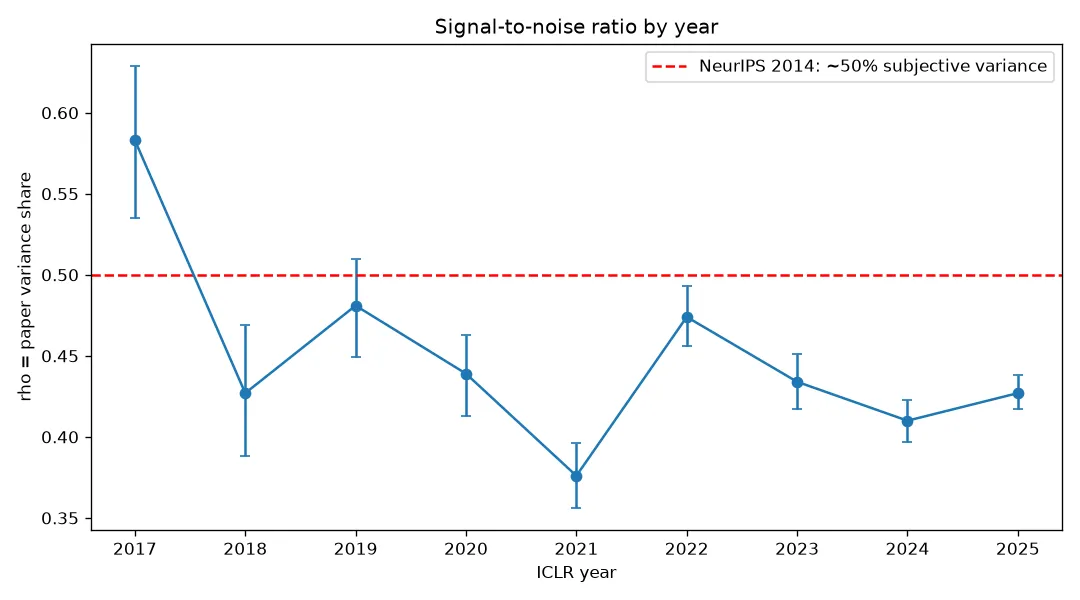
Phần phương sai điểm số do chính bài báo, theo từng năm: khoảng một nửa, phần còn lại là nhiễu của người phản biện. — Hình 2, Huang (2026), arXiv:2610.06591.
Khoảng một bài trên bốn
Phần biến thiên điểm số đến từ chính bài báo dao động từ 0,38 đến 0,58 tùy năm — phần còn lại là nhiễu của người phản biện, phù hợp với ước tính năm 2014 là khoảng một nửa. Hệ quả:
- Với hai người phản biện mỗi hội đồng, quyết định đảo ngược với 22,8 phần trăm (2017) đến 30,3 phần trăm (2025) số bài. Với bốn người phản biện, từ 17,7 đến 24,2 phần trăm.
- 30 đến 50 phần trăm số bài được nhận lẽ ra đã bị một hội đồng độc lập loại — tới một nửa vào năm 2021.
- Qua chín năm mà số bài gửi tăng khoảng 24 lần (489 năm 2017, 11.663 năm 2025), nghiên cứu không tìm thấy xu hướng vững chắc nào: nhiễu không rõ ràng tăng lên cũng không giảm đi. Tác giả nhấn mạnh rằng với chỉ chín năm dữ liệu, đây là bằng chứng chống lại một xu hướng mạnh, chứ không phải bằng chứng của sự ổn định.
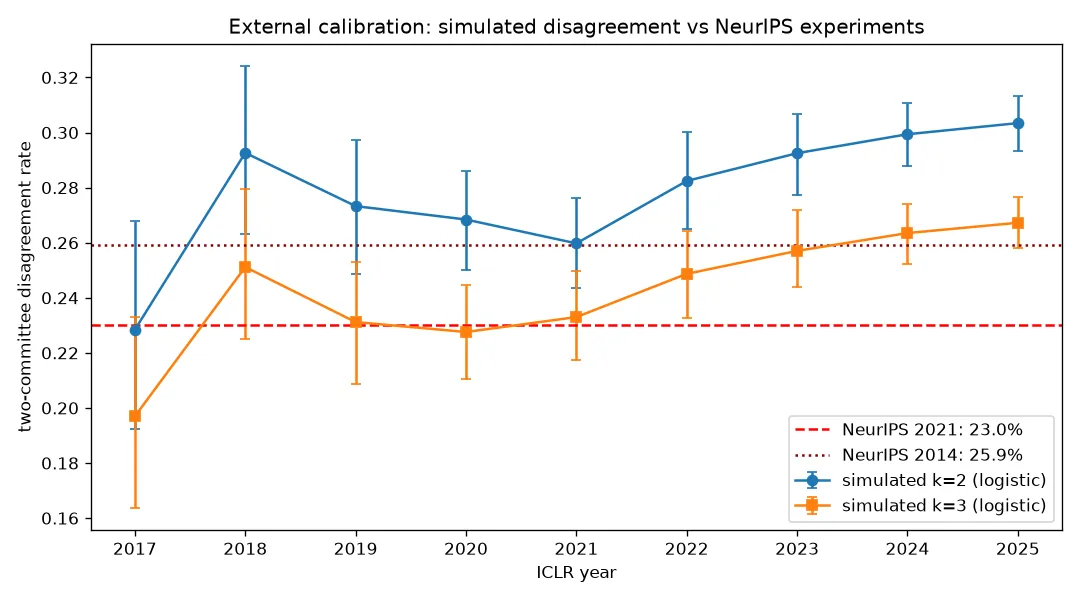
Bất đồng mô phỏng giữa hai hội đồng, so với hai thí nghiệm NeurIPS thật. — Hình 3, Huang (2026), arXiv:2610.06591.
Bản thân thang điểm thêm vào sự may rủi
Hai năm nổi bật. Năm 2020, ICLR dùng một thang chấm thô bốn mức (1, 3, 6, 8): 23,7 phần trăm số bài nhận được điểm giống hệt nhau từ tất cả người phản biện, so với 4,7 đến 13,1 phần trăm ở các năm khác. Để kiểm tra ảnh hưởng, tác giả lấy điểm năm 2021, chấm trên thang 10, và mã hóa lại chúng theo thang bốn mức. Kết quả: khoảng 8 phần trăm tín hiệu bị mất, bất đồng giữa các hội đồng tăng khoảng 7 điểm, và tỷ lệ bài được nhận bị đảo ngược tăng khoảng 11 điểm. Một thang điểm thô không chỉ dán nhãn lại cho cùng những ý kiến; nó thêm vào sự may rủi.
Năm 2021 thì khác: thang điểm chi tiết, nhưng tín hiệu yếu nhất trong chín năm, và 30,4 phần trăm số bài được nhận nằm ngay trên ngưỡng chấp nhận. Nhiều bài gần lằn ranh, nhiều nhiễu: dễ đảo ngược.
Còn chatbot thì sao?
Nghiên cứu đã dự định tìm kiếm sự thay đổi trong hành vi phản biện sau năm 2023, khi các mô hình ngôn ngữ lan rộng. Dữ liệu công khai không chứa văn bản phản biện hay độ tự tin của người phản biện sau năm 2022, và phép kiểm định thống kê có sẵn gần như không có lực. Vì vậy, tác giả không rút ra kết luận theo hướng nào — và trình bày sự kiềm chế đó như một lựa chọn có chủ ý.
Kiểm toán trò xổ số
Phương pháp chỉ cần điểm số và quyết định, những thứ mà nhiều hội nghị đã công bố. Bất kỳ hội nghị nào cũng có thể tự tính tỷ lệ “xổ số” của mình mà không cần nhân đôi một bài phản biện nào. Phán quyết của tác giả về chín năm ICLR: việc bình duyệt không sụp đổ cũng không cải thiện — nó vẫn nhiễu ở mức gần như cũ. Nghiên cứu chỉ bao gồm ICLR, và tác giả là một nhà nghiên cứu độc lập duy nhất.