ہم مرتبہ جائزے کی لاٹری
سائنس ہم مرتبہ جائزے (peer review) پر چلتی ہے: کوئی نتیجہ شائع ہونے سے پہلے دوسرے ماہرین اسے پرکھتے ہیں۔ مشین لرننگ کی بڑی کانفرنسوں میں مٹھی بھر جائزہ کار ہر جمع کرائے گئے مقالے کو نمبر دیتے ہیں، اور مقالہ قبول یا مسترد ہو جاتا ہے۔ اس رسم کے پیچھے ایک تکلیف دہ سوال ہے۔ ایک ہی مقالہ دوسرے جائزہ کاروں کو بھیجیں تو کیا فیصلہ وہی ہوگا؟
دو مہنگے تجربے
واحد براہِ راست جوابات دو تجربوں سے آتے ہیں جن میں ایک کانفرنس نے کچھ مقالوں کا دو بار جائزہ لیا، دو آزاد کمیٹیوں سے۔ مقالہ ان کے نتائج یاد دلاتا ہے:
- NeurIPS 2014: دو بار جائزہ لیے گئے 166 مقالوں میں سے 43 پر دونوں کمیٹیاں متفق نہیں تھیں — 25.9 فیصد۔ ایک کمیٹی کے قبول کیے گئے مقالوں میں سے تقریباً آدھے دوسری کمیٹی مسترد کر دیتی۔
- NeurIPS 2021: 882 مقالوں پر کمیٹیوں میں 23.0 فیصد اختلاف ہوا۔
ایسے تجربے نایاب ہیں کیونکہ مہنگے ہیں: ان کا مطلب سینکڑوں مقالوں کا جائزہ دوگنا کرنا ہے۔ ایک آزاد محقق، فیلیان ہوانگ، نے سوال اٹھایا کہ کیا یہی عدد صرف عوامی ڈیٹا سے اندازہ لگایا جا سکتا ہے۔
دوسری کمیٹی کی سمولیشن
یہ تحقیق 2017 سے 2025 تک ICLR کانفرنس کے عوامی جائزوں کو استعمال کرتی ہے: 36,113 مقالے اور 134,912 جائزے۔ ایک شماریاتی ماڈل ہر نمبر کو دو حصوں میں بانٹتا ہے: مقالے کا پوشیدہ معیار، اور ہر جائزہ کار کا شامل کیا ہوا “شور”۔ دوسرا ماڈل دہراتا ہے کہ نمبر فیصلوں میں کیسے بدلتے ہیں۔ پھر کمپیوٹر ہر مقالے کے لیے دو، تین یا چار جائزہ کاروں پر مشتمل دو آزاد کمیٹیاں تصور کرتا ہے، ہزار بار، اور گنتا ہے کہ وہ کتنی بار متفق نہیں ہوتیں۔
نتیجے پر بھروسا کرنے سے پہلے مصنف نے اسے دو بار جانچا۔ NeurIPS 2021 کے تجربے کے مقابلے میں، وہاں کی طرح فی مقالہ تین جائزہ کاروں کے ساتھ، سمولیشن 23.3 فیصد اختلاف دیتی ہے جبکہ ناپا گیا 23.0 فیصد تھا۔ اور کم از کم چار جائزوں والے ICLR مقالوں پر حقیقی جائزہ کاروں کو بس دو بے ترتیب جوڑوں میں بانٹنے سے وہی جواب ملتا ہے جو ماڈل دیتا ہے، ایک پوائنٹ کے اندر، 2018 میں اور 2021 سے 2025 تک ہر سال۔
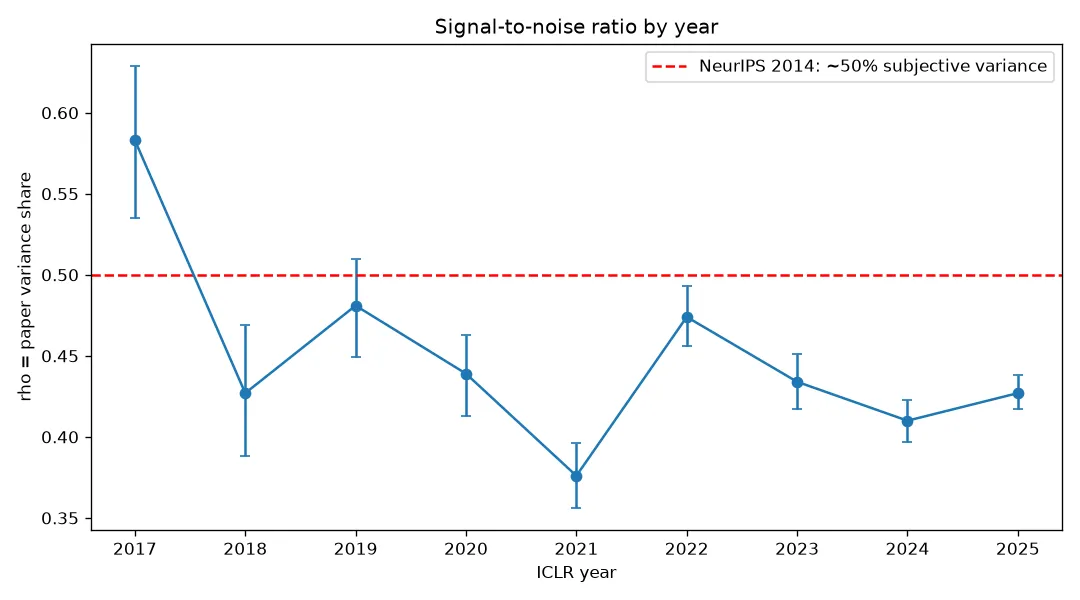
سال بہ سال نمبروں کے تغیر کا وہ حصہ جو خود مقالے کی وجہ سے ہے: تقریباً آدھا، باقی جائزہ کاروں کا شور۔ — شکل 2، Huang (2026)، arXiv:2610.06591۔
تقریباً چار میں سے ایک مقالہ
نمبروں کے تغیر کا جو حصہ خود مقالے سے آتا ہے وہ سال کے لحاظ سے 0.38 سے 0.58 تک ہے — باقی جائزہ کاروں کا شور ہے، جو 2014 کے تقریباً آدھے کے اندازے سے ہم آہنگ ہے۔ نتائج:
- فی کمیٹی دو جائزہ کاروں کے ساتھ 22.8 فیصد (2017) سے 30.3 فیصد (2025) مقالوں کا فیصلہ الٹ جاتا ہے۔ چار جائزہ کاروں کے ساتھ 17.7 سے 24.2 فیصد۔
- قبول شدہ مقالوں میں سے 30 سے 50 فیصد کو ایک آزاد کمیٹی مسترد کر دیتی — 2021 میں آدھے تک۔
- نو برسوں میں جب جمع کرائے گئے مقالے تقریباً 24 گنا بڑھے (2017 میں 489، 2025 میں 11,663)، تحقیق کو کوئی ٹھوس رجحان نہیں ملتا: شور نہ واضح طور پر بڑھتا ہے نہ گھٹتا ہے۔ مصنف زور دیتا ہے کہ صرف نو سال کے ڈیٹا کے ساتھ یہ کسی مضبوط رجحان کے خلاف ثبوت ہے، استحکام کا ثبوت نہیں۔
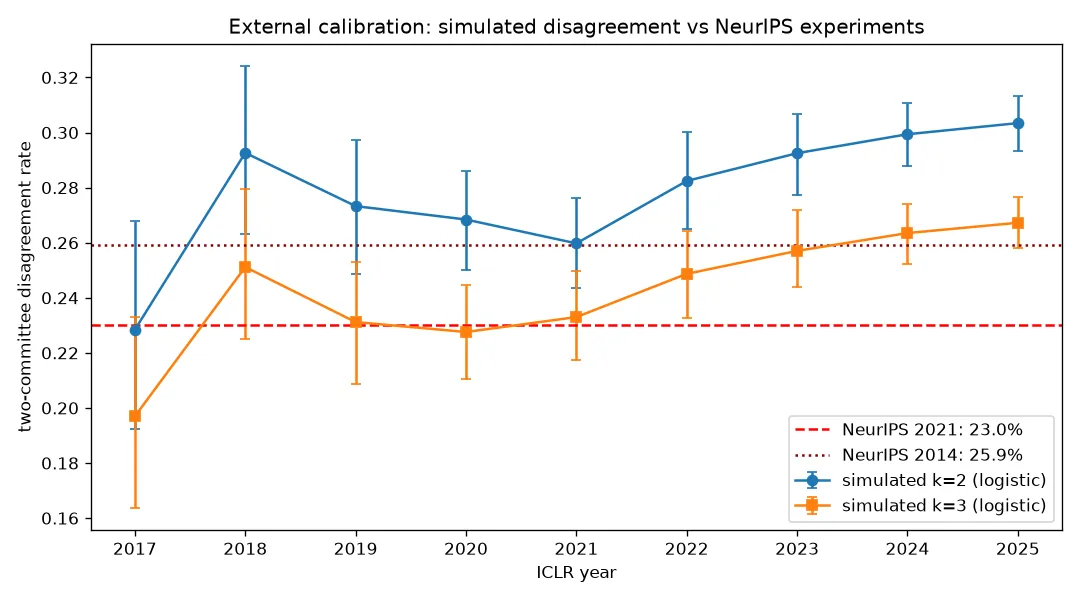
دو کمیٹیوں کے درمیان سمولیٹ کیا گیا اختلاف، NeurIPS کے دو حقیقی تجربوں کے مقابلے میں۔ — شکل 3، Huang (2026)، arXiv:2610.06591۔
پیمانہ خود اتفاق شامل کرتا ہے
دو سال نمایاں ہیں۔ 2020 میں ICLR نے چار درجوں کا ایک موٹا درجہ بندی کا پیمانہ (1، 3، 6، 8) استعمال کیا: 23.7 فیصد مقالوں کو ان کے تمام جائزہ کاروں سے یکساں نمبر ملے، جبکہ دوسرے برسوں میں یہ 4.7 سے 13.1 فیصد تھا۔ اثر جانچنے کے لیے مصنف نے 2021 کے نمبر لیے، جو 10 میں سے دیے گئے تھے، اور انہیں چار درجوں والے پیمانے پر دوبارہ ڈھالا۔ نتیجہ: سگنل کا تقریباً 8 فیصد ضائع ہو جاتا ہے، کمیٹیوں کے درمیان اختلاف تقریباً 7 پوائنٹ بڑھ جاتا ہے، اور ان قبول شدہ مقالوں کا حصہ جن کا فیصلہ الٹ جاتا، تقریباً 11 پوائنٹ بڑھ جاتا ہے۔ موٹا پیمانہ صرف انہی آرا پر نیا لیبل نہیں لگاتا؛ یہ اتفاق کا عنصر شامل کرتا ہے۔
2021 مختلف ہے: باریک پیمانہ، لیکن نو سال کا سب سے کمزور سگنل، اور قبول شدہ مقالوں میں سے 30.4 فیصد قبولیت کی حد سے ذرا ہی اوپر تھے۔ لکیر کے قریب بہت سے مقالے، بہت سا شور: آسانی سے الٹنے والے فیصلے۔
اور چیٹ بوٹس؟
تحقیق کا منصوبہ تھا کہ 2023 کے بعد، جب لسانی ماڈلز پھیلے، جائزہ کاروں کے رویے میں تبدیلی تلاش کی جائے۔ عوامی ڈیٹا میں 2022 کے بعد نہ جائزوں کا متن ہے نہ جائزہ کاروں کا اعتماد، اور دستیاب شماریاتی ٹیسٹ میں تقریباً کوئی طاقت نہیں۔ اس لیے مصنف کسی بھی سمت میں کوئی نتیجہ اخذ نہیں کرتا — اور اس احتیاط کو سوچا سمجھا فیصلہ قرار دیتا ہے۔
لاٹری کا آڈٹ
اس طریقے کو صرف نمبروں اور فیصلوں کی ضرورت ہے، جو کئی کانفرنسیں پہلے ہی شائع کرتی ہیں۔ ان میں سے کوئی بھی ایک بھی جائزہ دہرائے بغیر اپنی “لاٹری” کی شرح نکال سکتی ہے۔ ICLR کے نو سال پر مصنف کا فیصلہ: جائزہ نہ تو ڈھے رہا ہے نہ بہتر ہو رہا ہے — یہ تقریباً اسی سطح پر شور زدہ رہتا ہے۔ تحقیق صرف ICLR کا احاطہ کرتی ہے، اور اس کا مصنف ایک واحد آزاد محقق ہے۔