A LOTERIA DA REVISÃO POR PARES
A ciência funciona à base da revisão por pares: antes de um resultado ser publicado, outros especialistas o avaliam. Nas grandes conferências de aprendizado de máquina, um punhado de revisores dá nota a cada submissão, e o artigo é aceito ou rejeitado. Por trás desse ritual há uma pergunta incômoda. Se o mesmo artigo fosse enviado a outros revisores, o veredito seria o mesmo?
Dois experimentos caros
As únicas respostas diretas vêm de dois experimentos em que uma conferência revisou alguns artigos duas vezes, com dois comitês independentes. O artigo relembra os resultados:
- NeurIPS 2014: dos 166 artigos revisados em dobro, os dois comitês discordaram em 43 — 25,9 por cento. Cerca de metade dos artigos aceitos por um comitê teria sido rejeitada pelo outro.
- NeurIPS 2021: em 882 artigos, os comitês discordaram em 23,0 por cento.
Experimentos assim são raros porque são caros: significam dobrar a revisão de centenas de artigos. Feilian Huang, um pesquisador independente, perguntou-se se o mesmo número poderia ser estimado apenas a partir de dados públicos.
Simulando um segundo comitê
O estudo usa as revisões públicas da conferência ICLR de 2017 a 2025: 36.113 artigos e 134.912 revisões. Um modelo estatístico divide cada nota em duas partes: a qualidade oculta do artigo e o “ruído” acrescentado por cada revisor. Um segundo modelo reproduz como as notas se transformam em decisões. O computador então imagina, para cada artigo, dois comitês independentes de dois, três ou quatro revisores, mil vezes seguidas, e conta com que frequência eles discordam.
Antes de confiar no resultado, o autor o verificou duas vezes. Diante do experimento da NeurIPS 2021, com três revisores por artigo, como lá, a simulação dá 23,3 por cento de discordância contra 23,0 por cento medidos. E, nos artigos da ICLR com pelo menos quatro revisões, simplesmente dividir os revisores reais em dois pares aleatórios dá a mesma resposta que o modelo, com diferença de até um ponto, em 2018 e em todos os anos de 2021 a 2025.
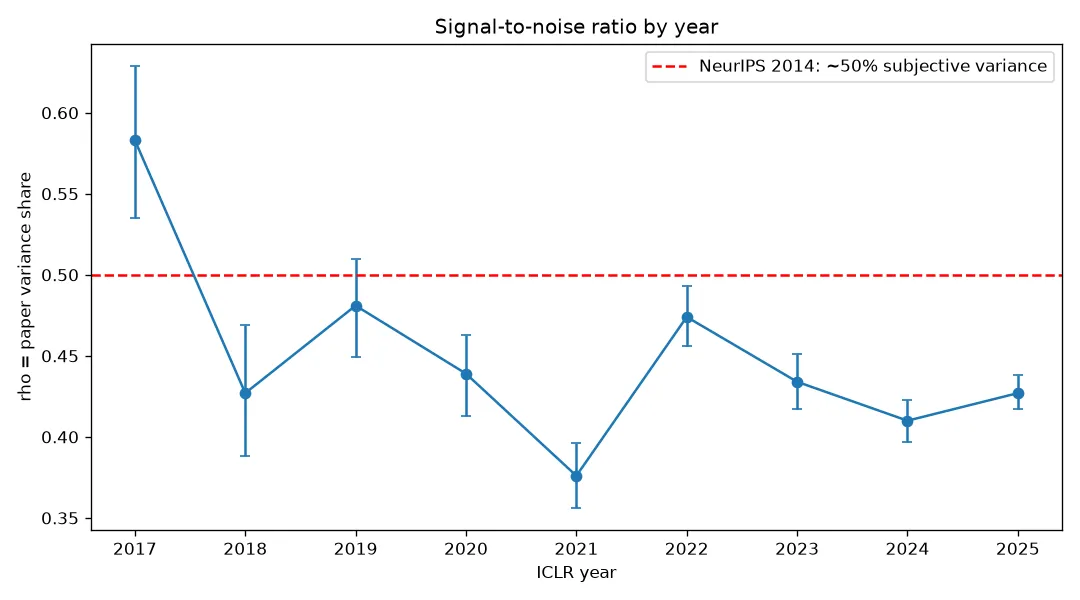
Parcela da variância das notas devida ao próprio artigo, ano a ano: cerca de metade, o resto é ruído dos revisores. — Figura 2, Huang (2026), arXiv:2610.06591.
Cerca de um artigo em cada quatro
A parcela da variação das notas que vem do próprio artigo vai de 0,38 a 0,58, dependendo do ano — o resto é ruído dos revisores, em linha com a estimativa de 2014, de cerca de metade. As consequências:
- Com dois revisores por comitê, a decisão se inverte para 22,8 por cento (2017) a 30,3 por cento (2025) dos artigos. Com quatro revisores, de 17,7 a 24,2 por cento.
- De 30 a 50 por cento dos artigos aceitos teriam sido rejeitados por um comitê independente — até a metade em 2021.
- Ao longo de nove anos em que as submissões cresceram cerca de 24 vezes (489 em 2017, 11.663 em 2025), o estudo não encontra nenhuma tendência robusta: o ruído nem cresce nem diminui claramente. O autor ressalta que, com apenas nove anos de dados, isso é evidência contra uma tendência forte, não prova de estabilidade.
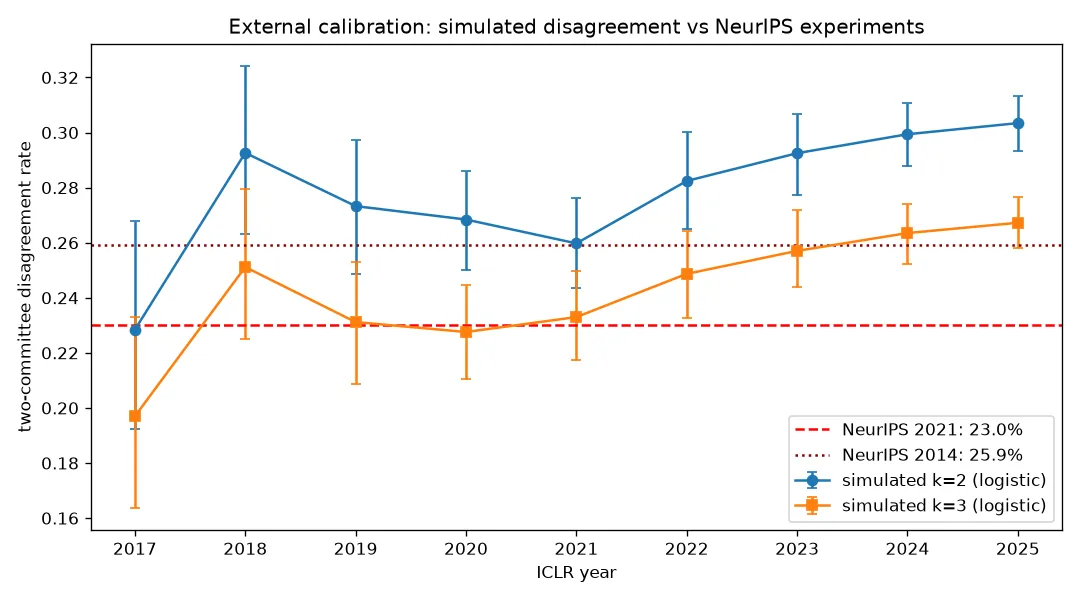
Discordância simulada entre dois comitês, comparada com os dois experimentos reais da NeurIPS. — Figura 3, Huang (2026), arXiv:2610.06591.
A própria escala acrescenta acaso
Dois anos se destacam. Em 2020, a ICLR usou uma escala grosseira de avaliação com quatro níveis (1, 3, 6, 8): 23,7 por cento dos artigos receberam notas idênticas de todos os seus revisores, contra 4,7 a 13,1 por cento nos outros anos. Para testar o efeito, o autor pegou as notas de 2021, dadas numa escala até 10, e as recodificou na escala de quatro níveis. Resultado: cerca de 8 por cento do sinal se perde, a discordância entre comitês sobe cerca de 7 pontos, e a parcela de artigos aceitos cuja decisão se inverteria sobe cerca de 11 pontos. Uma escala grosseira não apenas rotula de novo as mesmas opiniões; ela acrescenta acaso.
2021 é diferente: uma escala fina, mas o sinal mais fraco dos nove anos, e 30,4 por cento dos artigos aceitos ficaram logo acima do limiar de aceitação. Muitos artigos perto da linha, muito ruído: inversões fáceis.
E os chatbots?
O estudo planejava procurar uma mudança no comportamento dos revisores depois de 2023, quando os modelos de linguagem se espalharam. Os dados públicos não contêm o texto das revisões nem a confiança dos revisores após 2022, e o teste estatístico disponível quase não tem poder. O autor, portanto, não tira conclusão nenhuma, em nenhum sentido — e apresenta essa contenção como deliberada.
Auditar a loteria
O método precisa apenas de notas e decisões, que várias conferências já publicam. Qualquer uma delas poderia calcular sua própria taxa de “loteria” sem duplicar uma única revisão. O veredito do autor sobre nove anos de ICLR: a revisão nem está desmoronando nem melhorando — continua ruidosa mais ou menos no mesmo nível. O estudo cobre apenas a ICLR, e seu autor é um único pesquisador independente.