يانصيب التحكيم العلمي
يقوم العلم على تحكيم الأقران: فقبل نشر نتيجة ما، يحكم عليها خبراء آخرون. وفي مؤتمرات تعلّم الآلة الكبرى، يمنح حفنة من المحكّمين كل ورقة مقدَّمة درجات، فتُقبل أو تُرفض. وخلف هذا الطقس يكمن سؤال مُحرج. لو أُرسلت الورقة نفسها إلى محكّمين آخرين، هل سيكون الحكم نفسه؟
تجربتان مكلفتان
الإجابات المباشرة الوحيدة تأتي من تجربتين حكّم فيهما مؤتمرٌ بعض الأوراق مرتين، بلجنتين مستقلتين. وتذكّر الورقة بنتائجهما:
- NeurIPS 2014: من بين 166 ورقة حُكّمت مرتين، اختلفت اللجنتان على 43 — أي 25.9 في المئة. ونحو نصف الأوراق التي قبلتها لجنة كانت سترفضها الأخرى.
- NeurIPS 2021: على 882 ورقة، اختلفت اللجنتان في 23.0 في المئة.
مثل هذه التجارب نادرة لأنها مكلفة: فهي تعني مضاعفة تحكيم مئات الأوراق. وتساءل فيليان هوانغ (Feilian Huang)، وهو باحث مستقل، إن كان يمكن تقدير الرقم نفسه من البيانات العلنية وحدها.
محاكاة لجنة ثانية
تستخدم الدراسة التحكيمات العلنية لمؤتمر ICLR من 2017 إلى 2025: 36,113 ورقة و134,912 تحكيمًا. ويقسّم نموذج إحصائي كل درجة إلى جزأين: الجودة الخفية للورقة، و«الضجيج» الذي يضيفه كل محكّم. ويعيد نموذج ثانٍ إنتاج كيفية تحوّل الدرجات إلى قرارات. ثم يتخيّل الحاسوب لكل ورقة لجنتين مستقلتين من محكّمَين أو ثلاثة أو أربعة، ألف مرة، ويعدّ كم مرة تختلفان.
وقبل الوثوق بالنتيجة، تحقق المؤلف منها مرتين. فمقارنة بتجربة NeurIPS 2021، مع ثلاثة محكّمين لكل ورقة كما هناك، تعطي المحاكاة 23.3 في المئة من الاختلاف مقابل 23.0 في المئة مقيسة. وعلى أوراق ICLR التي لها أربعة تحكيمات على الأقل، فإن مجرد تقسيم المحكّمين الحقيقيين إلى زوجين عشوائيين يعطي الإجابة نفسها التي يعطيها النموذج، بفارق نقطة واحدة، في 2018 وفي كل سنة من 2021 إلى 2025.
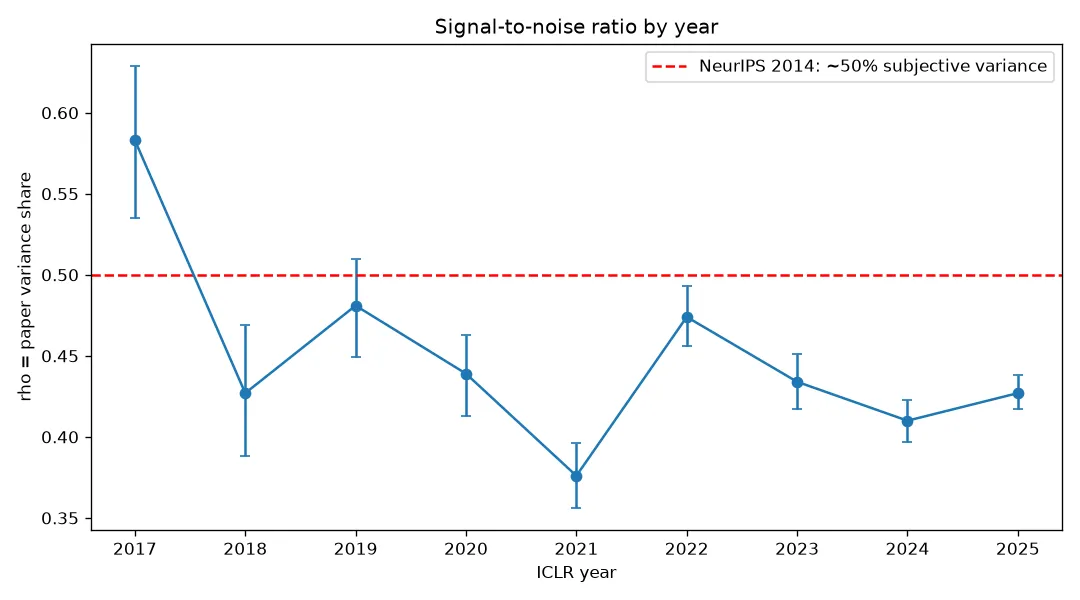
حصة تباين الدرجات العائدة إلى الورقة نفسها، سنة بعد سنة: نحو النصف، والباقي ضجيج المحكّمين. — الشكل 2، Huang (2026)، arXiv:2610.06591.
نحو ورقة من كل أربع
تتراوح حصة تفاوت الدرجات الآتية من الورقة نفسها بين 0.38 و0.58 بحسب السنة — والباقي ضجيج المحكّمين، بما يتسق مع تقدير 2014 بنحو النصف. والعواقب:
- مع محكّمَين لكل لجنة، ينقلب القرار لـ22.8 في المئة (2017) إلى 30.3 في المئة (2025) من الأوراق. ومع أربعة محكّمين، من 17.7 إلى 24.2 في المئة.
- 30 إلى 50 في المئة من الأوراق المقبولة كانت لجنة مستقلة سترفضها — وتصل النسبة إلى النصف في 2021.
- على مدى تسع سنوات تضاعفت فيها الأوراق المقدَّمة نحو 24 مرة (489 في 2017، و11,663 في 2025)، لا تجد الدراسة أي اتجاه متين: فالضجيج لا يزداد بوضوح ولا يتناقص. ويؤكد المؤلف أنه مع تسع سنوات فقط من البيانات، فهذا دليل ضد وجود اتجاه قوي، لا برهان على الثبات.
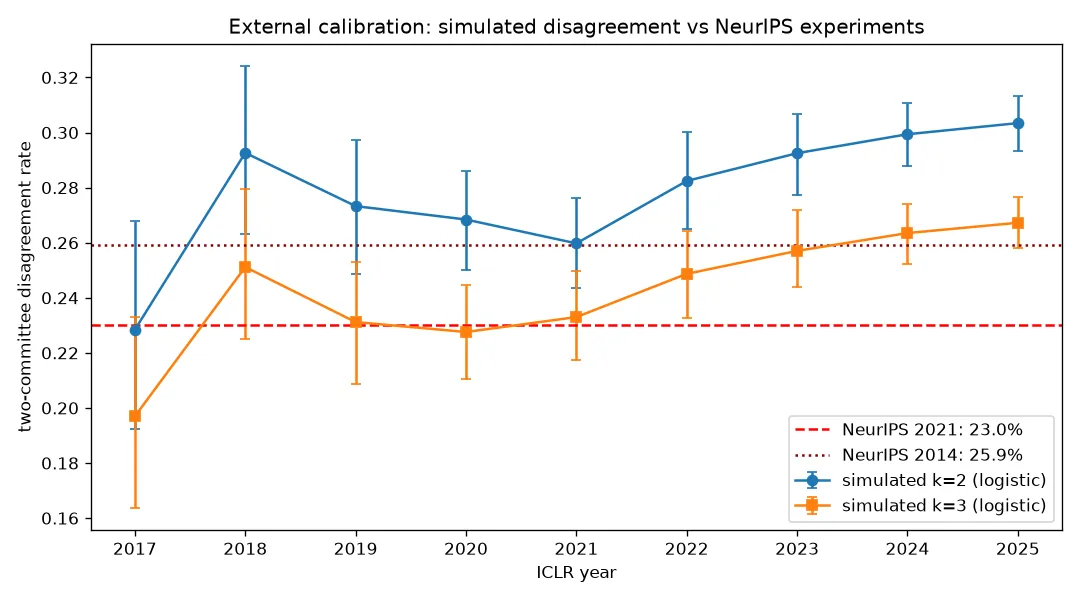
الاختلاف المحاكى بين لجنتين، مقارنة بتجربتَي NeurIPS الحقيقيتين. — الشكل 3، Huang (2026)، arXiv:2610.06591.
السلّم نفسه يضيف المصادفة
تبرز سنتان. ففي 2020، استخدم ICLR سلّم درجات خشنًا من أربعة مستويات (1، 3، 6، 8): وتلقّت 23.7 في المئة من الأوراق درجات متطابقة من جميع محكّميها، مقابل 4.7 إلى 13.1 في المئة في السنوات الأخرى. ولاختبار الأثر، أخذ المؤلف درجات 2021، الممنوحة من 10، وأعاد ترميزها على السلّم ذي المستويات الأربعة. والنتيجة: يُفقد نحو 8 في المئة من الإشارة، ويرتفع الاختلاف بين اللجان بنحو 7 نقاط، وترتفع حصة الأوراق المقبولة التي ستنقلب بنحو 11 نقطة. فالسلّم الخشن لا يكتفي بإعادة تسمية الآراء نفسها؛ بل يضيف المصادفة.
أما 2021 فمختلفة: سلّم دقيق، لكن أضعف إشارة في السنوات التسع، و30.4 في المئة من الأوراق المقبولة كانت فوق عتبة القبول بقليل. أوراق كثيرة قرب الخط، وضجيج وفير: قرارات تنقلب بسهولة.
وماذا عن روبوتات الدردشة؟
خطّطت الدراسة للبحث عن تغيّر في سلوك المحكّمين بعد 2023، حين انتشرت النماذج اللغوية. لكن البيانات العلنية لا تتضمن نص التحكيمات ولا درجة ثقة المحكّمين بعد 2022، والاختبار الإحصائي المتاح يكاد يخلو من القوة. لذلك لا يستخلص المؤلف أي استنتاج في أي اتجاه — ويقدّم هذا التحفظ على أنه مقصود.
تدقيق اليانصيب
لا تحتاج الطريقة إلا إلى الدرجات والقرارات، التي تنشرها عدة مؤتمرات بالفعل. ويمكن لأي منها أن يحسب معدل «اليانصيب» الخاص به من دون تكرار تحكيم واحد. وحكم المؤلف على تسع سنوات من ICLR: التحكيم لا ينهار ولا يتحسن — بل يبقى صاخبًا بالمستوى نفسه تقريبًا. وتقتصر الدراسة على ICLR، ومؤلفها باحث مستقل واحد.