ЛОТЕРЕЯ РЕЦЕНЗИРОВАНИЯ
Наука держится на рецензировании: прежде чем результат будет опубликован, его оценивают другие эксперты. На крупных конференциях по машинному обучению горстка рецензентов выставляет оценки каждой заявке, и статью принимают или отклоняют. За этим ритуалом стоит неудобный вопрос. Если отправить ту же статью другим рецензентам, будет ли вердикт тем же?
Два дорогих эксперимента
Единственные прямые ответы дают два эксперимента, в которых конференция рецензировала часть статей дважды, двумя независимыми комитетами. Статья напоминает их результаты:
- NeurIPS 2014: из 166 дважды отрецензированных статей два комитета разошлись во мнениях по 43 — 25,9 процента. Примерно половину статей, принятых одним комитетом, отклонил бы другой.
- NeurIPS 2021: по 882 статьям комитеты разошлись в 23,0 процента случаев.
Такие эксперименты редки, потому что дороги: они означают удвоение рецензирования сотен статей. Фэйлянь Хуан, независимый исследователь, задался вопросом, можно ли оценить то же число только по открытым данным.
Моделирование второго комитета
Исследование использует открытые рецензии конференции ICLR с 2017 по 2025 год: 36 113 статей и 134 912 рецензий. Статистическая модель раскладывает каждую оценку на две части: скрытое качество статьи и «шум», вносимый каждым рецензентом. Вторая модель воспроизводит, как оценки превращаются в решения. Затем компьютер для каждой статьи представляет два независимых комитета из двух, трёх или четырёх рецензентов, тысячу раз подряд, и подсчитывает, как часто они расходятся.
Прежде чем доверять результату, автор дважды его проверил. В сравнении с экспериментом NeurIPS 2021, при трёх рецензентах на статью, как там, моделирование даёт 23,3 процента разногласий против измеренных 23,0 процента. А на статьях ICLR как минимум с четырьмя рецензиями простое разбиение реальных рецензентов на две случайные пары даёт тот же ответ, что и модель, с точностью до одного пункта — в 2018 году и в каждом году с 2021 по 2025.
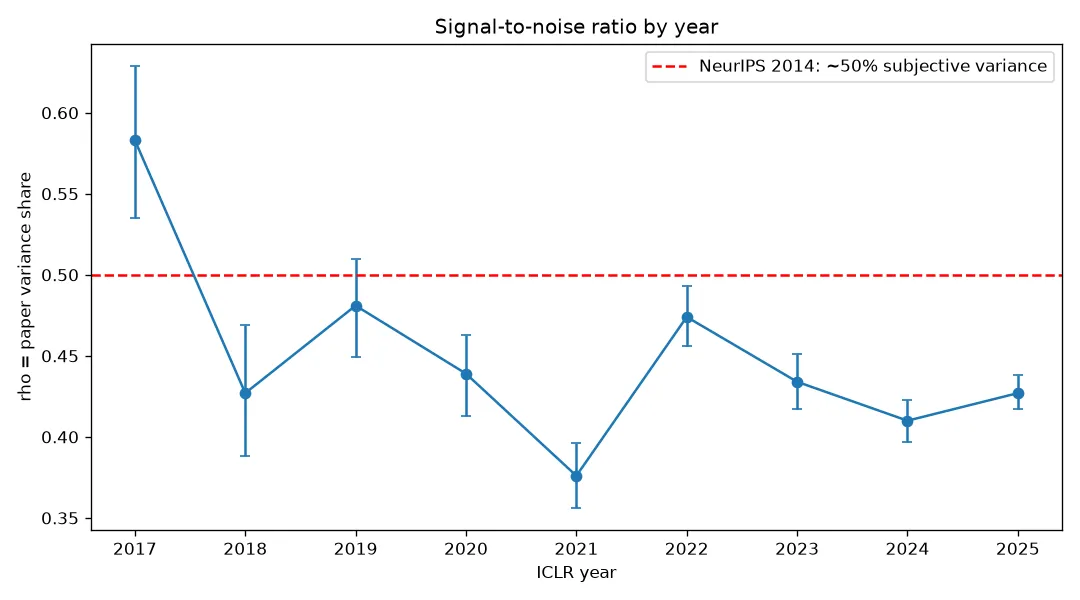
Доля дисперсии оценок, обусловленная самой статьёй, по годам: около половины, остальное — шум рецензентов. — Рисунок 2, Huang (2026), arXiv:2610.06591.
Примерно одна статья из четырёх
Доля разброса оценок, приходящаяся на саму статью, составляет от 0,38 до 0,58 в зависимости от года — остальное шум рецензентов, что согласуется с оценкой 2014 года — около половины. Последствия:
- При двух рецензентах в комитете решение меняется на противоположное для 22,8 процента (2017) — 30,3 процента (2025) статей. При четырёх рецензентах — для 17,7–24,2 процента.
- От 30 до 50 процентов принятых статей были бы отклонены независимым комитетом — в 2021 году до половины.
- За девять лет, в течение которых число заявок выросло примерно в 24 раза (489 в 2017 году, 11 663 в 2025-м), исследование не находит устойчивой тенденции: шум ни явно растёт, ни явно убывает. Автор подчёркивает, что при всего девяти годах данных это свидетельство против сильной тенденции, а не доказательство стабильности.
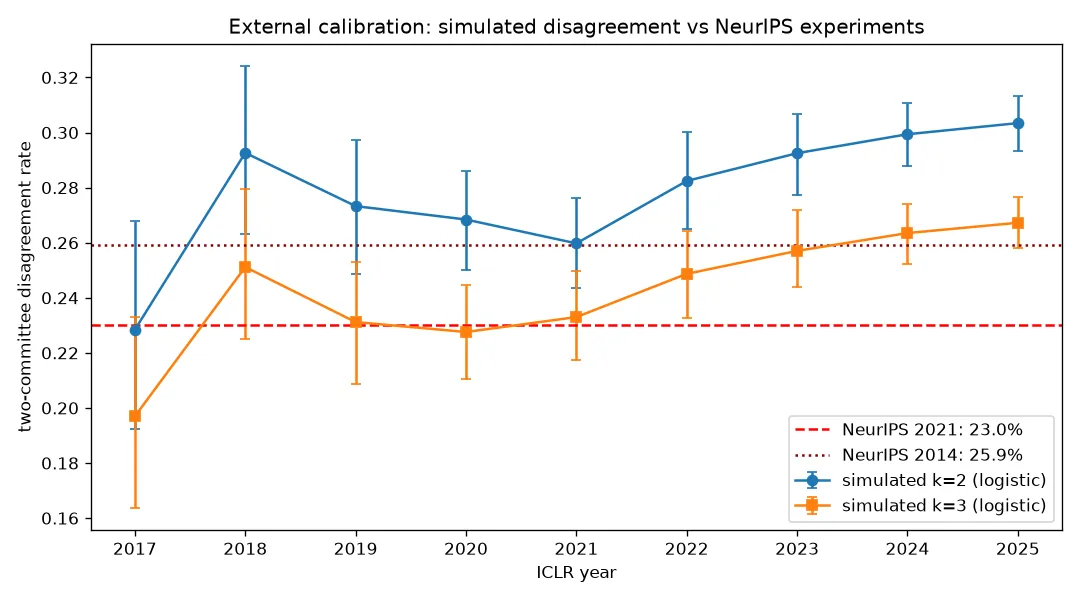
Смоделированные разногласия между двумя комитетами в сравнении с двумя реальными экспериментами NeurIPS. — Рисунок 3, Huang (2026), arXiv:2610.06591.
Сама шкала добавляет случайности
Два года выделяются. В 2020 году ICLR использовала грубую четырёхуровневую шкалу оценок (1, 3, 6, 8): 23,7 процента статей получили одинаковые оценки от всех своих рецензентов, против 4,7–13,1 процента в другие годы. Чтобы проверить эффект, автор взял оценки 2021 года, выставленные по десятибалльной шкале, и перекодировал их в четырёхуровневую. Результат: теряется около 8 процентов сигнала, разногласия между комитетами растут примерно на 7 пунктов, а доля принятых статей, решение по которым изменилось бы, — примерно на 11 пунктов. Грубая шкала не просто переименовывает те же мнения — она добавляет случайности.
2021 год — другой случай: шкала тонкая, но сигнал самый слабый за девять лет, и 30,4 процента принятых статей оказались чуть выше порога принятия. Много статей у самой черты, много шума — решения легко переворачиваются.
А чат-боты?
Исследование планировало поискать изменения в поведении рецензентов после 2023 года, когда распространились языковые модели. Открытые данные после 2022 года не содержат ни текста рецензий, ни уверенности рецензентов, а доступный статистический тест почти не обладает мощностью. Поэтому автор не делает выводов ни в ту, ни в другую сторону — и представляет эту сдержанность как осознанную.
Аудит лотереи
Методу нужны только оценки и решения, которые несколько конференций уже публикуют. Любая из них могла бы рассчитать собственный показатель «лотереи», не дублируя ни одной рецензии. Вердикт автора о девяти годах ICLR: рецензирование не рушится и не улучшается — оно остаётся шумным примерно на одном и том же уровне. Исследование охватывает только ICLR, а его автор — единственный независимый исследователь.