LOTRE TELAAH SEJAWAT
Sains bertumpu pada telaah sejawat (peer review): sebelum sebuah hasil diterbitkan, pakar lain menilainya. Di konferensi-konferensi besar pembelajaran mesin, segelintir penelaah memberi skor pada setiap kiriman, lalu makalah diterima atau ditolak. Di balik ritual ini ada pertanyaan yang tidak nyaman. Jika makalah yang sama dikirim ke penelaah lain, apakah putusannya akan sama?
Dua eksperimen yang mahal
Satu-satunya jawaban langsung datang dari dua eksperimen ketika sebuah konferensi menelaah sebagian makalah dua kali, oleh dua komite independen. Makalah ini mengingatkan hasilnya:
- NeurIPS 2014: dari 166 makalah yang ditelaah ganda, kedua komite tidak sepakat pada 43 — 25,9 persen. Sekitar separuh makalah yang diterima satu komite akan ditolak oleh komite lainnya.
- NeurIPS 2021: dari 882 makalah, kedua komite tidak sepakat pada 23,0 persen.
Eksperimen semacam itu jarang karena mahal: artinya menggandakan penelaahan ratusan makalah. Feilian Huang, seorang peneliti independen, bertanya apakah angka yang sama bisa diperkirakan hanya dari data publik.
Menyimulasikan komite kedua
Studi ini memakai telaah publik konferensi ICLR dari 2017 hingga 2025: 36.113 makalah dan 134.912 telaah. Sebuah model statistik memecah setiap skor menjadi dua bagian: kualitas tersembunyi makalah, dan “derau” (noise) yang ditambahkan setiap penelaah. Model kedua mereproduksi bagaimana skor berubah menjadi keputusan. Komputer lalu membayangkan, untuk setiap makalah, dua komite independen berisi dua, tiga, atau empat penelaah, seribu kali berulang, dan menghitung seberapa sering keduanya tidak sepakat.
Sebelum memercayai hasilnya, penulis memeriksanya dua kali. Dibandingkan dengan eksperimen NeurIPS 2021, dengan tiga penelaah per makalah seperti di sana, simulasi memberikan ketidaksepakatan 23,3 persen berbanding 23,0 persen yang terukur. Dan pada makalah ICLR dengan sedikitnya empat telaah, sekadar membagi penelaah sungguhan ke dalam dua pasangan acak memberikan jawaban yang sama dengan model, dalam selisih satu poin, pada 2018 dan pada setiap tahun dari 2021 hingga 2025.
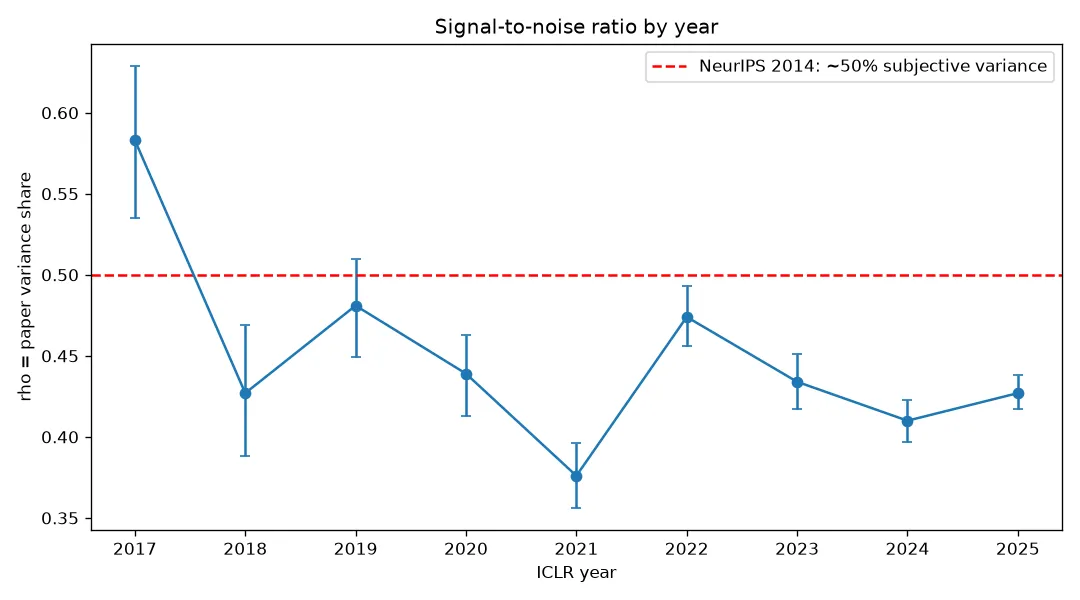
Porsi varians skor yang berasal dari makalah itu sendiri, tahun demi tahun: sekitar separuh, sisanya derau penelaah. — Gambar 2, Huang (2026), arXiv:2610.06591.
Sekitar satu dari empat makalah
Porsi variasi skor yang berasal dari makalah itu sendiri berkisar dari 0,38 hingga 0,58 tergantung tahunnya — sisanya derau penelaah, sejalan dengan perkiraan 2014 yang sekitar separuh. Akibatnya:
- Dengan dua penelaah per komite, keputusan berbalik untuk 22,8 persen (2017) hingga 30,3 persen (2025) makalah. Dengan empat penelaah, 17,7 hingga 24,2 persen.
- 30 hingga 50 persen makalah yang diterima akan ditolak oleh komite independen — hingga separuhnya pada 2021.
- Selama sembilan tahun ketika jumlah kiriman tumbuh sekitar 24 kali lipat (489 pada 2017, 11.663 pada 2025), studi ini tidak menemukan tren yang kokoh: deraunya tidak jelas bertambah ataupun berkurang. Penulis menekankan bahwa dengan data hanya sembilan tahun, ini adalah bukti yang menentang tren kuat, bukan bukti stabilitas.
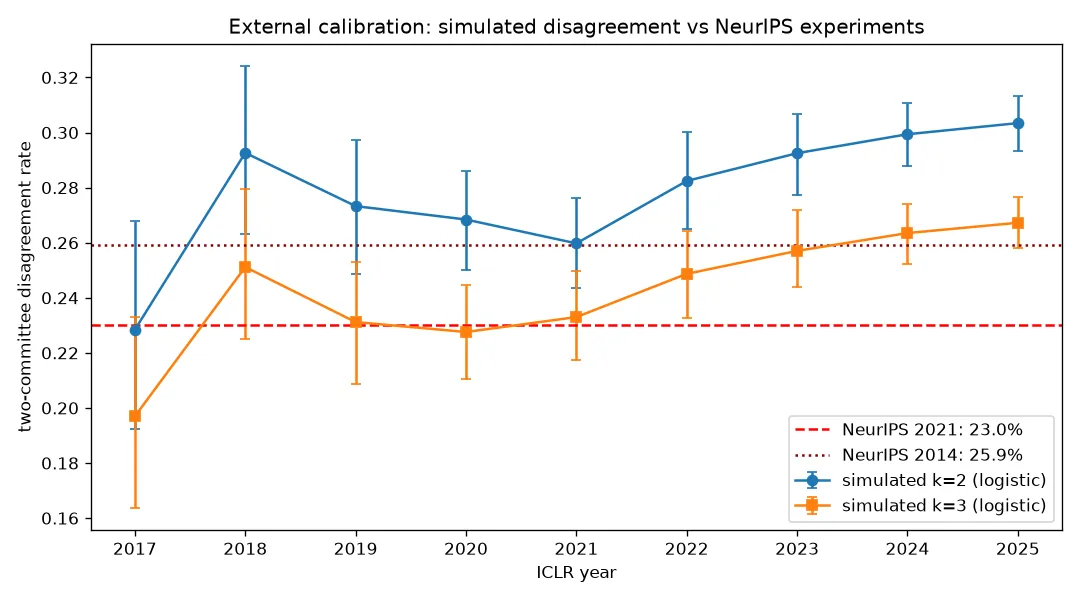
Ketidaksepakatan simulasi antara dua komite, dibandingkan dengan dua eksperimen NeurIPS yang sesungguhnya. — Gambar 3, Huang (2026), arXiv:2610.06591.
Skala itu sendiri menambah unsur kebetulan
Dua tahun menonjol. Pada 2020, ICLR memakai skala penilaian kasar empat tingkat (1, 3, 6, 8): 23,7 persen makalah menerima skor identik dari semua penelaahnya, dibandingkan 4,7 hingga 13,1 persen pada tahun-tahun lain. Untuk menguji efeknya, penulis mengambil skor 2021, yang diberikan dalam skala hingga 10, lalu mengodekannya ulang ke skala empat tingkat. Hasilnya: sekitar 8 persen sinyal hilang, ketidaksepakatan antarkomite naik sekitar 7 poin, dan porsi makalah diterima yang putusannya akan berbalik naik sekitar 11 poin. Skala yang kasar bukan sekadar memberi label baru pada pendapat yang sama; ia menambah unsur kebetulan.
2021 berbeda: skalanya halus, tetapi sinyalnya paling lemah dalam sembilan tahun itu, dan 30,4 persen makalah yang diterima berada tepat di atas ambang penerimaan. Banyak makalah di dekat garis batas, banyak derau: putusan mudah berbalik.
Lalu bagaimana dengan chatbot?
Studi ini berencana mencari perubahan perilaku penelaah setelah 2023, ketika model bahasa menyebar luas. Data publik tidak memuat teks telaah ataupun tingkat keyakinan penelaah setelah 2022, dan uji statistik yang tersedia hampir tidak punya daya. Karena itu penulis tidak menarik kesimpulan ke arah mana pun — dan menyajikan sikap menahan diri ini sebagai pilihan yang disengaja.
Mengaudit lotre
Metode ini hanya memerlukan skor dan keputusan, yang sudah dipublikasikan oleh beberapa konferensi. Konferensi mana pun dapat menghitung tingkat “lotre”-nya sendiri tanpa menggandakan satu telaah pun. Putusan penulis atas sembilan tahun ICLR: penelaahan tidak runtuh dan juga tidak membaik — tetap berderau pada tingkat yang kurang lebih sama. Studi ini hanya mencakup ICLR, dan penulisnya adalah seorang peneliti independen tunggal.