சக மதிப்பாய்வு எனும் அதிர்ஷ்டச் சீட்டு
அறிவியல் சக மதிப்பாய்வில் (peer review) இயங்குகிறது: ஒரு முடிவு வெளியிடப்படுவதற்கு முன், பிற வல்லுநர்கள் அதை மதிப்பிடுகின்றனர். பெரிய இயந்திரக் கற்றல் மாநாடுகளில், சில மதிப்பாய்வாளர்கள் ஒவ்வொரு சமர்ப்பிப்புக்கும் மதிப்பெண் தருகின்றனர்; கட்டுரை ஏற்கப்படுகிறது அல்லது நிராகரிக்கப்படுகிறது. இந்தச் சடங்குக்குப் பின்னால் ஓர் அசௌகரியமான கேள்வி இருக்கிறது. அதே கட்டுரையை வேறு மதிப்பாய்வாளர்களுக்கு அனுப்பினால், தீர்ப்பு அதுவாகவே இருக்குமா?
செலவுமிக்க இரண்டு சோதனைகள்
நேரடியான விடைகள், ஒரு மாநாடு சில கட்டுரைகளை இரண்டு சுயாதீனக் குழுக்களைக் கொண்டு இரண்டு முறை மதிப்பாய்வு செய்த இரண்டு சோதனைகளிலிருந்து மட்டுமே வருகின்றன. அவற்றின் முடிவுகளை ஆய்வுக்கட்டுரை நினைவுகூர்கிறது:
- NeurIPS 2014: இருமுறை மதிப்பாய்வு செய்யப்பட்ட 166 கட்டுரைகளில், 43-இல் இரண்டு குழுக்களும் முரண்பட்டன — 25.9 சதவீதம். ஒரு குழு ஏற்ற கட்டுரைகளில் ஏறக்குறைய பாதியை மற்றொன்று நிராகரித்திருக்கும்.
- NeurIPS 2021: 882 கட்டுரைகளில், குழுக்கள் 23.0 சதவீதத்தில் முரண்பட்டன.
இத்தகைய சோதனைகள் அரிதானவை, ஏனெனில் அவை செலவுமிக்கவை: நூற்றுக்கணக்கான கட்டுரைகளின் மதிப்பாய்வை இரட்டிப்பாக்க வேண்டும். சுயாதீன ஆய்வாளரான ஃபெய்லியன் ஹுவாங், அதே எண்ணை பொதுத் தரவிலிருந்து மட்டுமே மதிப்பிட முடியுமா என்று கேட்டார்.
இரண்டாவது குழுவை உருவகப்படுத்துதல்
இந்த ஆய்வு 2017 முதல் 2025 வரையிலான ICLR மாநாட்டின் பொது மதிப்பாய்வுகளைப் பயன்படுத்துகிறது: 36,113 கட்டுரைகள், 134,912 மதிப்பாய்வுகள். ஒரு புள்ளியியல் மாதிரி ஒவ்வொரு மதிப்பெண்ணையும் இரண்டு பகுதிகளாகப் பிரிக்கிறது: கட்டுரையின் மறைந்த தரம், ஒவ்வொரு மதிப்பாய்வாளரும் சேர்க்கும் “இரைச்சல்” (noise). இரண்டாவது மாதிரி மதிப்பெண்கள் எப்படி முடிவுகளாக மாறுகின்றன என்பதை மீளுருவாக்குகிறது. பின்னர் கணினி, ஒவ்வொரு கட்டுரைக்கும் இரண்டு, மூன்று அல்லது நான்கு மதிப்பாய்வாளர்கள் கொண்ட இரண்டு சுயாதீனக் குழுக்களை ஆயிரம் முறை கற்பனை செய்து, அவை எத்தனை முறை முரண்படுகின்றன என்று எண்ணுகிறது.
முடிவை நம்புவதற்கு முன், ஆசிரியர் அதை இரண்டு முறை சரிபார்த்தார். NeurIPS 2021 சோதனையுடன் ஒப்பிடும்போது, அங்கே இருந்தது போலவே ஒரு கட்டுரைக்கு மூன்று மதிப்பாய்வாளர்களுடன், அளவிடப்பட்ட 23.0 சதவீதத்துக்கு எதிராக உருவகப்படுத்தல் 23.3 சதவீதம் முரண்பாட்டைத் தருகிறது. மேலும், குறைந்தது நான்கு மதிப்பாய்வுகள் கொண்ட ICLR கட்டுரைகளில், உண்மையான மதிப்பாய்வாளர்களைச் சீரற்ற இரண்டு ஜோடிகளாகப் பிரித்தாலே, 2018-இலும் 2021 முதல் 2025 வரை ஒவ்வொரு ஆண்டிலும், ஒரு புள்ளிக்குள் மாதிரியின் அதே விடை கிடைக்கிறது.
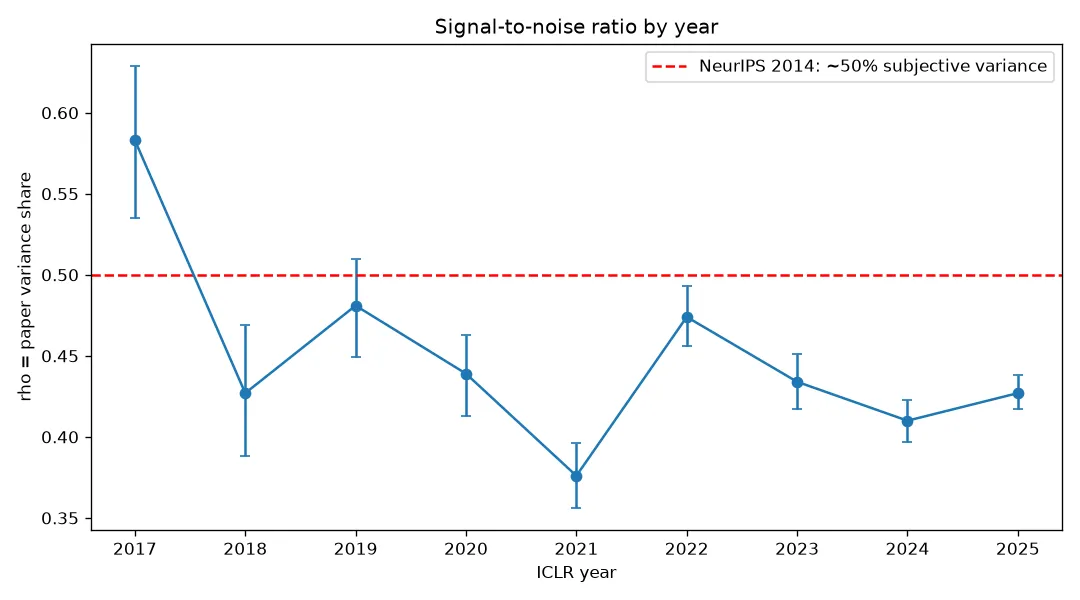
மதிப்பெண் மாறுபாட்டில் கட்டுரையிலிருந்தே வரும் பங்கு, ஆண்டுவாரியாக: ஏறக்குறைய பாதி; மீதி மதிப்பாய்வாளர் இரைச்சல். — படம் 2, Huang (2026), arXiv:2610.06591.
ஏறக்குறைய நான்கில் ஒரு கட்டுரை
மதிப்பெண் மாறுபாட்டில் கட்டுரையிலிருந்தே வரும் பங்கு, ஆண்டைப் பொறுத்து 0.38 முதல் 0.58 வரை — மீதி மதிப்பாய்வாளர் இரைச்சல்; இது 2014-இன் ஏறக்குறைய பாதி என்ற மதிப்பீட்டுடன் ஒத்துப்போகிறது. விளைவுகள்:
- ஒரு குழுவுக்கு இரண்டு மதிப்பாய்வாளர்கள் இருந்தால், 22.8 சதவீதம் (2017) முதல் 30.3 சதவீதம் (2025) கட்டுரைகளுக்கு முடிவு புரள்கிறது. நான்கு மதிப்பாய்வாளர்களுடன், 17.7 முதல் 24.2 சதவீதம்.
- ஏற்கப்பட்ட கட்டுரைகளில் 30 முதல் 50 சதவீதம் ஒரு சுயாதீனக் குழுவால் நிராகரிக்கப்பட்டிருக்கும் — 2021-இல் பாதி வரை.
- சமர்ப்பிப்புகள் சுமார் 24 மடங்கு பெருகிய ஒன்பது ஆண்டுகளில் (2017-இல் 489, 2025-இல் 11,663), ஆய்வு உறுதியான போக்கு எதையும் காணவில்லை: இரைச்சல் தெளிவாகக் கூடவும் இல்லை, குறையவும் இல்லை. ஒன்பது ஆண்டுத் தரவு மட்டுமே இருப்பதால், இது நிலைத்தன்மைக்கான நிரூபணம் அல்ல, வலுவான போக்குக்கு எதிரான சான்று என்று ஆசிரியர் வலியுறுத்துகிறார்.
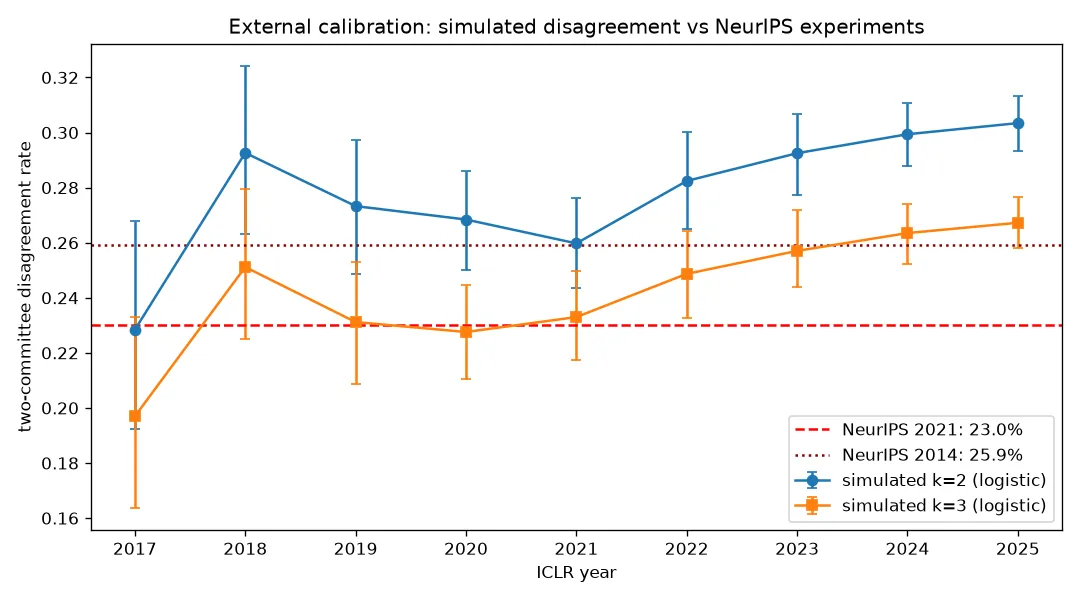
இரண்டு குழுக்களுக்கு இடையிலான உருவகப்படுத்தப்பட்ட முரண்பாடு, உண்மையான இரண்டு NeurIPS சோதனைகளுடன் ஒப்பிட்டு. — படம் 3, Huang (2026), arXiv:2610.06591.
அளவுகோலே அதிர்ஷ்டத்தைச் சேர்க்கிறது
இரண்டு ஆண்டுகள் தனித்து நிற்கின்றன. 2020-இல் ICLR நான்கு நிலைகள் கொண்ட கரடுமுரடான மதிப்பெண் அளவுகோலைப் (1, 3, 6, 8) பயன்படுத்தியது: பிற ஆண்டுகளில் 4.7 முதல் 13.1 சதவீதமாக இருந்ததற்கு எதிராக, 23.7 சதவீதம் கட்டுரைகள் தங்கள் எல்லா மதிப்பாய்வாளர்களிடமிருந்தும் ஒரே மதிப்பெண்ணைப் பெற்றன. விளைவைச் சோதிக்க, 10-க்கு வழங்கப்பட்ட 2021 மதிப்பெண்களை எடுத்து, நான்கு நிலை அளவுகோலில் ஆசிரியர் மறுகுறியீடு செய்தார். முடிவு: சமிக்ஞையில் சுமார் 8 சதவீதம் இழக்கப்படுகிறது, குழுக்களுக்கு இடையிலான முரண்பாடு சுமார் 7 புள்ளிகள் உயர்கிறது, ஏற்கப்பட்ட கட்டுரைகளில் புரளக்கூடியவற்றின் பங்கு சுமார் 11 புள்ளிகள் உயர்கிறது. கரடுமுரடான அளவுகோல் அதே கருத்துகளுக்கு வெறுமனே மறுபெயரிடுவதில்லை; அது அதிர்ஷ்டத்தைச் சேர்க்கிறது.
2021 வேறுபட்டது: நுணுக்கமான அளவுகோல், ஆனால் ஒன்பது ஆண்டுகளில் மிகப் பலவீனமான சமிக்ஞை; ஏற்கப்பட்ட கட்டுரைகளில் 30.4 சதவீதம் ஏற்பு வாசலுக்குச் சற்று மேலே இருந்தன. கோட்டுக்கு அருகில் நிறையக் கட்டுரைகள், ஏராளமான இரைச்சல்: எளிதான புரட்டல்கள்.
அப்படியென்றால் உரையாடல் இயலிகள் (chatbots)?
மொழி மாதிரிகள் பரவிய 2023-க்குப் பிறகு மதிப்பாய்வு நடத்தையில் ஏற்பட்ட மாற்றத்தைத் தேட ஆய்வு திட்டமிட்டிருந்தது. 2022-க்குப் பிறகான பொதுத் தரவில் மதிப்பாய்வு உரையோ மதிப்பாய்வாளர் நம்பிக்கை அளவோ இல்லை; கிடைக்கும் புள்ளியியல் சோதனைக்குக் கிட்டத்தட்ட வலு இல்லை. எனவே ஆசிரியர் எந்தத் திசையிலும் முடிவு எடுக்கவில்லை — அந்தக் கட்டுப்பாட்டை வேண்டுமென்றே செய்ததாக முன்வைக்கிறார்.
அதிர்ஷ்டச் சீட்டைத் தணிக்கை செய்தல்
இந்த முறைக்கு மதிப்பெண்களும் முடிவுகளும் மட்டுமே தேவை; பல மாநாடுகள் அவற்றை ஏற்கனவே வெளியிடுகின்றன. அவற்றில் எதுவும், ஒரு மதிப்பாய்வைக்கூட இரட்டிப்பாக்காமல், தன் சொந்த “அதிர்ஷ்டச் சீட்டு” வீதத்தைக் கணக்கிடலாம். ICLR-இன் ஒன்பது ஆண்டுகள் குறித்த ஆசிரியரின் தீர்ப்பு: மதிப்பாய்வு சரியவும் இல்லை, மேம்படவும் இல்லை — ஏறக்குறைய அதே அளவில் இரைச்சலுடனேயே இருக்கிறது. இந்த ஆய்வு ICLR-ஐ மட்டுமே உள்ளடக்குகிறது; அதன் ஆசிரியர் ஒரே ஒரு சுயாதீன ஆய்வாளர்.