LA LOTERIE DE LA RELECTURE PAR LES PAIRS
La science repose sur la relecture par les pairs : avant qu’un résultat soit publié, d’autres experts le jugent. Dans les grandes conférences d’apprentissage automatique, une poignée de relecteurs notent chaque soumission, et l’article est accepté ou rejeté. Derrière ce rituel se cache une question gênante. Envoyez le même article à d’autres relecteurs : le verdict serait-il le même ?
Deux expériences coûteuses
Les seules réponses directes viennent de deux expériences où une conférence a fait relire certains articles deux fois, par deux comités indépendants. L’article rappelle leurs résultats :
- NeurIPS 2014 : sur 166 articles relus deux fois, les deux comités étaient en désaccord sur 43 — 25,9 %. Environ la moitié des articles acceptés par un comité auraient été rejetés par l’autre.
- NeurIPS 2021 : sur 882 articles, les comités étaient en désaccord pour 23,0 %.
Ces expériences sont rares parce qu’elles coûtent cher : il faut doubler la relecture de centaines d’articles. Feilian Huang, qui signe l’étude sans affiliation institutionnelle, a cherché à savoir si l’on pouvait estimer le même chiffre avec les seules données publiques.
Simuler un second comité
L’étude utilise les relectures publiques de la conférence ICLR de 2017 à 2025 : 36 113 articles et 134 912 relectures. Un modèle statistique décompose chaque note en deux parts : la qualité cachée de l’article, et le « bruit » ajouté par chaque relecteur. Un second modèle reproduit la façon dont les notes deviennent des décisions. L’ordinateur imagine alors, pour chaque article, deux comités indépendants de deux, trois ou quatre relecteurs, mille fois de suite, et compte combien de fois ils divergent.
Avant de se fier au résultat, l’étude le vérifie deux fois. Face à l’expérience NeurIPS 2021, avec trois relecteurs par article comme alors, la simulation donne 23,3 % de désaccord pour 23,0 % mesurés. Et sur les articles d’ICLR ayant au moins quatre relectures, couper simplement les vrais relecteurs en deux paires au hasard donne la même réponse que le modèle, à un point près, en 2018 et chaque année de 2021 à 2025.
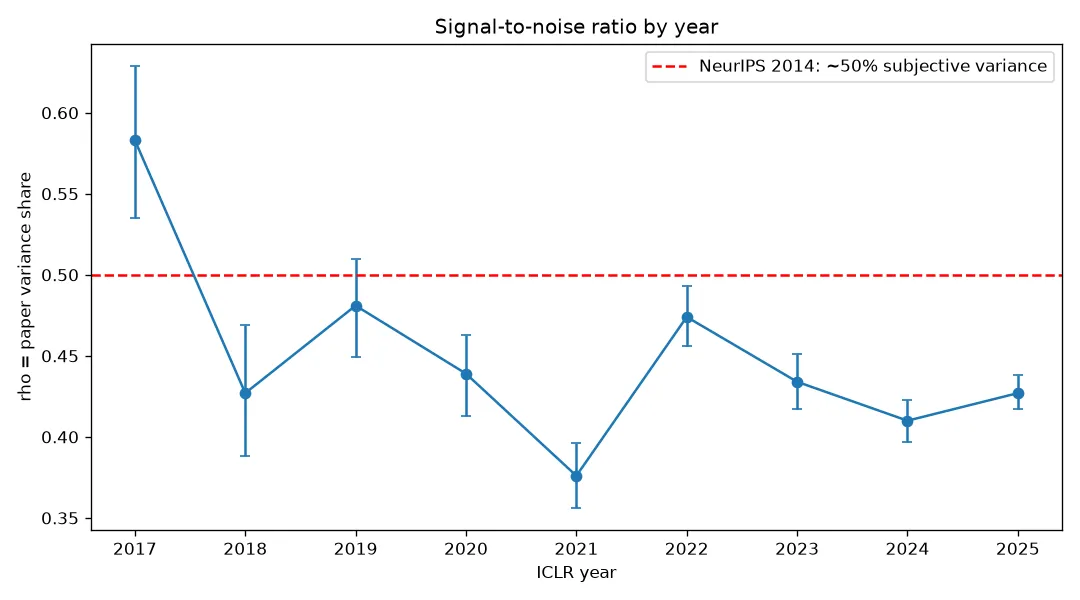
Part de la variance des notes due à l’article lui-même, année par année : environ la moitié, le reste est le bruit des relecteurs. — Figure 2, Huang (2026), arXiv:2610.06591.
Environ un article sur quatre
La part de la variation des notes qui vient de l’article lui-même va de 0,38 à 0,58 selon les années — le reste est le bruit des relecteurs, en accord avec l’estimation de 2014 d’environ la moitié. Les conséquences :
- Avec deux relecteurs par comité, la décision s’inverse pour 22,8 % (2017) à 30,3 % (2025) des articles. Avec quatre relecteurs, 17,7 à 24,2 %.
- 30 à 50 % des articles acceptés auraient été rejetés par un comité indépendant — jusqu’à la moitié en 2021.
- Sur neuf ans, pendant lesquels les soumissions ont été multipliées par 24 environ (489 en 2017, 11 663 en 2025), l’étude ne trouve aucune tendance robuste : le bruit ne grandit ni ne diminue nettement. L’étude souligne qu’avec seulement neuf années de données, c’est un argument contre une forte tendance, pas une preuve de stabilité.
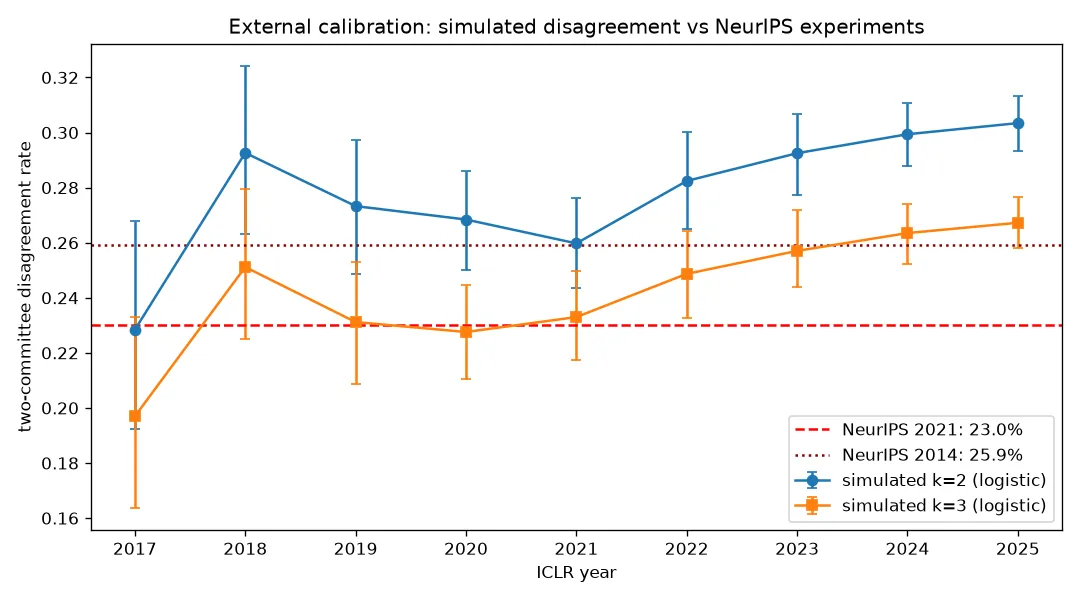
Désaccord simulé entre deux comités, comparé aux deux vraies expériences de NeurIPS. — Figure 3, Huang (2026), arXiv:2610.06591.
L’échelle elle-même ajoute du hasard
Deux années sortent du lot. En 2020, ICLR notait sur une échelle grossière à quatre niveaux (1, 3, 6, 8) : 23,7 % des articles ont reçu la même note de tous leurs relecteurs, contre 4,7 à 13,1 % les autres années. Pour tester l’effet, Feilian Huang a pris les notes de 2021, données sur 10, et les a recodées sur l’échelle à quatre niveaux. Résultat : environ 8 % du signal est perdu, le désaccord entre comités augmente d’environ 7 points, et la part des articles acceptés qui basculeraient augmente d’environ 11 points. Une échelle grossière ne se contente pas de renommer les mêmes opinions : elle ajoute du hasard.
2021 est différent : une échelle fine, mais le signal le plus faible des neuf années, et 30,4 % des articles acceptés juste au-dessus du seuil d’acceptation. Beaucoup d’articles près de la ligne, beaucoup de bruit : les bascules sont faciles.
Et les chatbots ?
L’étude prévoyait de chercher un changement dans le comportement des relecteurs après 2023, quand les modèles de langage se sont répandus. Les données publiques ne contiennent ni texte de relecture ni niveau de confiance après 2022, et le test statistique disponible n’a presque aucune puissance. L’étude ne tire donc aucune conclusion, dans un sens ni dans l’autre — et présente cette retenue comme un choix délibéré.
Auditer la loterie
La méthode n’a besoin que des notes et des décisions, que plusieurs conférences publient déjà. N’importe laquelle pourrait calculer son propre taux de « loterie » sans doubler une seule relecture. Le verdict de l’étude sur neuf ans d’ICLR : la relecture ne s’effondre pas et ne s’améliore pas — elle reste bruitée, à peu près au même niveau. L’étude ne porte que sur ICLR, et elle est signée par une seule personne, sans institution.