同行评审的彩票
科学依靠同行评审运转:一项成果发表之前,要由其他专家来评判。在大型机器学习会议上,几位审稿人给每篇投稿打分,论文随之被接收或被拒。在这一仪式背后,隐藏着一个令人不安的问题。把同一篇论文交给另一批审稿人,结论还会一样吗?
两项昂贵的实验
唯一的直接答案来自两项实验:会议让两个独立的委员会把部分论文评审两遍。论文回顾了它们的结果:
- NeurIPS 2014:在166篇被双重评审的论文中,两个委员会在43篇上意见不一——占25.9%。被一个委员会接收的论文中,大约一半会被另一个委员会拒绝。
- NeurIPS 2021:在882篇论文中,委员会的分歧率为23.0%。
这类实验很少见,因为成本高昂:意味着要把数百篇论文的评审工作翻倍。独立研究者Feilian Huang提出疑问:能否仅凭公开数据估算出同样的数字?
模拟第二个委员会
这项研究使用了ICLR会议2017年至2025年的公开评审:36113篇论文和134912份评审意见。一个统计模型把每个评分分成两部分:论文的隐藏质量,以及每位审稿人带来的“噪声”。第二个模型再现了评分如何转化为决定。然后,计算机为每篇论文设想两个独立的委员会,每个委员会由两名、三名或四名审稿人组成,重复一千次,统计它们意见不一的频率。
在信任这个结果之前,作者对它做了两次检验。与NeurIPS 2021实验对照、采用同样的每篇三名审稿人,模拟给出的分歧率为23.3%,而实测为23.0%。对于至少有四份评审的ICLR论文,只需把真实的审稿人随机分成两对,在2018年以及2021年至2025年的每一年,得到的答案都与模型相差不到一个百分点。
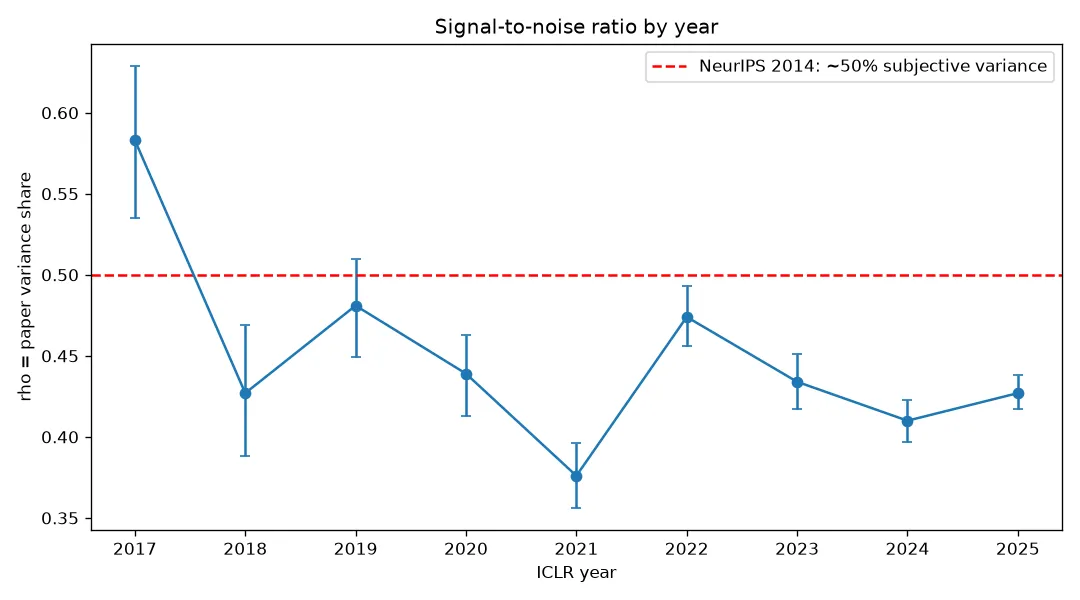
逐年来看,评分方差中由论文本身造成的比例:约为一半,其余是审稿人噪声。——图2,Huang (2026),arXiv:2610.06591。
大约四篇中有一篇
评分变化中来自论文本身的比例,因年份不同在0.38到0.58之间——其余是审稿人噪声,与2014年约一半的估计一致。其后果是:
- 每个委员会两名审稿人时,**22.8%(2017年)至30.3%(2025年)**的论文决定会翻转。四名审稿人时,为17.7%至24.2%。
- 30%至50%被接收的论文会被一个独立委员会拒绝——2021年高达一半。
- 在投稿量增长约24倍的九年里(2017年489篇,2025年11663篇),研究没有发现稳健的趋势:噪声既没有明显增加,也没有明显减少。作者强调,由于只有九年的数据,这只是反对存在强趋势的证据,而不能证明其稳定不变。
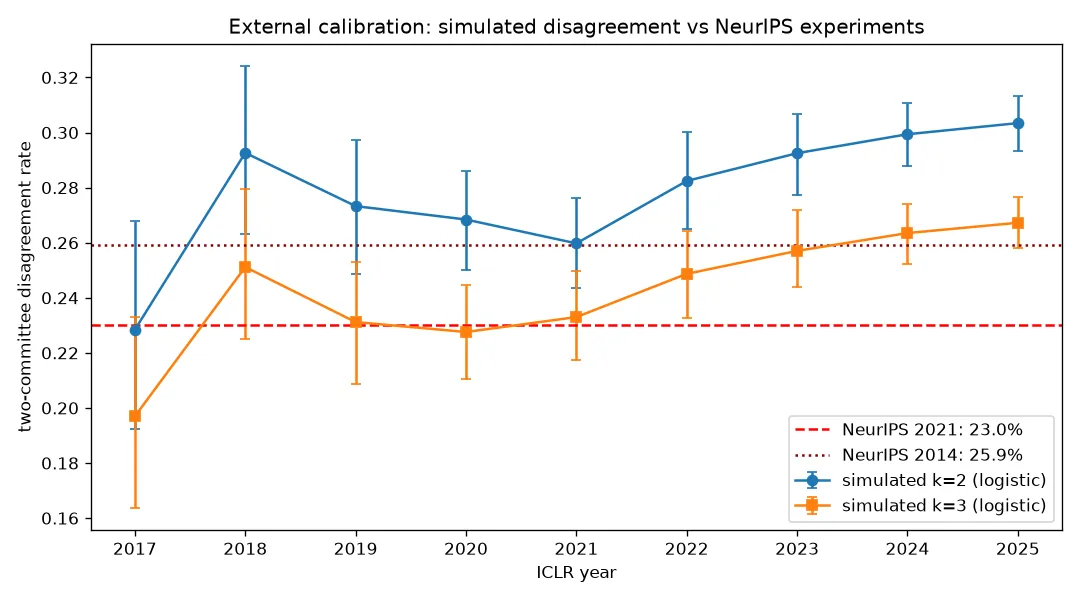
两个委员会之间的模拟分歧,与两次真实的NeurIPS实验对比。——图3,Huang (2026),arXiv:2610.06591。
量表本身就增加了偶然性
有两年格外突出。2020年,ICLR使用了一个粗糙的四级评分量表(1、3、6、8):23.7%的论文从所有审稿人那里得到了相同的分数,而其他年份为4.7%至13.1%。为了检验这一影响,作者把2021年满分10分的评分按四级量表重新编码。结果:约8%的信号丢失,委员会之间的分歧增加约7个百分点,被接收论文中会翻转的比例增加约11个百分点。粗糙的量表不只是给同样的意见换个标签,它还增加了偶然性。
2021年则不同:量表很精细,但信号是九年中最弱的,而且**30.4%**被接收的论文恰好刚刚越过接收门槛。大量论文挤在分界线附近,噪声又多:决定很容易翻转。
那聊天机器人呢?
研究原计划考察2023年语言模型普及之后审稿行为是否发生变化。但公开数据在2022年之后不包含评审文本和审稿人置信度,而可用的统计检验几乎没有检验效能。因此,作者不作任何方向的结论——并表示这种克制是有意为之。
审计这场彩票
该方法只需要评分和决定,而好几个会议已经公开了这些数据。任何一个会议都可以计算自己的“彩票”率,无需重复任何一份评审。作者对ICLR九年的结论是:评审既没有崩溃,也没有改善——它一直维持在大致相同的噪声水平。这项研究只涵盖ICLR,作者是一位独立研究者。