DIE GUTACHTER-LOTTERIE
Die Wissenschaft lebt von der Begutachtung durch Fachkollegen (Peer Review): Bevor ein Ergebnis veröffentlicht wird, beurteilen es andere Fachleute. Bei den großen Konferenzen zum maschinellen Lernen bewertet eine Handvoll Gutachter jede Einreichung, und die Arbeit wird angenommen oder abgelehnt. Hinter diesem Ritual steht eine unbequeme Frage. Schickt man dieselbe Arbeit an andere Gutachter – wäre das Urteil dasselbe?
Zwei teure Experimente
Die einzigen direkten Antworten stammen aus zwei Experimenten, bei denen eine Konferenz einige Arbeiten zweimal begutachten ließ, von zwei unabhängigen Komitees. Die Arbeit ruft ihre Ergebnisse in Erinnerung:
- NeurIPS 2014: Bei 166 doppelt begutachteten Arbeiten waren sich die beiden Komitees bei 43 uneinig – 25,9 Prozent. Etwa die Hälfte der von einem Komitee angenommenen Arbeiten wäre vom anderen abgelehnt worden.
- NeurIPS 2021: Bei 882 Arbeiten waren sich die Komitees in 23,0 Prozent der Fälle uneinig.
Solche Experimente sind selten, weil sie teuer sind: Sie bedeuten, die Begutachtung Hunderter Arbeiten zu verdoppeln. Feilian Huang, ein unabhängiger Forscher, fragte sich, ob sich dieselbe Zahl allein aus öffentlichen Daten schätzen lässt.
Ein zweites Komitee simulieren
Die Studie nutzt die öffentlichen Gutachten der Konferenz ICLR von 2017 bis 2025: 36.113 Arbeiten und 134.912 Gutachten. Ein statistisches Modell zerlegt jede Bewertung in zwei Teile: die verborgene Qualität der Arbeit und das „Rauschen”, das jeder Gutachter hinzufügt. Ein zweites Modell bildet nach, wie Bewertungen zu Entscheidungen werden. Der Computer stellt sich dann für jede Arbeit zwei unabhängige Komitees aus zwei, drei oder vier Gutachtern vor, tausendmal hintereinander, und zählt, wie oft sie sich uneinig sind.
Bevor er dem Ergebnis traute, prüfte der Autor es zweimal. Gegenüber dem Experiment NeurIPS 2021, mit drei Gutachtern pro Arbeit wie dort, liefert die Simulation 23,3 Prozent Uneinigkeit gegenüber gemessenen 23,0 Prozent. Und bei ICLR-Arbeiten mit mindestens vier Gutachten liefert eine einfache Aufteilung der echten Gutachter in zwei zufällige Paare dasselbe Ergebnis wie das Modell, auf einen Punkt genau, 2018 und in jedem Jahr von 2021 bis 2025.
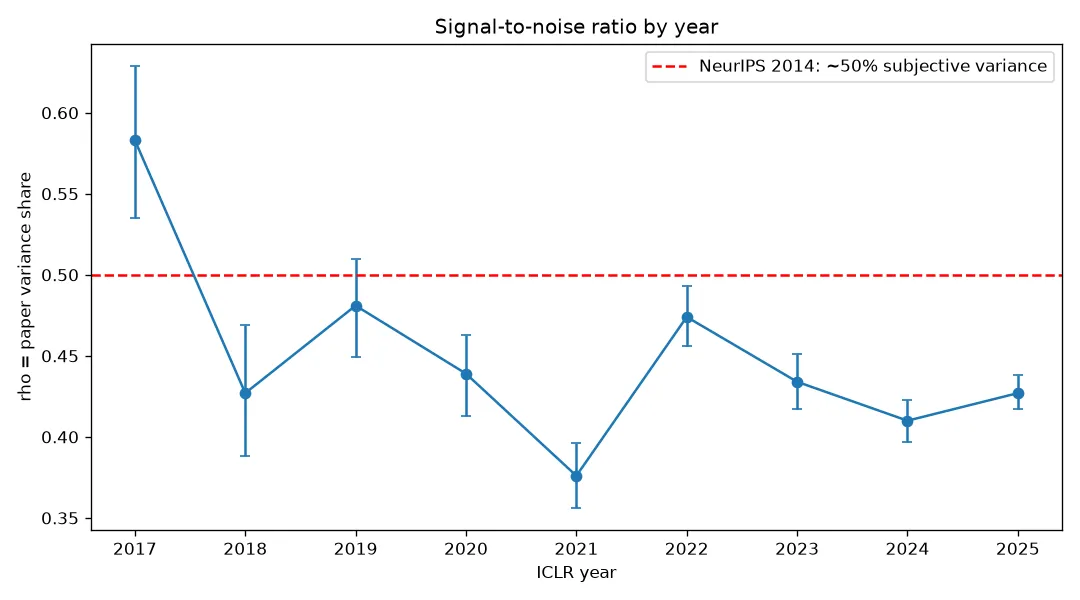
Anteil der Bewertungsvarianz, der auf die Arbeit selbst zurückgeht, Jahr für Jahr: etwa die Hälfte, der Rest ist Gutachterrauschen. – Abbildung 2, Huang (2026), arXiv:2610.06591.
Etwa eine Arbeit von vier
Der Anteil der Bewertungsschwankung, der von der Arbeit selbst stammt, reicht je nach Jahr von 0,38 bis 0,58 – der Rest ist Gutachterrauschen, im Einklang mit der Schätzung von 2014 von etwa der Hälfte. Die Folgen:
- Mit zwei Gutachtern pro Komitee kippt die Entscheidung bei 22,8 Prozent (2017) bis 30,3 Prozent (2025) der Arbeiten. Mit vier Gutachtern bei 17,7 bis 24,2 Prozent.
- 30 bis 50 Prozent der angenommenen Arbeiten wären von einem unabhängigen Komitee abgelehnt worden – 2021 bis zur Hälfte.
- Über neun Jahre, in denen die Einreichungen etwa um das 24-Fache wuchsen (489 im Jahr 2017, 11.663 im Jahr 2025), findet die Studie keinen robusten Trend: Das Rauschen wächst weder klar noch schrumpft es. Der Autor betont, dass dies bei nur neun Jahren an Daten ein Beleg gegen einen starken Trend ist, kein Beweis für Stabilität.
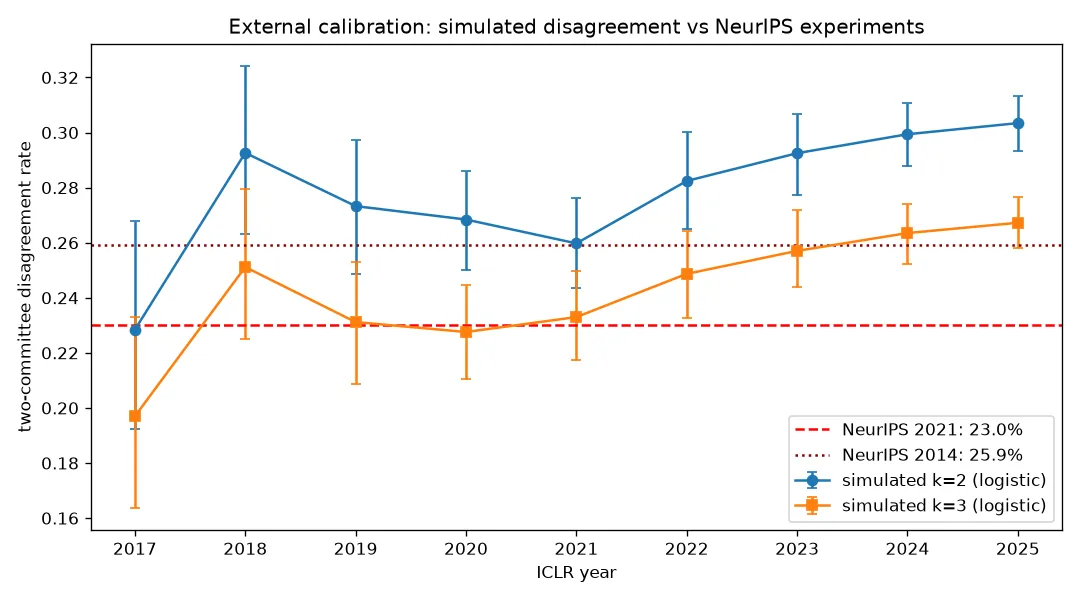
Simulierte Uneinigkeit zwischen zwei Komitees, verglichen mit den beiden echten NeurIPS-Experimenten. – Abbildung 3, Huang (2026), arXiv:2610.06591.
Die Skala selbst fügt Zufall hinzu
Zwei Jahre fallen auf. 2020 nutzte ICLR eine grobe vierstufige Bewertungsskala (1, 3, 6, 8): 23,7 Prozent der Arbeiten erhielten von allen ihren Gutachtern identische Bewertungen, gegenüber 4,7 bis 13,1 Prozent in anderen Jahren. Um den Effekt zu testen, nahm der Autor die Bewertungen von 2021, vergeben auf einer Skala bis 10, und kodierte sie auf die vierstufige Skala um. Ergebnis: Etwa 8 Prozent des Signals gehen verloren, die Uneinigkeit zwischen Komitees steigt um etwa 7 Punkte, und der Anteil angenommener Arbeiten, deren Urteil kippen würde, steigt um etwa 11 Punkte. Eine grobe Skala etikettiert nicht einfach dieselben Meinungen um; sie fügt Zufall hinzu.
2021 ist anders: eine feine Skala, aber das schwächste Signal der neun Jahre, und 30,4 Prozent der angenommenen Arbeiten lagen knapp über der Annahmeschwelle. Viele Arbeiten nahe der Grenze, viel Rauschen: leichte Kipppunkte.
Und Chatbots?
Die Studie hatte vor, nach einer Veränderung des Begutachtungsverhaltens nach 2023 zu suchen, als sich Sprachmodelle verbreiteten. Die öffentlichen Daten enthalten nach 2022 keinen Gutachtentext und keine Angabe zur Sicherheit der Gutachter, und der verfügbare statistische Test hat fast keine Aussagekraft. Der Autor zieht daher in keine Richtung einen Schluss – und stellt diese Zurückhaltung als bewusst dar.
Die Lotterie prüfen
Die Methode braucht nur Bewertungen und Entscheidungen, die mehrere Konferenzen bereits veröffentlichen. Jede von ihnen könnte ihre eigene „Lotterie”-Rate berechnen, ohne ein einziges Gutachten zu verdoppeln. Das Urteil des Autors über neun Jahre ICLR: Die Begutachtung bricht weder zusammen, noch verbessert sie sich – sie bleibt in etwa gleichem Maß verrauscht. Die Studie umfasst nur ICLR, und ihr Autor ist ein einzelner unabhängiger Forscher.