ثلاثون ذكاءً اصطناعيًا، وخطأ واحد
تقول حكمة الجماعة، وهي فكرة تعيدها الورقة إلى غالتون عام 1907: خذ متوسط تخمينات مستقلة كثيرة، فتلغي الأخطاء بعضها بعضًا. فإذا كانت الأخطاء خالية من الانحياز ومستقلة، يتقلص خطأ المتوسط بنسبة واحد على الجذر التربيعي لعدد التخمينات. وتستند أنظمة كثيرة تجمع عدة نماذج لغوية للذكاء الاصطناعي — بأخذ العيّنات والتصويت، أو بالنقاش، أو بلجان من نماذج مختلفة — إلى هذه الحجة: يمكن لفريق أكبر أن يحل محل وكيل أفضل.
وفي رأي Carolina Fortuna وBlaž Bertalanič، من معهد يوجيف ستيفان في ليوبليانا، فإن الحجة لا تصح إلا بقدر صحة مقدماتها، ومن هنا جاء اختبارهما لهذه المقدمات.
أسئلة فيرمي منصةً للاختبار
تسأل أسئلة فيرمي عن كميات لا يمكن إلا تقديرها، مثل عدد الأشياء التي تتسع لها حاوية. وإجاباتها أرقام تمتد عبر مراتب عشرية كثيرة، لذا يمكن قياس الخطأ بـالمراتب العشرية (orders of magnitude) — فعامل عشرة يُحسب مرتبة واحدة — ويمكن للأخطاء ذات الإشارات المتعاكسة أن يلغي بعضها بعضًا فعلًا.
جمع الفريق 2.51 مليون إجابة من 15 نموذجًا مفتوح الأوزان (open-weight models)، تتراوح بين 3 و72 مليار معامل، عن أسئلة معيار realFP البالغ عددها 529، وتحقق من النتائج على مجموعتين أخريين من الأسئلة. وأجاب كل نموذج عن كل سؤال نحو 350 مرة، وأُخذ متوسط فرق من 2 إلى 30 إجابة على مقياس لوغاريتمي.
والنماذج وحدها ضعيفة في هذه اللعبة. فالإجابة الواحدة تصيب المرتبة العشرية الصحيحة في 12 إلى 34% من الأسئلة، وتخطئ بأكثر من عامل مئة في 30 إلى 63% منها.
الخطأ الذي تتقاسمه كل نسخة
الخطوة الحاسمة هي تقسيم خطأ كل إجابة إلى جزأين. الأول هو الخطأ الذي يرتكبه نموذج ما في سؤال معيّن، وتتقاسمه كل إجاباته عنه. والثاني هو الجزء العشوائي الذي يتغير من إجابة إلى أخرى. ولا يمكن أن يُلغى عند أخذ المتوسط إلا الجزء الثاني.
ويتبين أن الجزء الأول هو المهيمن. ففي realFP، يمثل وسيطًا قدره 0.906 من تباين الخطأ. وبمعلومية السؤال، تكون إجابتان من الفريق نفسه غير مترابطتين، كما يقتضي أخذ العيّنات المستقل؛ لكنهما تتقاسمان الخطأ نفسه.
وتحوّل الورقة ذلك إلى رقم واحد، بصيغة كلاسيكية تُعرف بأثر التصميم لكيش (design effect): العدد الفعلي للإجابات المستقلة في فريق من N هو N / (1 + (N − 1)ρ)، حيث ρ هي تلك الحصة المشتركة. ومع ρ = 0.906، يساوي فريق من ثلاثين 1.10 وكيل مستقل.
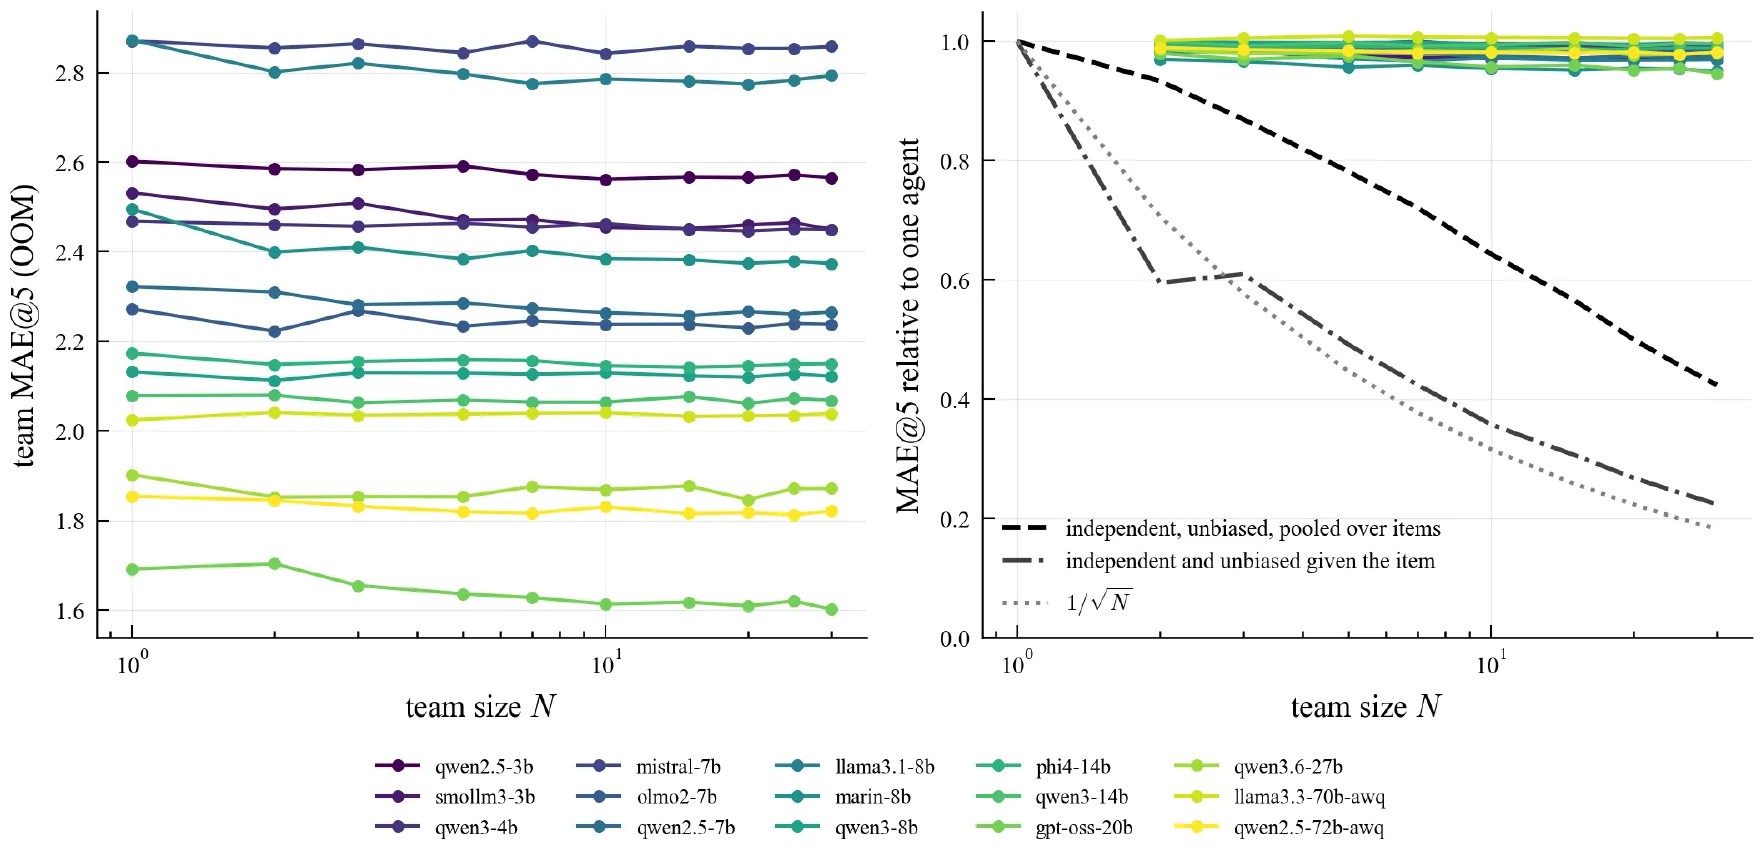
يسار: خطأ الفريق مقابل حجم الفريق N لـ15 نموذجًا. يمين: الشيء نفسه نسبةً إلى وكيل واحد (خطوط ملونة، قرب 1)، مقابل ما كانت ستعطيه إجابات مستقلة وخالية من الانحياز (خطوط سوداء متقطعة ومتقطعة منقّطة) ومعدل 1/√N (منقّط). — الشكل 2، Fortuna & Bertalanič (2026)، arXiv:2611.16315.
وعمليًا، خفّضت فرق الثلاثين خطأ الوكيل الواحد بوسيط قدره 1.7% فقط، وبـ5.4% على الأكثر. أما الإجابات المستقلة التي لا تحمل أيضًا أي خطأ مشترك في كل سؤال فكانت ستخفضه بنسبة 74 إلى 79%.
كل شيء ينجرف نحو مليون
لجزء من الخطأ المشترك شكل يمكن تمييزه. فكل نموذج يبالغ في تقدير الكميات الصغيرة ويبخس الكبيرة، ضاغطًا تقديراته باتجاه ما يقارب مليون (10⁶). ويظهر هذا الاتجاه في النماذج الـ15 كلها، لكنه لا يفسر إلا وسيطًا قدره 17% من الخطأ المشترك. وتخطئ النماذج أيضًا في الأسئلة نفسها وفي الاتجاه نفسه: إذ يظل الارتباط بين أخطاء نموذجين مختلفين لكل سؤال 0.60 إلى 0.69 بعد ترويض الحالات المتطرفة وإزالة الانجراف نحو مليون.
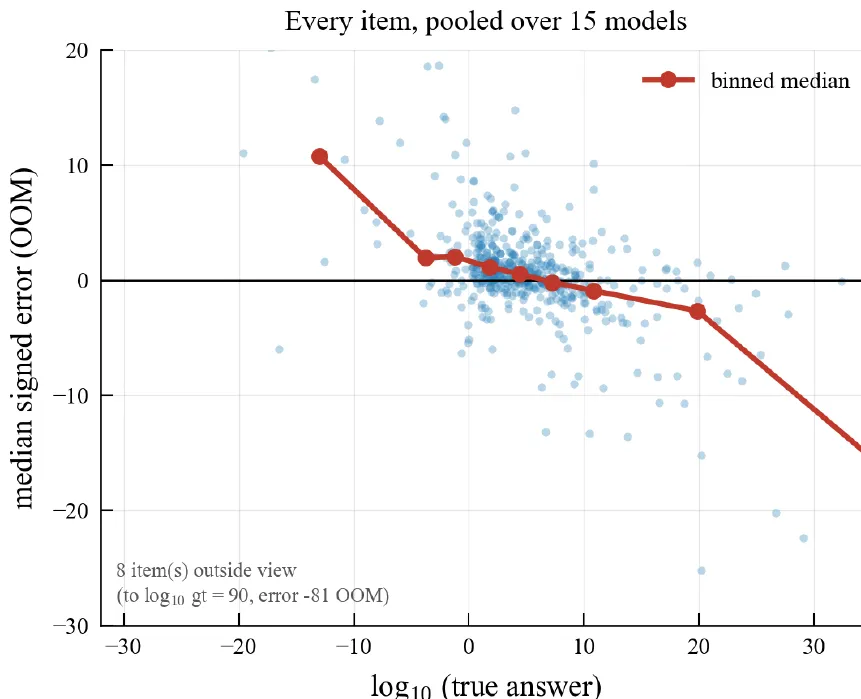
الخطأ الوسيط للنماذج الـ15 في كل سؤال، مقابل الإجابة الصحيحة (قوى العشرة): يُبالَغ في تقدير الكميات الصغيرة ويُبخَس تقدير الكبيرة. — الشكل 1 (يسار)، Fortuna & Bertalanič (2026)، arXiv:2611.16315.
النقاش لا يساعد
ماذا لو تناقش الوكلاء؟ في ثلاث جولات من النقاش، اطّلع كل وكيل على إجابات زملائه في الفريق وعدّل إجابته. فانهار التشتت داخل فرق الخمسة بنسبة 93% — وبحلول الجولة الثالثة، أعطى ثلاثة من خمسة وكلاء الرقم نفسه في نصف الأسئلة على الأقل، وذلك لدى 12 من النماذج الـ15. لكن الخطأ المشترك لم يتزحزح، وبلغ المكسب الإجمالي 2.1%، بكلفة حوسبة تعادل خمسة عشر ضعفًا. أما الوكلاء الذين اكتفوا بتعديل إجاباتهم من دون رؤية أقرانهم، فكان أداؤهم جيدًا بالقدر نفسه على الأقل.
ما ساعد قليلًا
رفعُ درجة حرارة أخذ العيّنات جعل الإجابات أكثر تنوعًا من دون أن يحسّن الفرق بأكثر من نحو 1%. وساعد مزج نماذج مختلفة أكثر: فخمسة نماذج متقاربة الدقة كان أداؤها معًا أفضل بنسبة 6.6% منه في فرقها الخاصة. ومع ذلك لم يتفوق أي مزيج من النماذج الـ15 تفوقًا ذا دلالة على فريق مبني من النموذج الأدق وحده، gpt-oss-20b. وأزال تصحيحٌ مُتعلَّم على أسئلة معروفة الإجابات الانحيازَ الإجمالي للنماذج، لكنه لم يُزل الخطأ الخاص بكل سؤال.
ويشدد الباحثان على حدود الدراسة: نماذج مفتوحة متواضعة الحجم، من دون أنماط «التفكير» الخاصة بها، على هذه المعايير والتعليمات؛ ولم تُختبر النماذج الرائدة ولا نماذج الاستدلال. وخلاصتهما درس في التصميم. فإضافة مزيد من الوكلاء، أو مزيد من الخلاف، لا تصلح خطأً تتقاسمه كل نسخة من النموذج. ويقترح الباحثان مهاجمة هذا الخطأ المشترك مباشرة، مثلًا بتزويد الوكلاء بمعلومات خاصة بكل سؤال — وهو سبيل لم يختبراه بعد.