تیس مصنوعی ذہانتیں، ایک غلطی
ہجوم کی دانش (wisdom of crowds)، ایک خیال جس کی جڑیں مقالہ 1907 میں Galton تک لے جاتا ہے، کہتی ہے: بہت سے آزاد اندازوں کی اوسط لیں، اور غلطیاں ایک دوسرے کو کاٹ دیں گی۔ اگر غلطیاں غیر متعصب (unbiased) اور آزاد ہوں، تو اوسط کی غلطی اندازوں کی تعداد کے جذرِ مربع کے مقلوب کی طرح گھٹتی ہے۔ بہت سے نظام جو مصنوعی ذہانت کے کئی لسانی ماڈلز (language models) کو یکجا کرتے ہیں — نمونے لے کر اور ووٹ ڈال کر، بحث کے ذریعے، یا مختلف ماڈلز کی کمیٹیوں کے ذریعے — اسی دلیل پر ٹیک لگاتے ہیں: ایک بڑی ٹیم ایک بہتر ایجنٹ کی جگہ لے سکتی ہے۔
Ljubljana کے Jožef Stefan Institute سے وابستہ Carolina Fortuna اور Blaž Bertalanič کے مطابق یہ دلیل اتنی ہی مضبوط ہے جتنے اس کے مقدمات (premises)، اور انہوں نے ان مقدمات کو جانچنے کا بیڑا اٹھایا۔
فرمی سوالات بطور آزمائشی میدان
فرمی سوالات ایسی مقداریں پوچھتے ہیں جن کا صرف اندازہ لگایا جا سکتا ہے، جیسے کسی برتن میں کتنی چیزیں سما سکتی ہیں۔ ان کے جوابات ایسے اعداد ہوتے ہیں جو وسعت کے کئی درجوں پر پھیلے ہوتے ہیں، اس لیے غلطی کو درجاتِ وسعت (orders of magnitude) میں ناپا جا سکتا ہے — دس گنا کا فرق ایک درجہ شمار ہوتا ہے — اور مخالف علامت والی غلطیاں واقعی ایک دوسرے کو کاٹ سکتی ہیں۔
ٹیم نے 2.51 ملین جوابات جمع کیے، جو 15 کھلے وزن والے ماڈلز (open-weight models) نے، جن کے پیرامیٹرز 3 سے 72 ارب تک ہیں، realFP بینچ مارک (benchmark) کے 529 سوالات پر دیے، اور نتائج کو سوالات کے دو دوسرے مجموعوں پر پرکھا۔ ہر ماڈل نے ہر سوال کا تقریباً 350 بار جواب دیا، اور 2 سے 30 جوابات کی ٹیموں کی اوسط لوگارتھمی پیمانے پر لی گئی۔
اپنے طور پر یہ ماڈلز اس کھیل میں کمزور ہیں۔ ایک اکیلا جواب 12 سے 34% سوالات پر درست درجۂ وسعت رکھتا ہے، اور 30 سے 63% سوالات پر سو گنا سے زیادہ غلط ہوتا ہے۔
وہ غلطی جو ہر نقل میں مشترک ہے
کلیدی قدم یہ ہے کہ ہر جواب کی غلطی کو دو حصوں میں تقسیم کیا جائے۔ ایک وہ غلطی ہے جو کوئی ماڈل کسی خاص سوال پر کرتا ہے، اور جو اس سوال کے اس کے تمام جوابات میں مشترک ہوتی ہے۔ دوسرا بے ترتیب حصہ ہے جو ایک جواب سے دوسرے تک بدلتا رہتا ہے۔ جوابات کی اوسط لینے پر صرف دوسرا حصہ ختم ہو سکتا ہے۔
پتا چلتا ہے کہ پہلا حصہ غالب ہے۔ realFP پر غلطی کے تغیر (variance) میں اس کا وسطانی (median) حصہ 0.906 ہے۔ سوال معلوم ہو تو ایک ہی ٹیم کے دو جوابات باہم غیر مربوط (uncorrelated) ہوتے ہیں، جیسا کہ آزاد نمونہ گیری کا تقاضا ہے؛ مگر ان میں ایک ہی غلطی مشترک ہوتی ہے۔
مقالہ اسے ایک واحد عدد میں بدل دیتا ہے، ایک کلاسیکی فارمولے کے ذریعے جو Kish کا ڈیزائن اثر (design effect) کہلاتا ہے: N جوابات کی ٹیم میں آزاد جوابات کی مؤثر تعداد N / (1 + (N − 1)ρ) ہے، جہاں ρ یہی مشترک حصہ ہے۔ ρ = 0.906 کے ساتھ، تیس کی ٹیم 1.10 آزاد ایجنٹوں کے برابر ہے۔
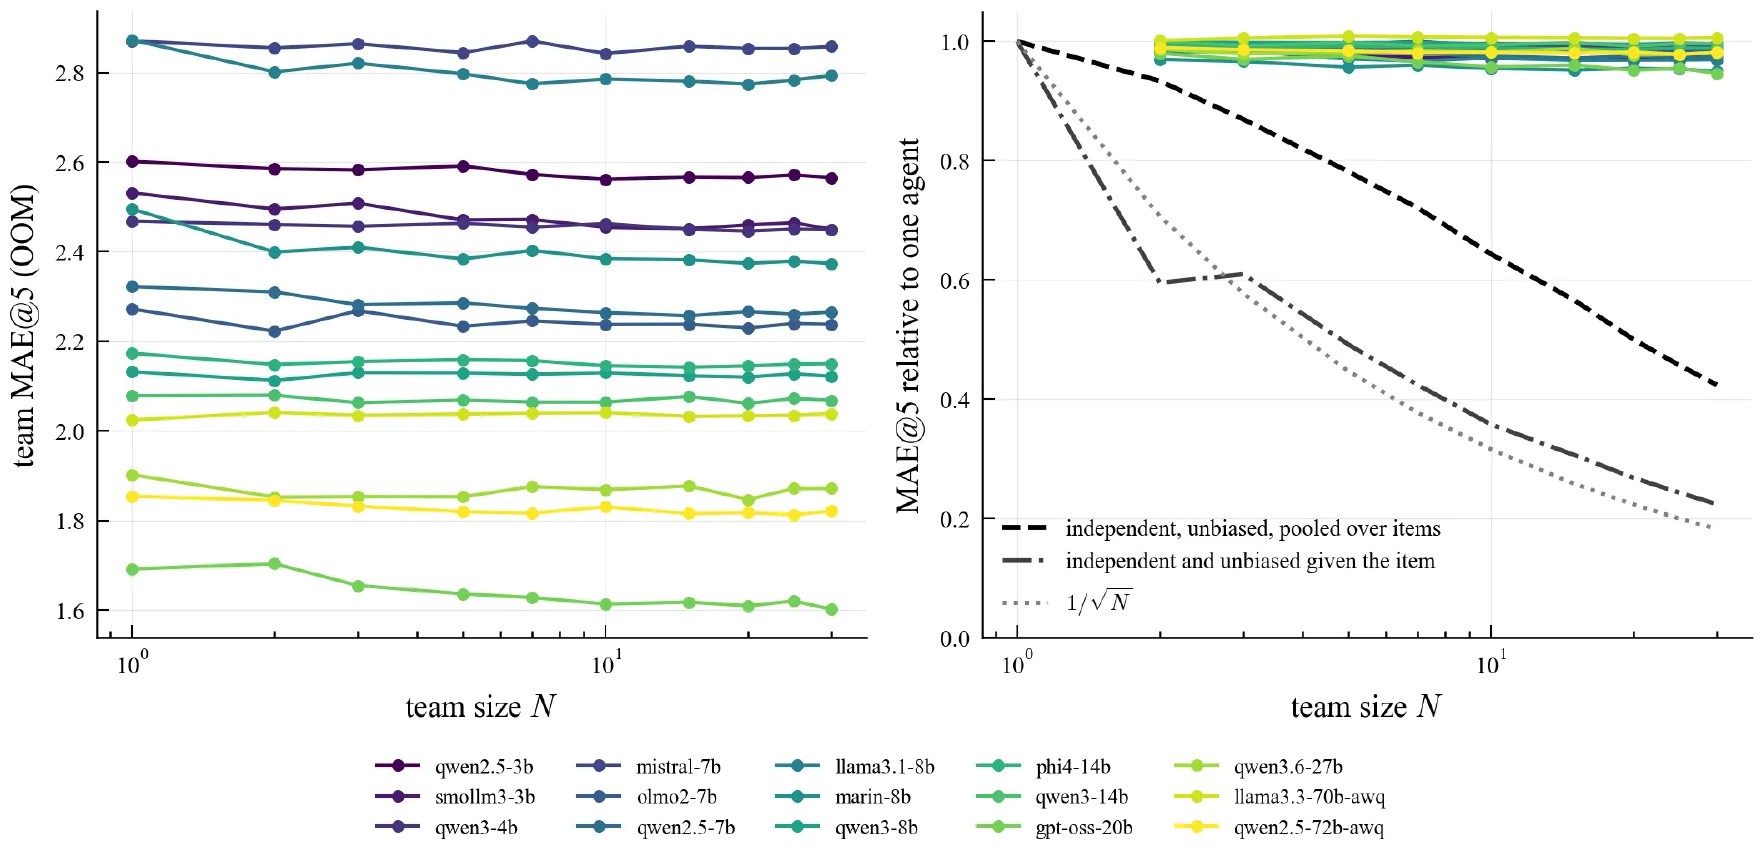
بائیں: 15 ماڈلز کے لیے ٹیم کے حجم N کے مقابلے میں ٹیم کی غلطی۔ دائیں: وہی ایک اکیلے ایجنٹ کی نسبت سے (رنگین لکیریں، 1 کے قریب)، اس کے مقابلے میں جو آزاد اور غیر متعصب جوابات دیتے (سیاہ ڈیش والی اور ڈیش-نقطہ لکیریں) اور 1/√N کی شرح (نقطہ دار)۔ — شکل 2، Fortuna & Bertalanič (2026)، arXiv:2611.16315۔
عملاً، تیس کی ٹیموں نے ایک اکیلے ایجنٹ کی غلطی میں وسطانی طور پر 1.7% کمی کی، اور زیادہ سے زیادہ 5.4%۔ اگر جوابات آزاد ہوتے اور ہر سوال پر کوئی مشترک غلطی بھی نہ رکھتے تو یہ کمی 74 سے 79% ہوتی۔
سب کچھ ایک ملین کی طرف کھسکتا ہے
مشترک غلطی کے ایک حصے کی شکل پہچانی جا سکتی ہے۔ ہر ماڈل چھوٹی مقداروں کا زیادہ اور بڑی مقداروں کا کم اندازہ لگاتا ہے، اور اپنے اندازوں کو تقریباً ایک ملین (10⁶) کی طرف سکیڑ دیتا ہے۔ یہ رجحان تمام 15 ماڈلز میں نظر آتا ہے، لیکن یہ مشترک غلطی کا وسطانی طور پر صرف 17% واضح کرتا ہے۔ ماڈلز ایک ہی سوالات پر ایک ہی سمت میں غلطی بھی کرتے ہیں: انتہائی صورتوں کو قابو میں لانے اور ایک ملین کی طرف اس کھسکاؤ کو نکال دینے کے بعد بھی، دو مختلف ماڈلز کی فی سوال غلطیوں کا باہمی ربط (correlation) 0.60 سے 0.69 ہے۔
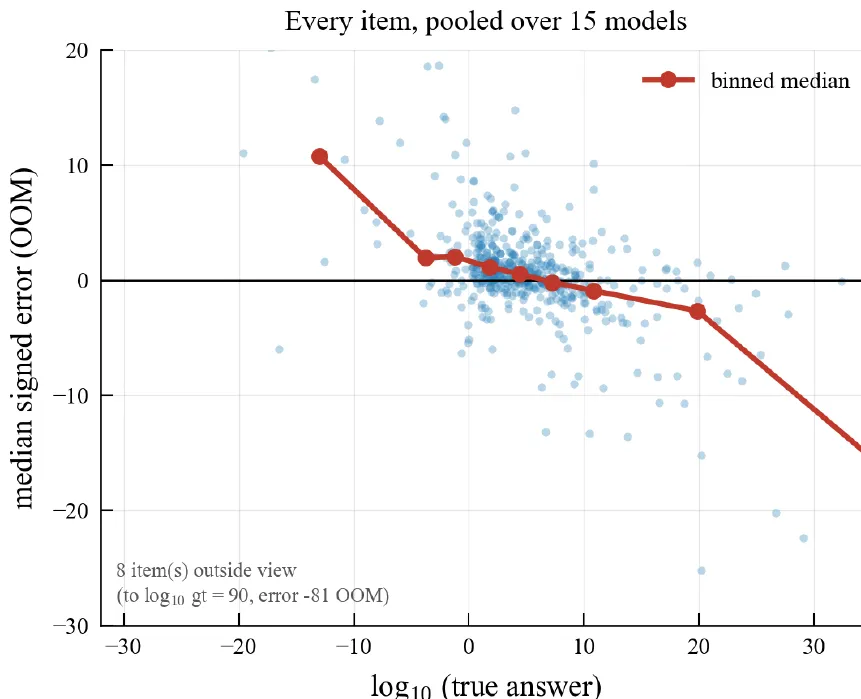
ہر سوال پر 15 ماڈلز کی وسطانی غلطی، حقیقی جواب (دس کی طاقتوں) کے مقابلے میں: چھوٹی مقداروں کا زیادہ اندازہ لگایا جاتا ہے، بڑی مقداروں کا کم۔ — شکل 1 (بائیں)، Fortuna & Bertalanič (2026)، arXiv:2611.16315۔
بات چیت سے مدد نہیں ملتی
اگر ایجنٹ آپس میں بحث کریں تو؟ بحث کے تین مرحلوں میں ہر ایجنٹ نے اپنے ساتھیوں کے جوابات دیکھے اور اپنے جواب پر نظرِ ثانی کی۔ پانچ کی ٹیموں کے اندر بکھراؤ 93% گھٹ گیا — تیسرے مرحلے تک، 15 میں سے 12 ماڈلز کے لیے، کم از کم آدھے سوالات پر پانچ میں سے تین ایجنٹوں نے ایک ہی عدد دیا۔ مگر مشترک غلطی اپنی جگہ سے نہیں ہلی، اور کل فائدہ 2.1% رہا، پندرہ گنا کمپیوٹنگ لاگت پر۔ جن ایجنٹوں نے ساتھیوں کو دیکھے بغیر صرف اپنے جواب پر نظرِ ثانی کی، انہوں نے کم از کم اتنی ہی اچھی کارکردگی دکھائی۔
جس چیز سے تھوڑی مدد ملی
نمونہ گیری کا درجۂ حرارت (sampling temperature) بڑھانے سے جوابات زیادہ متنوع ہو گئے، مگر ٹیموں میں تقریباً 1% سے زیادہ بہتری نہیں آئی۔ مختلف ماڈلز کو ملانے سے زیادہ مدد ملی: ملتی جلتی درستی والے پانچ ماڈلز نے مل کر اپنی اپنی ٹیموں کے مقابلے میں 6.6% بہتر کارکردگی دکھائی۔ پھر بھی 15 ماڈلز کا کوئی بھی آمیزہ اس ٹیم سے نمایاں طور پر بہتر نہیں رہا جو سب سے درست واحد ماڈل، gpt-oss-20b، سے بنائی گئی تھی۔ معلوم جوابات والے سوالات پر سیکھی گئی ایک تصحیح نے ماڈلز کا مجموعی تعصب ختم کر دیا، مگر سوال بہ سوال غلطی نہیں۔
مصنفین حدود پر زور دیتے ہیں: معتدل حجم کے کھلے ماڈلز، ان کے “سوچنے” (thinking) کے موڈز کے بغیر، انہی بینچ مارکس اور ہدایات (prompts) پر؛ صفِ اول (frontier) اور استدلالی (reasoning) ماڈلز کی جانچ نہیں کی گئی۔ ان کا نتیجہ ڈیزائن کا ایک سبق ہے۔ مزید ایجنٹ شامل کرنا، یا مزید اختلاف، ایسی غلطی کو درست نہیں کرتا جو کسی ماڈل کی ہر نقل میں مشترک ہو۔ مصنفین تجویز کرتے ہیں کہ اس مشترک غلطی پر براہِ راست حملہ کیا جائے، مثلاً ایجنٹوں کو ہر سوال سے مخصوص معلومات دے کر — ایک ایسا راستہ جسے انہوں نے ابھی تک آزمایا نہیں۔