30のAI、ひとつの間違い
群衆の知恵——論文によれば、その考え方は1907年のゴルトン(Galton)にさかのぼる——とは、多くの独立した推測を平均すれば誤差が打ち消し合う、というものだ。誤差に偏りがなく独立していれば、平均の誤差は推測の数の平方根に反比例して小さくなる。複数のAI言語モデルを組み合わせる多くのシステム——サンプリングと投票、議論、異なるモデルの委員会など——は、この論法に頼っている。チームを大きくすれば、より優れたエージェントの代わりになる、というわけだ。
リュブリャナのヨジェフ・ステファン研究所のCarolina FortunaとBlaž Bertalaničは、この論法はその前提と同じ程度にしか信頼できないと指摘し、前提そのものを検証しようとした。
試験台としてのフェルミ推定
フェルミ推定の問題は、容器にいくつの物が入るかといった、見積もるしかない量を尋ねる。答えは何桁にもわたる数なので、誤差は桁数で測ることができる——10倍のずれが1と数えられる——し、符号が逆の誤差は本当に打ち消し合いうる。
研究チームは、30億〜720億パラメータの15の重み公開モデル(open-weight models)から、realFPベンチマークの529問に対する251万個の答えを集め、ほかの2つの問題セットで結果を確かめた。各モデルは各問題に約350回答え、2〜30個の答えからなるチームが対数スケールで平均された。
単独では、モデルはこのゲームが苦手だ。1つの答えが正しい桁に収まるのは問題の12〜34%で、30〜63%では100倍以上ずれる。
どのコピーも共有する誤差
鍵となる段階は、各答えの誤差を2つの部分に分けることだ。一つは、モデルが特定の問題で犯す間違いで、その問題へのすべての答えに共有される。もう一つは、答えごとに変わるランダムな部分だ。答えを平均したときに打ち消し合えるのは、後者だけである。
結果として、前者が支配的だった。realFPでは、それが誤差の分散の中央値0.906を占める。問題が決まれば、同じチームの2つの答えは、独立したサンプリングが意味するとおり無相関だ。だが、同じ間違いを共有している。
論文はこれを、キッシュ(Kish)の計画効果(design effect)として知られる古典的な公式で一つの数にまとめる。N個の答えからなるチームの独立な答えの実効的な数は N / (1 + (N − 1)ρ) で、ρはその共有される割合だ。ρ = 0.906のとき、30個のチームは独立したエージェント1.10個分の価値しかない。
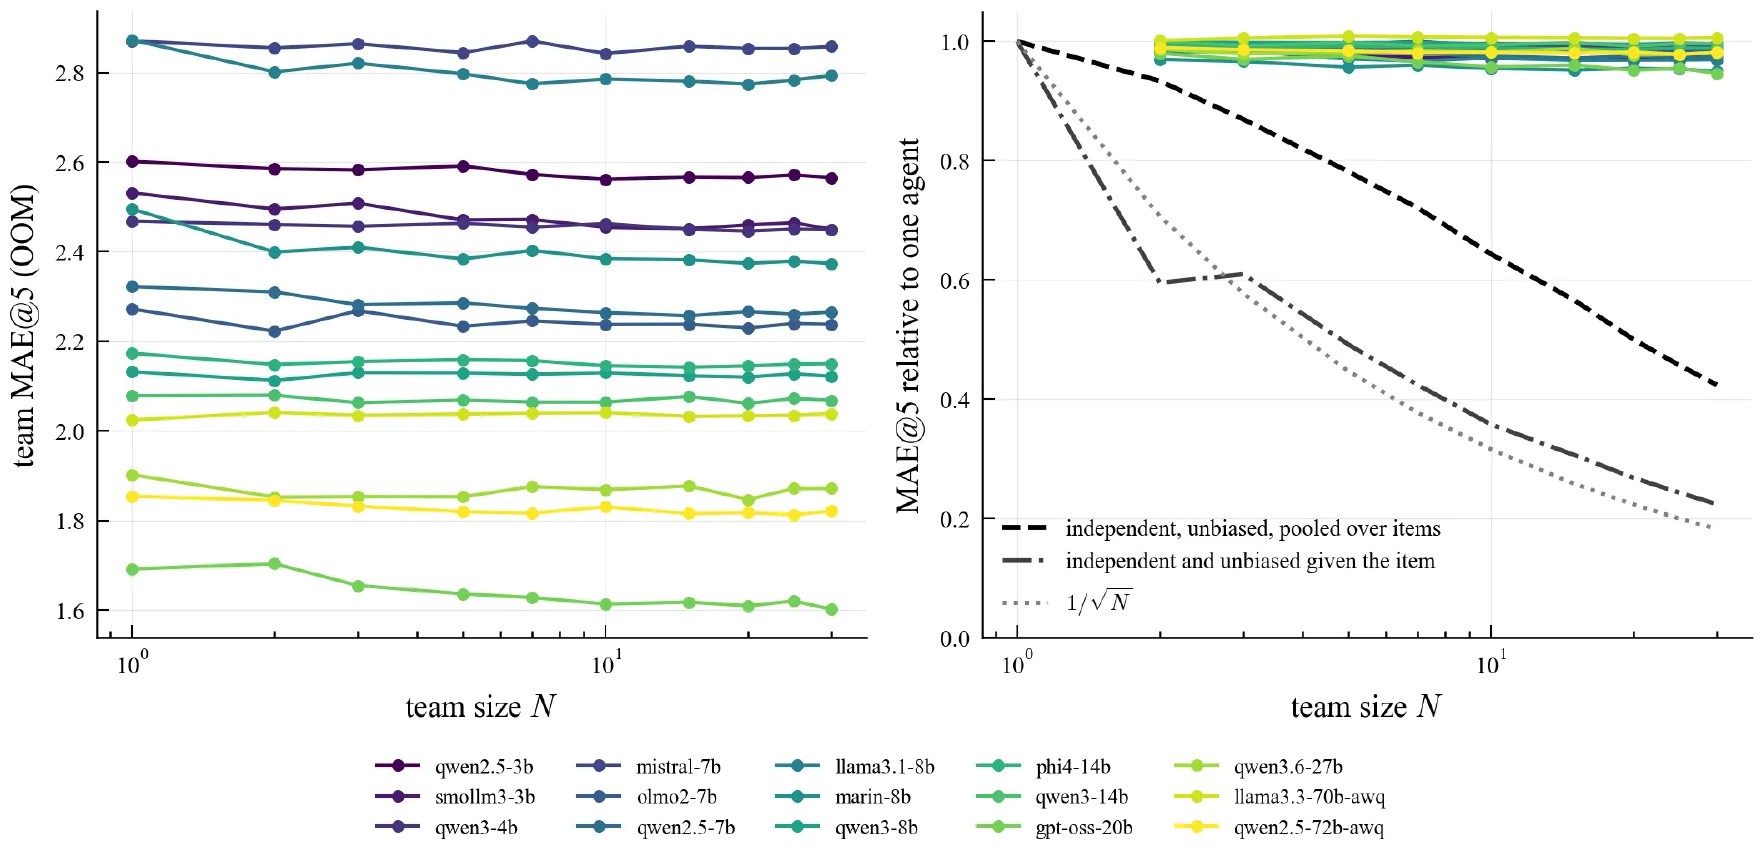
左:15のモデルについて、チームの誤差をチームの大きさNに対して示したもの。右:同じものを単一のエージェントとの比で示し(色付きの線、1の近く)、独立で偏りのない答えなら得られる値(黒の破線と一点鎖線)と、1/√Nの割合(点線)と比べたもの。— 図2、Fortuna & Bertalanič (2026), arXiv:2611.16315.
実際には、30個のチームは単一のエージェントの誤差を中央値で1.7%、最大でも5.4%しか減らさなかった。独立していて、各問題で共有された間違いももたない答えなら、誤差は74〜79%減っていたはずだ。
すべては100万へと引き寄せられる
共有される間違いの一部には、見分けのつく形がある。どのモデルも小さな量を過大に、大きな量を過小に見積もり、推定値を約100万(10⁶)のほうへ圧縮しているのだ。この傾向は15のモデルすべてに現れるが、共有される誤差の中央値17%しか説明しない。モデルたちはまた、同じ問題で同じ方向に間違える。極端な場合をならし、100万への引き寄せを取り除いても、2つの異なるモデルの問題ごとの誤差は、なお0.60〜0.69の相関をもつ。
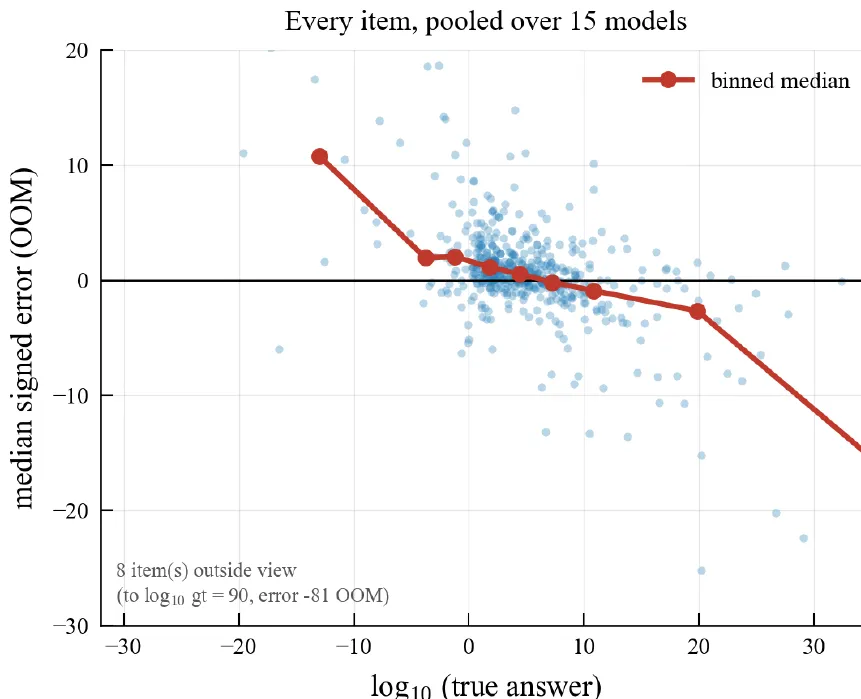
各問題に対する15のモデルの誤差の中央値を、真の答え(10のべき乗)に対して示したもの。小さな量は過大に、大きな量は過小に見積もられている。— 図1 (左)、Fortuna & Bertalanič (2026), arXiv:2611.16315.
話し合っても役に立たない
エージェント同士が議論したらどうなるか。3ラウンドの議論で、各エージェントはチームメイトの答えを見て修正した。5個のチーム内のばらつきは93%縮まった。3ラウンド目には、15のモデルのうち12で、少なくとも半分の問題において、5個のエージェントのうち3個が同じ数を答えた。だが共有される間違いは動かず、全体の改善は2.1%で、計算コストは15倍だった。仲間の答えを見ずに自分の答えを修正しただけのエージェントも、少なくとも同じくらいの成績だった。
少しだけ役に立ったもの
サンプリングの温度を上げると答えは多様になったが、チームの改善は約1%を超えなかった。異なるモデルを混ぜるほうが効果があった。精度が同程度の5つのモデルは、それぞれのチームより一緒にしたほうが6.6%良かった。それでも、15のモデルのどんな組み合わせも、最も精度の高い単一のモデル、gpt-oss-20bでつくったチームを有意に上回ることはなかった。答えがわかっている問題で学習した補正は、モデル全体の偏りを取り除いたが、問題ごとの間違いは取り除けなかった。
著者らは限界を強調している。対象は中程度の大きさの公開モデルで、「思考」モードは使っておらず、これらのベンチマークとプロンプトに限られる。最先端のモデルや推論モデルは試されていない。結論は設計上の教訓だ。エージェントを増やしても、意見の相違を増やしても、モデルのすべてのコピーが共有する間違いは直らない。著者らは、その共有される誤差に直接取り組むことを提案している。たとえば、各問題に固有の情報をエージェントに与えることだ。これは、まだ試されていない道である。