DREISSIG KIs, EIN FEHLER
Die Weisheit der Vielen, eine Idee, die die Arbeit bis zu Galton im Jahr 1907 zurückverfolgt, besagt: Mittelt man viele unabhängige Schätzungen, heben sich die Fehler auf. Sind die Fehler unverzerrt und unabhängig, schrumpft der Fehler des Mittelwerts wie eins durch die Quadratwurzel der Anzahl der Schätzungen. Viele Systeme, die mehrere KI-Sprachmodelle kombinieren – durch Sampling und Abstimmung, durch Debatte oder durch Gremien verschiedener Modelle –, stützen sich auf dieses Argument: Ein größeres Team könne einen besseren Agenten ersetzen.
Carolina Fortuna und Blaž Bertalanič vom Jožef-Stefan-Institut in Ljubljana weisen darauf hin, dass das Argument nur so gut ist wie seine Voraussetzungen, und haben sich daran gemacht, diese zu prüfen.
Fermi-Fragen als Prüfstand
Fermi-Fragen verlangen nach Größen, die sich nur schätzen lassen, etwa wie viele Gegenstände in einen Behälter passen. Ihre Antworten sind Zahlen, die viele Größenordnungen umspannen; deshalb lässt sich ein Fehler in Größenordnungen messen – ein Faktor zehn zählt als eine –, und Fehler mit entgegengesetztem Vorzeichen können sich tatsächlich aufheben.
Das Team sammelte 2,51 Millionen Antworten von 15 Modellen mit offenen Gewichten (open-weight models), mit 3 bis 72 Milliarden Parametern, auf die 529 Fragen des Benchmarks realFP und überprüfte die Ergebnisse an zwei weiteren Fragensätzen. Jedes Modell beantwortete jede Frage etwa 350-mal, und Teams aus 2 bis 30 Antworten wurden auf logarithmischer Skala gemittelt.
Für sich allein schneiden die Modelle bei diesem Spiel schlecht ab. Eine einzelne Antwort trifft bei 12 bis 34 % der Fragen die richtige Größenordnung und liegt bei 30 bis 63 % um mehr als einen Faktor hundert daneben.
Der Fehler, den jede Kopie teilt
Der entscheidende Schritt besteht darin, den Fehler jeder Antwort in zwei Teile zu zerlegen. Der eine ist der Fehler, den ein Modell bei einer bestimmten Frage macht und den alle seine Antworten darauf teilen. Der andere ist der zufällige Anteil, der von einer Antwort zur nächsten schwankt. Nur der zweite kann sich aufheben, wenn man die Antworten mittelt.
Es zeigt sich, dass der erste Teil überwiegt. Bei realFP macht er im Median 0,906 der Fehlervarianz aus. Bei gegebener Frage sind zwei Antworten desselben Teams unkorreliert, wie es unabhängiges Ziehen erwarten lässt; aber sie teilen denselben Fehler.
Die Arbeit fasst dies in einer einzigen Zahl zusammen, mit einer klassischen Formel, dem Designeffekt nach Kish (design effect): Die effektive Zahl unabhängiger Antworten in einem Team aus N ist N / (1 + (N − 1)ρ), wobei ρ dieser gemeinsame Anteil ist. Mit ρ = 0,906 ist ein Team aus dreißig so viel wert wie 1,10 unabhängige Agenten.
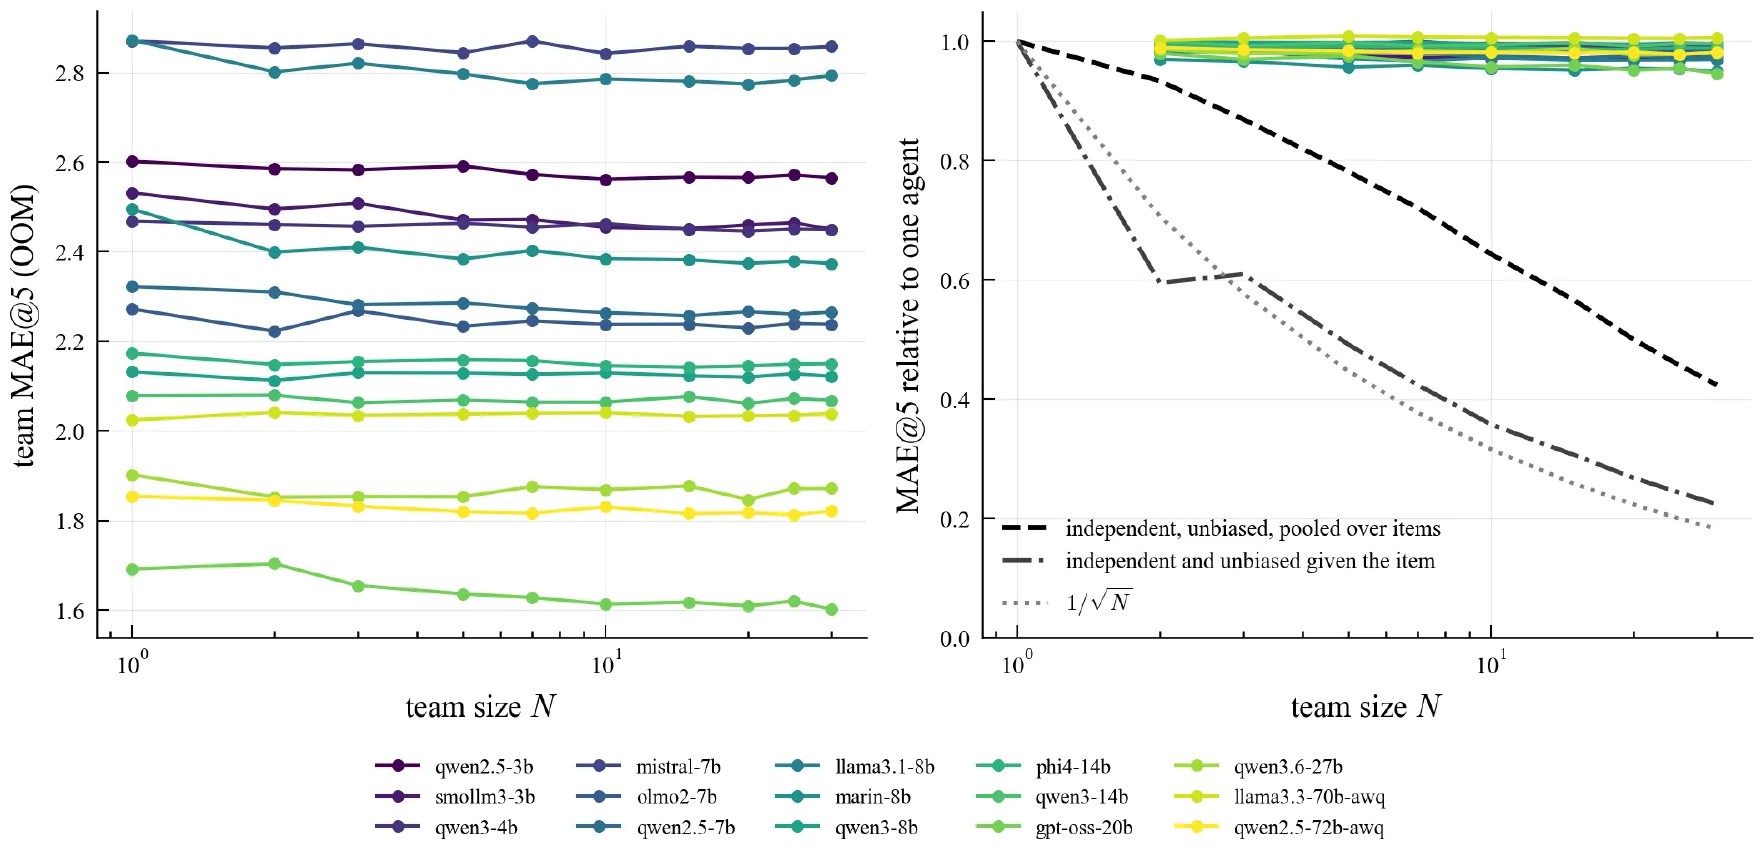
Links: Teamfehler in Abhängigkeit von der Teamgröße N für 15 Modelle. Rechts: dasselbe relativ zu einem einzelnen Agenten (farbige Linien, nahe 1), verglichen mit dem, was unabhängige und unverzerrte Antworten ergäben (schwarze gestrichelte und strichpunktierte Linien), und mit der Rate 1/√N (gepunktet). — Abbildung 2, Fortuna & Bertalanič (2026), arXiv:2611.16315.
In der Praxis verringerten Teams aus dreißig den Fehler eines einzelnen Agenten im Median um 1,7 % und höchstens um 5,4 %. Unabhängige Antworten, die zudem bei jeder Frage keinen gemeinsamen Fehler getragen hätten, hätten ihn um 74 bis 79 % gesenkt.
Alles driftet in Richtung einer Million
Ein Teil des gemeinsamen Fehlers hat eine erkennbare Form. Jedes Modell überschätzt kleine Größen und unterschätzt große und staucht seine Schätzungen in Richtung von etwa einer Million (10⁶) zusammen. Dieser Trend zeigt sich bei allen 15 Modellen, erklärt aber im Median nur 17 % des gemeinsamen Fehlers. Die Modelle irren sich auch bei denselben Fragen in dieselbe Richtung: Die Fehler zweier verschiedener Modelle pro Frage korrelieren noch immer mit 0,60 bis 0,69, sobald Extremfälle gezähmt sind und die Drift in Richtung einer Million herausgerechnet ist.
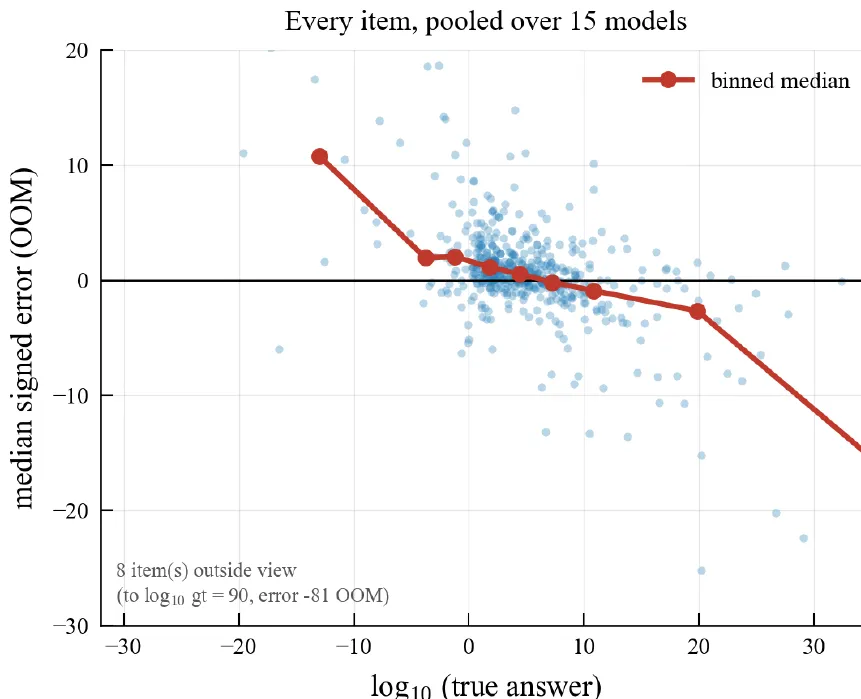
Medianfehler der 15 Modelle bei jeder Frage, aufgetragen gegen die richtige Antwort (Zehnerpotenzen): Kleine Größen werden überschätzt, große unterschätzt. — Abbildung 1 (links), Fortuna & Bertalanič (2026), arXiv:2611.16315.
Darüber reden hilft nicht
Was, wenn die Agenten diskutieren? In drei Debattenrunden sah jeder Agent die Antworten seiner Teammitglieder und überarbeitete seine eigene. Die Streuung innerhalb von Fünferteams brach um 93 % ein – bis zur dritten Runde gaben bei 12 der 15 Modelle drei von fünf Agenten bei mindestens der Hälfte der Fragen dieselbe Zahl an. Doch der gemeinsame Fehler bewegte sich nicht, und der Gesamtgewinn betrug 2,1 %, bei fünfzehnfachem Rechenaufwand. Agenten, die einfach ihre eigene Antwort überarbeiteten, ohne die der anderen zu sehen, schnitten mindestens ebenso gut ab.
Was ein wenig half
Eine höhere Sampling-Temperatur machte die Antworten vielfältiger, ohne die Teams um mehr als etwa 1 % zu verbessern. Verschiedene Modelle zu mischen half mehr: Fünf Modelle ähnlicher Genauigkeit schnitten zusammen um 6,6 % besser ab als in ihren eigenen Teams. Doch keine Mischung der 15 Modelle war signifikant besser als ein Team aus dem einzelnen genauesten Modell, gpt-oss-20b. Eine an Fragen mit bekannten Antworten erlernte Korrektur beseitigte die allgemeine Verzerrung der Modelle, nicht aber den Fehler Frage für Frage.
Die Autoren betonen die Grenzen: offene Modelle bescheidener Größe, ohne ihre „Denkmodi“ (thinking), auf diesen Benchmarks und mit diesen Prompts; Spitzenmodelle und Reasoning-Modelle wurden nicht getestet. Ihr Fazit ist eine Lehre für die Konstruktion solcher Systeme. Mehr Agenten oder mehr Uneinigkeit beheben keinen Fehler, den jede Kopie eines Modells teilt. Die Autoren schlagen vor, diesen gemeinsamen Fehler direkt anzugehen, etwa indem man den Agenten Informationen gibt, die für jede Frage spezifisch sind – ein Weg, den sie noch nicht getestet haben.